2026-10-02Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bu sayı, yapay zeka ve robotiğin olgunluk sınavından geçtiği bir dönemi belgiliyor: sistemler artık yalnızca dar görevlerde değil, uzun ufuklu bellekte, çok modlu uzamsal algıda ve sıfır yeniden eğitimle yeni becerilere uyum sağlamada sınandı. Donanımdan değerlendirme altyapısına, dünya modellerinden 3D temsilcilere uzanan bu çeşitlilik tesadüf değil; alanın artık bütünleşik sistemler inşa etme olgunluğuna eriştiğinin işareti. Makaleleri bir arada okumak, her birinin ayrı ayrı sunduğundan fazlasını ortaya koyuyor: gerçek dünya kısıtlarıyla yüzleşen bir araştırma ekosisteminin bütünsel portresini.
1.Araç
Çok Dilli TTS için Açık Değerlendirme Panosu Yayında
Open TTS Leaderboard, ses klonlama ve çok dilli modelleri objektif metriklerle ölçeklenebilir biçimde sıralıyor.
Hugging Face, açık kaynaklı ve çok dilli metinden sese (TTS) modellerini standart metriklerle değerlendiren Open TTS Leaderboard'u duyurdu. Hugging Face Hub'da 8.000'den fazla TTS modeli bulunmasına karşın mevcut değerlendirme yöntemleri büyük ölçüde arena tabanlı insan oylamalarıyla sınırlı kalıyor; bu yaklaşım hem yavaş hem de tutarsız sonuçlar üretiyor, üstelik açık ağırlıklı modellerin yalnızca yüzde 17'sini kapsıyor. Yeni liderlik tablosu bu sorunu üç objektif metrik grubuyla aşıyor: anlaşılırlık için Qwen3 ASR tabanlı kelime ve karakter hata oranları (WER/CER), hız için gerçek zamanlı faktör (RTFx) ve zaman-ilk-ses (TTFA) ölçümleri, ses klonlama kalitesi için ise WavLM konuşmacı gömüleri arasındaki kosinüs benzerliği. Bu otomatik pipeline sayesinde bir modelin değerlendirme süresi haftalardan birkaç saate iniyor. Leaderboard aynı zamanda çok dilli destek sunuyor; bu da yalnızca İngilizce merkezli sistemlerin değil, küresel TTS ekosisteminin adil biçimde karşılaştırılmasına olanak tanıyor. Açık kaynak geliştiricileri artık modellerini tutarlı bir referans çerçevesinde konumlandırabilecek ve iyileştirme alanlarını somut verilerle belirleyebilecek. Özellikle ticari API'larla rekabet eden açık ağırlıklı modellerin arena sıralamalarında yetersiz temsil edildiği göz önünde bulundurulduğunda, bu tablo açık kaynak topluluğu için kritik bir eşitleyici işlevi görüyor ve TTS araştırmalarında yeniden üretilebilirlik standartlarını yükseltiyor.
Memorizon: Dünya Modellerini Bağlam Penceresinin Ötesinde Eğitiyor
Memorizon, kuadratik dikkat maliyetini kıran yeni mimarisiyle video dünya modellerini çok daha uzun zaman dilimlerinde eğitiyor.
MBZUAI-IFM'den araştırmacılar, akış tabanlı dünya modellerini bağlam penceresinin çok ötesindeki zaman aralıklarında eğitmeyi mümkün kılan Memorizon mimarisini önerdi. Temel sorun şu: bir modelin aynı konuma yinelenen ziyaretlerde tutarlı görüntüler üretmesi için eğitim örneklerinin her iki ziyareti de kapsaması gerekiyor; bu durum dakikalar süren sekanslar ve buna bağlı kuadratik dikkat maliyeti anlamına geliyor. Memorizon bu sıkı bağlantıyı koparıyor: uzun zaman aralıkları yalnızca denetim sinyali için gerekli, dikkat hesaplaması için değil. Mimarinin işleyişi şöyle: her puanlanan video parçası, kamera ortak-görünürlük kriterlerine göre bellek bankasından kendi en iyi-K gizli temsilini seçiyor. Birleşik bellek bankası boyutu kK ile sınırlı kalıyor ve sekans uzunluğundan bağımsız sabit bir değerde seyrediyor; bu da bellek maliyetini doğrusal düzeyde tutuyor. Sonuçlar somut: 100 saniyelik eğitim penceresinden 400 saniyeliğe geçmek adım süresine yalnızca yüzde 12 ek yük bindirirken, yineleme tutarlılığı kayan-pencere tabanına kıyasla yüzde 24-30 artıyor. Bu çalışma, uzun-ufuk video üretimi, açık dünya gezginleri ve robotik dünya modelleri gibi alanlarda ölçeklenebilir eğitimin önündeki kritik bir hesaplama engelini ortadan kaldırıyor ve uzun vadeli tutarlılık gerektiren üretken sistemlere yeni bir yol açıyor.
STATERA: Tek Kameralı Videodan Gizli Kütle Merkezini Buluyor
STATERA, sıfır-atışlı sim-to-real aktarımıyla opak nesnelerin gizli kütle merkezini kısa monoküler videolardan tahmin ediyor.
STATERA, donmuş ağırlıklara sahip bir video omurgasını (V-JEPA) hafif bir temporal tubelet karıştırıcıyla uyarlayarak opak ve asimetrik katı cisimlerin kütle merkezini (CoM) kısa monoküler videolardan tahmin eden yeni bir yaklaşım sunuyor. Yüzey ipuçlarının ve nokta takibinin öz-kapanma nedeniyle güvenilmez olduğu bu zorlu görev için araştırmacılar, değerlendirmeyi standartlaştırmak amacıyla HiddenMass Benchmark'ı da yayımladı; bu benchmark 50.000 MuJoCo yörüngesi ile fiziksel olarak kalibre edilmiş 63 gerçek dünya sekansından oluşuyor. Simülasyon sonuçları oldukça çarpıcı: normalleştirilmiş CoM hatası DINOv2 tabanına göre yüzde 41,7'den yüzde 25,2'ye düşüyor. Sıfır-atışlı sim-to-real aktarımında ise araştırmacılar temel bir ikilemle karşılaşıyor. Faz-duyarlı hedefler çift modlu tahminlere yol açarken faz-agnostik hedefler daha güvenilir, istatistiksel olarak kararlı merkezlere çöküyor. Bu bulgulara karşın çalışma, donmuş temporal temsillerin atalet dinamiklerini salt görsel geometriden ayırt edebildiğini açıkça ortaya koyuyor. Söz konusu bulgu; robotik manipülasyon, nesne yakalama planlaması ve fiziksel sahne anlamlandırma gibi alanlarda görüntü tabanlı gizli parametre tahminine yönelik yeni ve umut verici bir araştırma yolu açıyor. Büyük ölçekli yeniden eğitim gerektirmeden çalışması ise yöntemi pratik uygulamalar için özellikle cazip kılıyor.
DSSR-3D: 3D Gaussian'larda Bakış Açısına Bağlı Segmentasyon
DSSR-3D, 3D Gaussian Splatting'de 'solumda' gibi izleyici merkezli uzamsal ilişkileri eğitimsiz çıkarımla ilk kez çözüyor.
DSSR-3D, 3D Gaussian Splatting tabanlı açık-sözlük segmentasyonun çözemediği izleyici merkezli uzamsal ilişkileri ele alan yeni bir çerçeve sunuyor. "Solumda duran nesne" veya "arkamdaki kutu" gibi ifadeler, bakış açısına doğrudan bağlı olduğundan mevcut yöntemler bu referansları doğru çözümleyemiyor. Sorunun kökü şurada: mevcut yaklaşımlar dil özelliklerini küresel ve bakış açısından bağımsız bir uzayda kodluyor; bu durum onları poz-duyarlı referans görevlerinde temelden yetersiz kılıyor. DSSR-3D ise görevi iki ayrı arayüze bölerek bu kısıtlamayı aşıyor: poz-bağımsız semantik yerelleştirme ve poz-koşullu uzamsal çıkarım. İki bileşen, sıcaklık-keskinleştirilmiş softmax ve projeksiyon tabanlı yönlü puanlama fonksiyonuyla somutlaştırılıp hafif, eğitimsiz bir adımda birleştiriliyor. Kamera pozunu girdi olarak alan bu tasarım, herhangi ek eğitim verisi veya fine-tuning gerektirmiyor. Araştırmacılar ayrıca bu senaryoları sistematik biçimde değerlendirmek için ViewRef-GS adlı yeni bir benchmark da öneriyor. Yöntem, mevcut 3DGS tabanlı referans yöntemlerini temel semantik alanın ötesinde ek eğitim gerektirmeksizin tutarlı biçimde geride bırakıyor. Bu ilerleme, robot navigasyonu, artırılmış gerçeklik arayüzleri ve dil güdümlü 3D sahne etkileşim sistemleri için somut bir adım niteliği taşıyor.
InterEvolve: İnsansı Robot Yeniden Eğitim Olmadan Yeni Görev Öğreniyor
InterEvolve, LLM'lerin ödül programlarını evrimleştirmesiyle insansı robotun sıfırdan eğitim almadan yeni loko-manipülasyon görevlerini çözmesini sağlıyor.
Illinois Üniversitesi araştırmacıları, insansı robotlar için test-zamanı evrimini inceleyen InterEvolve çerçevesini sundu. Temel fikir şu: geniş kapsamlı eğitilmiş bir kontrolcü, yeni görevler için gereken yetkinliğin büyük bölümünü zaten barındırıyor; asıl mesele bu yetkinliğe yeniden eğitim yapmadan nasıl erişileceği. InterEvolve bunu iki temel bileşenle çözüyor. Birincisi, nesne artıkları aracılığıyla yeni ödülleri lokomotor-manipülasyon davranışına dönüştüren nesne-duyarlı ileri-geri (FB) davranışsal temel modeli. İkincisi, görevlerin tamamlanma koşulları ve ayarlanabilir sabitler içeren aşamalı ödül programları olarak tanımlandığı bir yapı; bir LLM ajanı bu programı yürütme geri bildirimleri ve doğrulanmış beceri kütüphanesine dayanarak sürekli revize ediyor, eş zamanlı olarak sayısal bir optimizer ise program sabitlerini ince ayarlıyor. Her aday, paralel simülasyonlarda doğrulandıktan sonra kontrolcünün mevcut motor yetkinliğini yeni görev gereksinimlerine göre yeniden düzenliyor. Sistem, bu döngüsel güncelleme süreciyle hem görev tanımını hem de uygulama parametrelerini aynı anda optimize ediyor. Bu yaklaşım, insansı robotların pahalı yeniden eğitim döngüleri olmadan görev repertuvarını hızla genişletebileceğini somut verilerle gösteriyor ve robotik sistemlerin yeni ortamlara adaptasyonu için umut verici bir yol haritası çiziyor.
Boston Dynamics Atlas'ın Yeni Eli Serçe Parmaksız Tasarlandı
Boston Dynamics, dört parmaklı yeni Atlas elinin mühendislik gerekçelerini açıkladı: sadelik, güvenilirlik ve sim-to-real uyumu.
Boston Dynamics, Atlas insansı robotu için 13 serbestlik dereceli, dört parmaklı yeni elini tanıttı. Tasarım kararlarının en dikkat çekeni beşinci parmağın dışarıda bırakılması: mühendisler, serçe parmağın sağlayacağı ek beceriklilik kazanımının üç ekstra serbestlik derecesinin getirdiği karmaşıklık, boyut ve güç tüketimi maliyetlerine değmediğine karar verdi. Bu kararı ampirik olarak sınamak için ekip tam bir gün boyunca serçe ve yüzük parmaklarını birbirine bantlayarak hangi görevleri gerçekleştiremediklerini sistematik biçimde gözlemledi; sonuç tasarımı haklı çıkardı. Yeni el, doğrudan aktüasyon ve tamamen kapsüllenmiş tasarımıyla yüksek doğruluklu simülasyon ve sim-to-real pekiştirmeli öğrenme için özel olarak optimize edildi; tüm eklemler aynı tip tek bir aktüatör kullanıyor, bu da bakım ve kalibrasyon süreçlerini önemli ölçüde basitleştiriyor. El; hassas çimdik ve tripodal kavrama, başparmağın tüm parmaklar boyunca akıcı biçimde kayması ve matkap, taşlama makinesi, çivi tabancası gibi tetiklemeli endüstriyel aletleri tutma kapasitesine sahip. Bu gelişme, Boston Dynamics'in Atlas'ı Hyundai otomotiv fabrikalarında fiilen konuşlandırma hedefiyle doğrudan örtüşüyor ve insansı robotların gerçek üretim ortamlarında pratik kullanımına giden yolda somut bir adım teşkil ediyor.
Vision Transformer'larda Nesne Bağlama Uzamsal Olarak Yerel
Önceden eğitilmiş ViT'lerde nesne bağlamanın yerellik gösterdiği ve iki yama arasındaki mesafeyle üstel düştüğü kanıtlandı.
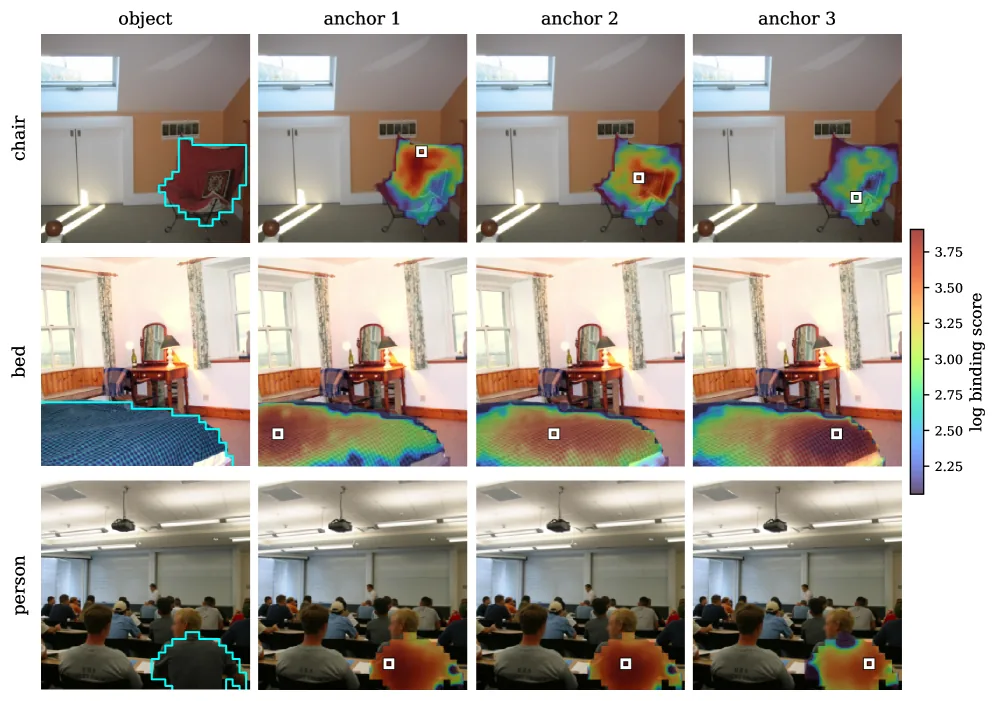
Önceden eğitilmiş ViT'lerde nesne bağlama uzamsal olarak yereldir; çapa yamadan uzaklaştıkça bağlama skoru düşer ve çapa hareket ettiğinde yüksek skor bölgesi onu takip eder. Görsel: Singal, arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Yeni bir çalışma, önceden eğitilmiş Vision Transformer'ların (ViT) iki görüntü yamasının aynı nesneye ait olup olmadığını kodladığını gösteriyor; ancak araştırmanın asıl katkısı bu IsSameObject sinyalinin iç yapısını derinlemesine sorgulamasında yatıyor. Araştırmacılar, bağlamanın yerel bir özellik taşıdığını ortaya koydu: aynı nesneye ait iki yamanın bağlı olarak çözümlenme olasılığı, yamalar arasındaki mesafeyle monoton biçimde düşüyor ve sonunda sıfır olmayan bir tabana oturuyor. Bu bozunma, sonlu bir uzunluk ölçeğiyle üstel bir eğriyle iyi tanımlanabiliyor. Kritik olan şu ki bu örüntü, nesne boyutlarından, üç farklı prob ailesinden, ADE20K ve COCO veri kümelerinden ve hem DINO hem de CLIP omurgalarından bağımsız olarak tutarlı biçimde gözlemleniyor. Bulgular pratik açıdan da son derece önemli: büyük nesnelerde bağlama mekanizması belirgin biçimde zayıflıyor; aynı semantik sınıftaki farklı nesneler, farklı sınıftakilere kıyasla çok daha zor birbirinden ayrıştırılıyor; nesne parçaları ise tutarsız bir şekilde bütünleriyle gruplandırılıyor. Tüm bu sonuçlar, temel görü modellerinin nesne bağlama kapasitesini değerlendirmek için toplu doğruluk skorlarının yetersiz kaldığını açıkça ortaya koyuyor ve segmentasyon ile nesne temsili araştırmaları için daha nüanslı değerlendirme protokollerine ihtiyaç duyulduğuna güçlü bir şekilde işaret ediyor.
LLM'ler Kombinatoriyel Optimizasyon için Tamamlayıcı Sezgisel Kurallar Keşfediyor
LACE çerçevesi, LLM'leri kullanarak 36 klasik optimizasyon probleminde mevcut en iyi yöntemi geride bırakan algoritmalar tasarlıyor.
Nature Machine Intelligence'da yayımlanan çalışmada Huatian Gong ve ekibi, büyük dil modellerini kombinatoriyel optimizasyon (KO) algoritması tasarımı için kullanan LACE (LLM-Driven Algorithm Construction via Complementary Evolution) çerçevesini tanıttı. Doğrudan LLM sorgulama, yeni KO problemlerinde sıklıkla başarısız oluyor çünkü modeller problem yapısına dair yeterli bağlamdan yoksun kalıyor. LACE bu sorunu sistematik bir arayüzle aşıyor: girdi-çıktı şeması, araç kütüphanesi ve sezgisel portföy. Bu yapı sayesinde model, problem özgü uygulama ayrıntılarına değil üst düzey algoritmik akıl yürütmeye odaklanıyor. Zaman kısıtlı tamamlayıcı evrim ise heterojen örnekleri çözebilen uzman sezgiseller üretiyor ve portföyü çeşitlendiriyor. CO-Bench üzerindeki 36 klasik problem, yöntemin gücünü net biçimde ortaya koyuyor: LACE 0,945 ortalama skora ulaşırken en güçlü rakip LLM tabanlı yöntem 0,870'te kalıyor. Yapısal olarak yeni dört problemde ise fark çok daha çarpıcı: LACE 0,97-0,99 aralığını yakalarken beş rakip yöntem uygulanabilir bir algoritma bile üretemiyor. Bu sonuçlar, algoritma keşfinin önemli ölçüde otomatize edilebildiğini somut olarak kanıtlıyor ve üretim planlaması, lojistik, sağlık gibi karar-yoğun alanlarda karmaşık optimizasyon sorunlarına LLM'lerin sistematik biçimde uygulanabileceğini gösteriyor.