2026-10-05Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayının ortak ipliği şu: yapay zekada ilerleme artık model boyutundan çok, modelin neyle beslendiği, nasıl ölçüldüğü ve dünyayı nasıl algıladığıyla belirleniyor. Simülasyonla üretilen eğitim verisinden dokunsal sensörlere, Türkçe karar kıyaslamalarından alan kayması altında açıklanabilirlik denetimine kadar her çalışma bu üç soruya dokunuyor. Birlikte okunduğunda, veri, değerlendirme ve algı katmanlarının birbirini nasıl şekillendirdiği görünür hale geliyor.
1.Araştırma
Robot eğitimi için ajan tabanlı simülasyon dünyası üretimi
Awomo-SimDataEngine, fiziksel olarak geçerli sahneleri robot demonstrasyonlarına dönüştürüyor.
Awomo-SimDataEngine, robot eğitimi için yalnızca görsel olarak inandırıcı değil, etkileşime elverişli ve fiziksel olarak tutarlı simülasyon dünyaları üreten ajan tabanlı bir sistem. Sistemin ortak varlık servisleri hem katı hem de eklemli nesneler üretiyor; eklemli nesnelerde ISArt, parçaları ve eklemleri nesnenin yapısına dayanarak oluşturuyor. Sahne üretimi iki yoldan ilerliyor: Unravel, görüntülerden düzenlenebilir sahneler yeniden kurarken SimForge, metinden tek ve çok odalı ortamlar inşa ediyor. Graf tabanlı bir yapı; kurulum, doğrulama ve sınırlı onarım adımlarını koordine ediyor. Hata oluştuğunda sorunu sorumlu modüle yönlendiriyor ve etkilenmeyen sahne durumunu koruyor; böylece tüm üretimi baştan başlatmak gerekmiyor. PolicyForge ise doğrulanmış dünyaları görev ve robot gövdeleriyle eşleyerek tekrar oynatılabilir demonstrasyonlar üretiyor. MuJoCo tabanlı LIBERO-Plus'ta Isaac Sim demonstrasyonlarıyla birlikte eğitim, bir World-Action Model'in genel başarı oranını %77,17'den %89,43'e çıkardı. Hedef ve uzamsal görevlerde artış sırasıyla 31,66 ve 6,25 puan oldu. Bulgular, üretilen verinin simülatörler arası politika eğitiminde gerçekten işe yaradığını gösteriyor. Uzun ufuklu görevlerdeki kazanç ise daha sınırlı kaldı; bu durum, planlama derinliği gerektiren senaryoların hâlâ açık bir sorun olduğuna işaret ediyor. Yine de yaklaşım, simülasyon verisini elle hazırlamanın maliyetini düşürme potansiyeli taşıyor.
CC BY 4.0 lisanslı HakemBench, Türkçe modelleri yedi alanda karar kalitesi ve kalibrasyonla ölçüyor.
HakemBench, test edilen modelin bir metni, bir soruyu ve sabit bir seçenek kümesini okuyup her seçenek için olasılık döndürdüğü Türkçe bir kıyaslama. 1.0 sürümü CC BY 4.0 lisansıyla tamamen açık; doğrulama, eğitim, güvenlik bariyerleri, hukuki yönlendirme, moderasyon, spam ve oltalama ile müşteri desteği dahil yedi izde 2.346 örnek ve 4.275 soru içeriyor. Tek bir değerlendirme düzeneği karar kalitesini (makro F1), kalibrasyonu (normalleştirilmiş Brier skoru) ve seçici otomasyonu (normalleştirilmiş genelleştirilmiş risk-kapsam eğrisi altındaki alan) ölçüp geometrik ortalamayla birleştiriyor; sonuçlar 2.000 bootstrap çekimiyle güven aralığıyla raporlanıyor. Seçenek sırası, yeniden ifade, İngilizce çeviri ve isim değişimi sınamaları da ayrıca veriliyor. Etiketlerin çoğu iki adımda üretilmiş: önce tek bir yapay zeka model ailesi örnekleri kör biçimde etiketlemiş, ardından bu etiketler farklı ailelerden büyük dil modellerinden oluşan bir panelin oylarıyla karşılaştırılmış. İnsan doğrulaması yok. 16 satırlık tabloda lider 0,888 bileşik skor alırken, laboratuvarın kendi modeli 0,660 ile yedinci sırada; ancak bu modelin eğitim verisi önceki koşuların test sonuçlarından etkilendiği için bazı izlerdeki skorları işaretlenmiş durumda. Türkçe yapay zeka için, güvenilirliği ve sınırları şeffaf biçimde belirtilmiş yerel bir ölçüm aracı sunuyor.
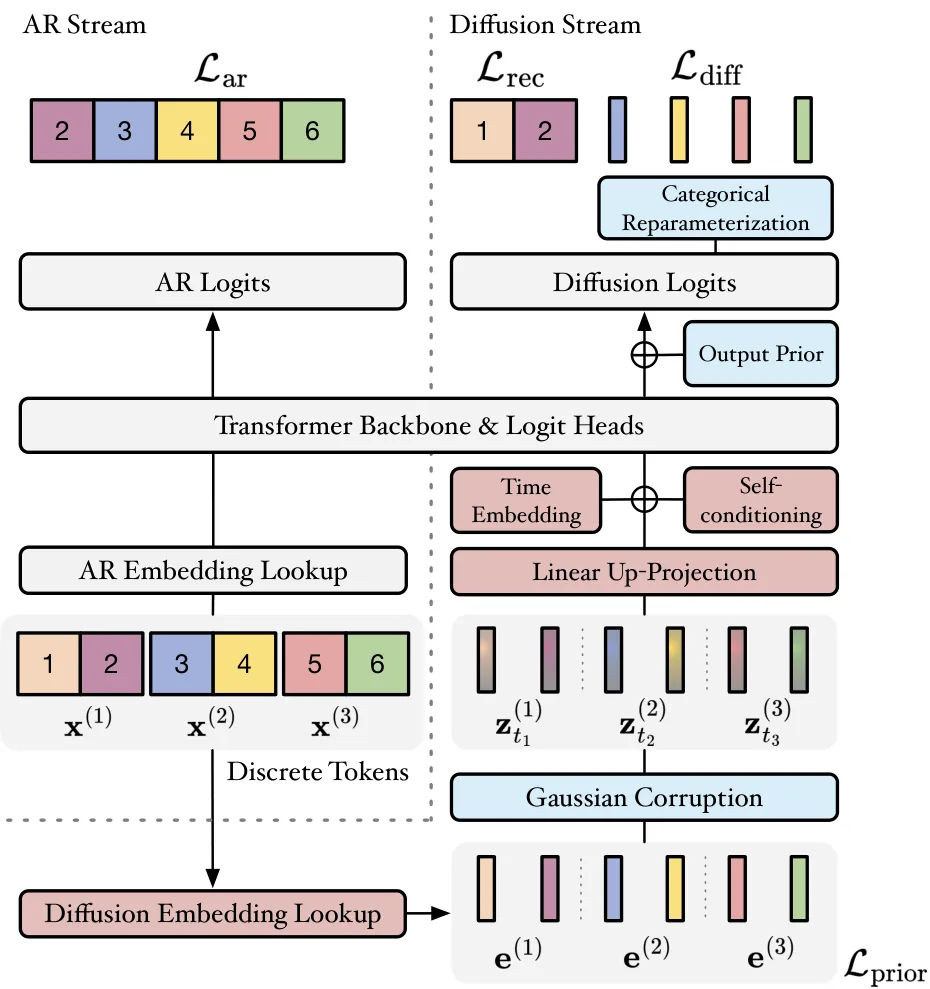
Sigma'nın eğitim süreci (a) ve L = 6 uzunluklu, blok boyutu L′ = 2 olan örnek bir dizi için transformer dikkat maskesi (b); temiz ayrık token'lar otoregresif akışa, gürültülü sürekli gömmeler ise difüzyon akışına veriliyor. Görsel: Yang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Sigma, yönlendirilebilir ve düşük boyutlu ODE/SDE latent yörüngeleri üzerine kurulu, 3B ve 8B ölçeğindeki ilk büyük sürekli difüzyon dil modeli (dLM). Ayrık dLM'ler hızlı paralel kod çözmede başarılı olsa da düzgün olmayan, yüksek boyutlu uzayları muhakeme ve çıkarım hızlandırma için yörünge yönlendirmeyi zorlaştırıyor; Sigma bu sorunu hedefliyor. Model, olabilirlik optimizasyonuyla blok blok eğitiliyor; Gauss gürültüsüyle bozulmuş token gömmelerini temizlerken en uygun gömme geometrisini de öğreniyor. Eğitimi hızlandırmak için otoregresif (AR) modellerin önceden eğitilmiş ağırlıklarından sıcak başlangıç yapılıyor. Çıkarımda sınıflandırıcısız yönlendirme ve skor sıcaklığı, yüksek doğruluklu muhakeme ve kodlama için belirleyici bulunmuş. Ön eğitim sonrası GSM8K, Minerva, HumanEval ve MBPP gibi standart kıyaslamalarda, denetimli ince ayar sonrası ise MATH-500 ve AIME gibi zorlu muhakeme görevlerinde ayrık rakiplerle yarışır performans elde edilmiş. Gömme uzayında yönlendirme kalite-çeşitlilik dengesini ayarlayabiliyor ve güçlü pass@k sonuçları veriyor; sürekli yörüngeler düşük NFE'de zarif performans düşüşü ve verimli distilasyona imkân tanıyor. Sonuçlar, sürekli dLM'leri verimli dil üretimi için umut verici bir paradigma olarak konumlandırıyor.
SoTa: Ustaca manipülasyon için yumuşak dokunsal deriler
10 doların altındaki SoTa derisi, insan ve robot eline ortak dokunsal düzen sağlıyor.
SoTa, hem insan hem robot eline tam kapsama sağlayan, düşük maliyetli kapasitif bir dokunsal deri. Görsel-dokunsal robot verisi kıt, çünkü ustaca demonstrasyonlar teleoperasyon gerektiriyor; insan demonstrasyonları çok daha ucuz ama yalnızca insan ve robot ellerinde karşılıklı dokunsal sinyaller varsa kullanılabiliyor. SoTa bunu, karşılık gelen parmak ve avuç bölgelerinde ortak 202 taksel düzenini koruyarak çözüyor. Kumaş elektrotlu çok katmanlı tasarım, deri başına 10 doların altında malzemeyle ince, yumuşak ve geometrisi özelleştirilebilir derilerin kendi imkânlarınızla üretimine izin veriyor. Sensör 10.000 yükleme-boşaltma çevriminden sonra başlangıç tepki aralığının %97'sinden fazlasını koruyor; iletken izler 1.280 sıkı yumruk katlamasından sonra da sürekli kalıyor. Ortak taksel düzeni, öğrenilmiş sensörler arası eşleme olmadan ortak bir dokunsal kodlayıcıyla insan-robot ortak eğitimini mümkün kılıyor. Üç temas yoğun görevde dokunsal gözlemler, yalnızca görüntü kullanan politikalara göre dağılım içi başarıyı artırdı. Sabit robot demonstrasyon bütçesinde insan demonstrasyonları eklemek, sekiz değerlendirme koşulunda ortalama başarıyı %22,8'den %45,9'a çıkardı ve beş dağılım dışı koşulun hepsinde iyileşme sağladı. Ekip, derilerin üretimi ve kullanımı için gereken kaynakları açık kaynak yapmayı planlıyor.
Alan kayması altında yaya tespiti için güvenilir XAI denetimi
Açıklama sadakati tespit güveniyle sıkı bağlı; kontrol edilmezse karşılaştırmalar yanıltıcı oluyor.
Akıllı araçlardaki algı modelleri için açıklanabilirlik giderek zorunlu hale geliyor, ancak açıklamaların sürüş alanı kayması altında sadık kalıp kalmadığı yeterince anlaşılmış değil. Bu çalışma, sabit bir YOLOv8s yaya tespit modelinin sonradan üretilen açıklamalarını PIE ve JAAD veri setleri arasında denetliyor; ROI tabanlı D-Deletion, dondurulmuş güven üçlükleri, sıra tabanlı testler, bootstrap aralıkları ve Holm düzeltmesi kullanılıyor. Silme tabanlı sadakatin, açıklama anındaki tespit gücüyle güçlü biçimde bağlı olduğu görülüyor: D-RISE için Spearman korelasyonları 0,70 ile 0,82 arasında. Bu da güvene göre katmanlandırılmış naif karşılaştırmaları güvenilmez kılıyor. Sabit f0 aralıkları içinde tespit gücü kontrol edildiğinde, orta f0 aralığında D-RISE sadakati alana bağımlı kalıyor; PIE, JAAD'den daha yüksek D-Deletion veriyor ve bu fark Holm düzeltmeli anlamlılık taşıyor. Pertürbasyon içermeyen EigenCAM baz çizgisi D-RISE'dan daha az sadık, ancak o da skor bağlanması gösteriyor; etkinin D-RISE'a özgü olmadığı, silme tabanlı değerlendirme düzeneğiyle ilişkili olduğu düşünülüyor. Sonuçlar, güvenlik açısından kritik algı sistemlerinde alan kayması altında güven kontrollü XAI denetimlerini gerekli kılıyor.
Transformers v5.15.0: Meta Muse Glimmer ve yeni modeller
Meta'nın Apache 2.0 lisanslı, ajan odaklı 30B Muse Glimmer modeli Transformers'a geldi.
Transformers v5.15.0, Meta'nın ajan kullanım senaryoları için tasarladığı yeni çok kipli modeli Muse Glimmer'ı getiriyor. Muse'tan 30 milyar parametreye damıtılan model Apache 2.0 lisansıyla yayımlandı. Kodlama, belge analizi ve kişisel asistan gibi gizlilik odaklı uygulamalar için yerel kurulumlarda çalıştırılabiliyor. Yoğun mimarideki model, görsel taraf için 2 milyar parametreli ViT tarzı bir kodlayıcıdan (Perception Encoder) ve 28 milyar parametreli bir metin kod çözücüden oluşuyor. Sürümde ayrıca GraniteMoeSWA, GraniteSWA, A.X-K1, A.X-K2 ve Cosmos3 Edge modelleri de eklendi. Kırıcı değişiklikler de var: doğrusal dikkat modellerinde (Mamba, GDN vb.) çekirdekler artık zorunlu değil, isteğe bağlı. Eski davranışı korumak isteyenlerin çekirdekleri açıkça etkinleştirmesi gerekiyor. Önbellek kırpma API'si yalnızca negatif değer kabul ediyor. T5 ve ailesi (MT5, LongT5 vb.) SDPA ile diğer dikkat arka uçlarını destekliyor. Varsayılan dikkat uygulaması değişebileceğinden, önceki yalnızca eager yoluna bağımlı kullanıcıların attn_implementation="eager" ayarlaması gerekebilir. Sürüm, hem yeni model yelpazesini genişletiyor hem de mevcut projelerde yükseltme öncesi kontrol edilmesi gereken davranış farkları getiriyor.
Runway robotlar için dünya-eylem modeli Praxis-1'i tanıttı
Runway, video ön eğitimini robot kontrolüne çeviren Praxis-1'i açık ağırlıklarla yayımlamayı planlıyor.
Runway, video ön eğitimini robot kontrolüne dönüştüren, açık ağırlıklı bir dünya-eylem modeli olan Praxis-1'i duyurdu. Şirketin genel dünya modellerinin arkasındaki büyük ölçekli video ön eğitimi üzerine kurulu model, ağırlıklı olarak üçüncü şahıs videolardan öğreniyor. Runway teknoloji direktörü Kamil Sindi, robot verisinin kıt ve pahalı olduğunu; Praxis-1'in ise nesnelerin nasıl davrandığını ve görevlerin nasıl ilerlediğini zaten anladığını söylüyor. Performansın video ölçeğiyle arttığını, yani tavanın robot demonstrasyonu sayısıyla değil öğrenilebilecek video miktarıyla belirlendiğini ekliyor. Şirkete göre Runway'in dünya modeli içinde robot politikalarını simüle etmek, gerçek dünya sonuçlarını 0,95 korelasyonla öngörüyor. Bu oran, daha pahalı 3B yeniden yapılandırma tabanlı tekniklerle karşılaştırıldığında olumlu. Model, her türlü gövde ve ortamda çalışan genel amaçlı bir manipülasyon politikası olarak konumlanıyor. Şu anda erken ortaklarla test ediliyor ve önümüzdeki aylarda herkese açılması planlanıyor. Yayın açık ağırlıklarla yapılacak, kapalı bir model olarak değil. Bu yaklaşımın pratik değeri açık: Bir robot ekibi, kendi demonstrasyon verisini toplamak için aylarca uğraşmak yerine hazır bir ön eğitimden yola çıkıp modeli yalnızca kendi görevine uyarlayabilir. Açık ağırlıkların araştırmacılara ve girişimlere sunacağı esneklik de bunu tamamlıyor. Bu adım, robotikte veri darboğazını video ölçeğiyle aşma yaklaşımının sektörde ciddiye alındığını gösteriyor.
OctLLM, mevcut 3B büyük dil modellerinin iki zayıflığını hedefliyor: şekilleri gizli kod kitabı indekslerine ya da koordinat metnine sıkıştırarak uzamsal yapıyı kaybetmeleri ve 3B kipi omurgayı ince ayarlayarak edinip genel dil yeteneğinin üzerine yazmaları. Geometri, modele octree doluluk token'larından oluşan açık bir 3B dizi olarak veriliyor. Tam octree dizileri derinlikle hızla uzadığı için OctLLM, sondan bir önceki seviyedeki düğümleri rastgele boşaltıp alt düğümleri atlıyor; şekil korunurken koordinat ve derinliğe bağlı, daha kısa bir Sparse Octree (S-Octree) elde ediliyor. Bu, konum farkında maske modellemeli üretim ve 3B anlama için kullanılıyor. Diğer cephede, 3B kapasite önceden eğitilmiş parametrelerden ayrı olarak ekleniyor: mesh token'ları bazı bloklarda bağımsız eğitilebilir dallardan geçerken metin ve görüntü token'ları dondurulmuş görsel-dil yolunu koruyor; iki akış ortak öz-dikkat üzerinden etkileşiyor. Tam ince ayara göre çok daha az parametre eğitilmesine rağmen OctLLM, birleşik çok kipli büyük dil modelleri arasında yeni en iyi sonuçlara ulaşıyor: ShapeLLM-Omni'ye kıyasla görüntüden 3B FID'ini %17,4 düşürüyor, render temelli açıklamada 28,7 puan artış sağlıyor ve genel dil kıyaslamalarında omurgayla aynı seviyede kalıyor.