2026-10-07Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünün sayısında üç hat aynı yöne akıyor: trilyon parametreli modeller ve ajan eğitimi ölçeği zorluyor, geometri dünya modellerinden görsel-motor öğrenmeye algının ve eylemin omurgası haline geliyor, donanım ise insan biçiminin sınırlarını aşmaya başlıyor. Bu makaleleri bir arada okumak, ilerlemenin tek bir cephede değil, algoritma, yapı ve beden arasındaki kesişimlerde şekillendiğini görmenizi sağlıyor.
1.Araştırma
NeMo-DCR: Trilyon Parametreli Ajan RL'de Bit-Tam Delta Senkronizasyonu
NeMo-DCR yalnızca değişen ağırlıkları göndererek trilyon parametreli ajan RL'de senkronizasyon süresini kısaltıyor.
Ajan tabanlı pekiştirmeli öğrenmede eğitim ile rollout birbirinden ayrıştırılıyor; bu yüzden her politika güncellemesinin bir sonraki parti başlamadan rollout kümelerine ulaşması gerekiyor. 1 trilyon parametrelik bir checkpoint'in iki AWS bölgesi arasında tamamen aktarılması (refit) 87,5 dakika sürüyor. NVIDIA araştırmacılarının geliştirdiği NeMo-DCR, BF16 eğitiminde adım başına ağırlıkların yalnızca yaklaşık %1'inin saklanan değerini değiştirdiği ölçümüne dayanıyor ve yalnızca değişiklikleri gönderiyor. Yöntem bit-tam çalışıyor: alıcılar, yoğun bir refit'le elde edilecek parametre ve buffer bitlerinin aynısını alıyor.
Sistem üç sorunu birlikte çözüyor. Yerleşim için, eğitim shard'larındaki değişiklikleri checkpoint'in kanonik koordinatlarına izdüşüren sabit afin eşlemeler kullanılıyor; geri kalan değişiklikleri artık dönüşümü karşılıyor. Kesinlik için sıkıştırılabilir XOR maskeleri ve üzerine yazma yamaları taşınıyor; alıcılar bunları yerinde uyguluyor, kısmi yazmalar yeniden denemelerle düzeltiliyor ve ortak bir commit politikayı bir sonraki delta'nın taban çizgisine bağlıyor. Verimlilik için payload'lar, kümeler arası collective işlemine gerek kalmadan nesne depolama veya röle ağacı üzerinden akıtılıyor.
Bu, ajan RL'in coğrafi olarak dağıtık kümelerde ölçeklenmesinin önündeki en büyük darboğazlardan birini hedefliyor. Makalenin özeti, %3 ve %5 değişim oranlarında bile kazanç sağlandığını belirtiyor.
Mistral Large 4 Önizlemesi: 1 Trilyon Parametreli Model
Mistral, 1 trilyon parametreli Large 4'ün önizlemesini yayımladı; açık ağırlıklar ay sonunda gelecek.
Mistral, 1 trilyon toplam ve 49 milyar aktif parametreli Mistral Large 4'ün önizlemesini API üzerinden kullanıma açtı. Model, şirketin kendi 3.800 NVIDIA Grace Blackwell GPU'luk kümesinde eğitildi. Mistral, açık ağırlıklı sürümü "bu ayın sonunda" yayımlamayı vaat ediyor. Model, Mistral API üzerinden yalnızca iki akıl yürütme seviyesi sunuyor: "none" ve "high".
Simon Willison'ın testinde "high" seviyesi, pelikanlı bisiklet çizimi görevinde daha iyi sonuç verirken şaşırtıcı biçimde daha az çıktı token'ı kullandı (2.717'ye karşı 3.275). Artificial Analysis üzerinde model 38 puan aldı; bu, 552 milyar parametreli DeepSeek 4.1 Flash'ın hemen gerisinde. Geçen Aralık'taki Mistral Large 3 ise aynı endekste yalnızca 9 puan almıştı. Yani Mistral, tek bir nesil içinde aynı endeksteki puanını dört katın üzerine çıkardı.
Willison'a göre Large 4 en ileri sınıfta değil, ancak Mistral'ın sınırın yaklaşık altı ay gerisine yeniden yaklaştığını gösteriyor. Bu, Avrupa'nın öncü model yarışında yeniden rekabetçi bir oyuncuya sahip olduğu anlamına geliyor. Açık ağırlıkların gerçekten yayımlanması ise bu ölçekteki bir modelin topluluk tarafından incelenebilmesi, fine-tuning ile özelleştirilebilmesi ve bağımsız olarak değerlendirilebilmesi açısından belirleyici olacak.
ACG-WAM: Geometrik Gizli Tahminle Dünya-Eylem Modellemesi
ACG-WAM, eylem koşullu geometrik tahminle RoboTwin 2.0'da %93,46 başarı elde ediyor.
Dünya-eylem modelleri, görsel tahmin ile robot eylemlerini birlikte öğrenerek sahne evriminden politika öğrenmede yararlanıyor. Ancak video ve eylem kayıpları, gösterilen bir eylem dizisinin geometrik sonuçları için açık bir hedef sağlamıyor. Üstelik zamansal dikkatten sonra alınan görsel özellikler gelecek gözlemlerini içerebildiği için, yardımcı bir tahminciye tek mevcut görsel girdi olarak uygun değil.
ACG-WAM, yardımcı hedefi olan ACG-JEPA ile bunu ele alıyor: mevcut gözlem ve aradaki eylemlerden birkaç ufukta geometrik özellikleri tahmin ediyor. Hedef olarak, her mevcut-gelecek görüntü çiftinin dondurulmuş VGGT kodlamasının gelecek dilimi kullanılıyor. Denetim, baş ve bilek kameralarından zamansal karıştırmadan önce paylaşılan bir görsel gömmeye uygulanıyor; öğretmen ve yardımcı modüller çıkarım sırasında kaldırılıyor. Bu nedenle yöntem, çıkarım maliyetine ek yük getirmiyor.
50 RoboTwin 2.0 görevinde ACG-WAM temiz sahnelerde %93,46 başarıya ulaştı; rastgeleleştirilmiş ortamda %92,68 ile karşılaştırılan yöntemlerin en iyisi, iki ayarın ortalamasında da %93,07 ile önde. Gerçek robotta üç görevde %85,00 başarı ve %91,67 kısmi tamamlama puanı elde etti; bu, Motus'un 10,00 ve 9,17 yüzde puan üzerinde. Sonuçlar, eylemlerin geometrik sonuçlarını açıkça denetlemenin dünya-eylem modellerinde hem simülasyonda hem gerçek dünyada somut kazanç sağladığını gösteriyor.
HLA: Dinamik Parça Karıştırmalı Hibrit Doğrusal Dikkat
HLA, doğrusal dikkate sorguya bağlı parça yönlendirmesi ekleyerek LongBench-V2'de 5,57 puana varan kazanç sağlıyor.
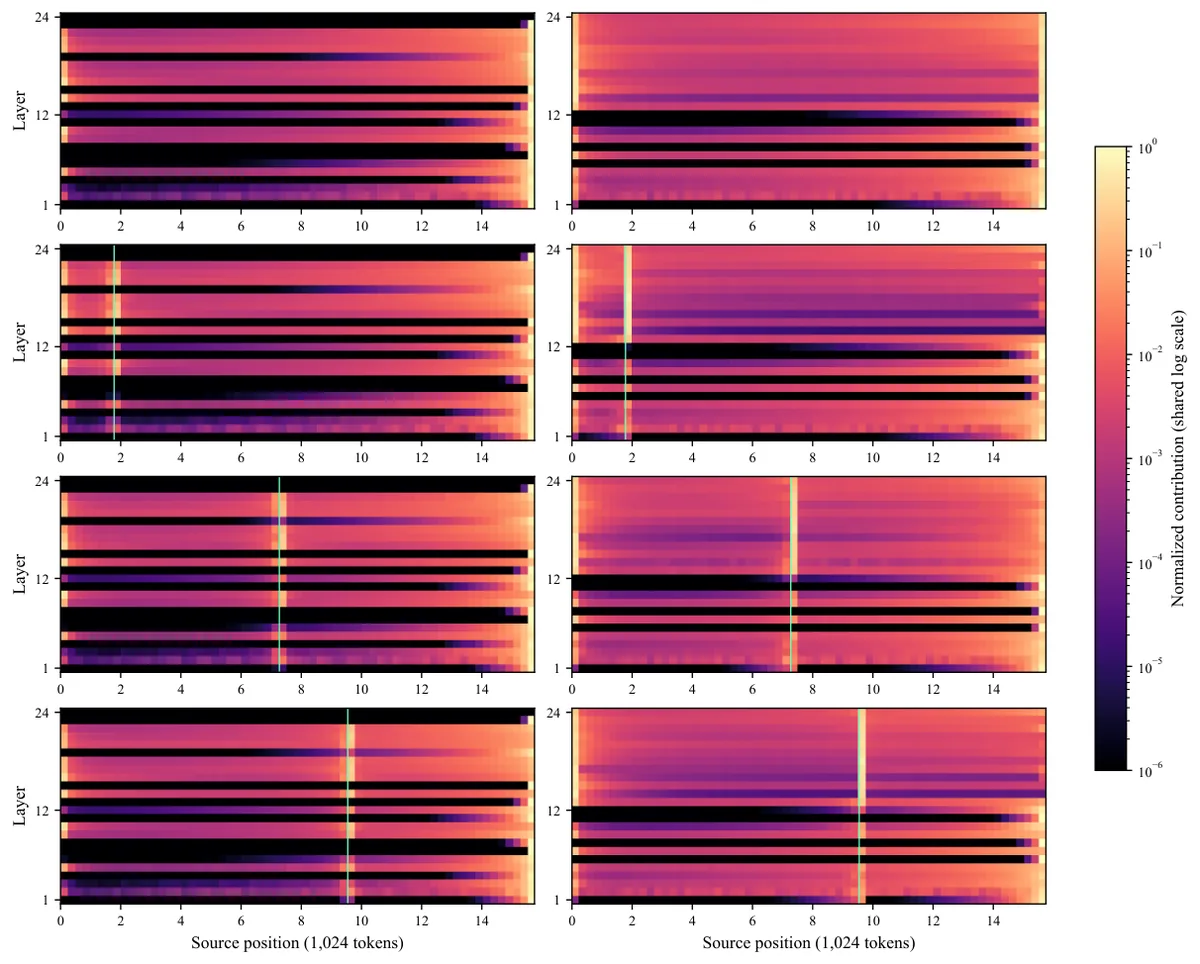
Bağlam uzadıkça yerel GDN'nin geçmiş katkısı en son konumlarda toplanırken HLA, çok daha uzaktaki geçmişten de görünür katkı koruyor. Görsel: Chen ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Doğrusal dikkat, geçmişi yinelemeli durumlara sıkıştırarak uzun bağlamlı otoregresif kod çözmeyi verimli kılıyor; ancak bu sıkıştırma, seyrek ve uzak bilgiye seçici erişimi zorlaştırıyor. Mevcut parça tabanlı uzantılar bellek kapasitesini artırsa da öğrenilen parça karıştırma katsayıları girdi içeriğine göre sabit kalabiliyor ve geçmişe erişimi her sorguya uyarlayamıyor.
Hybrid Linear Attention (HLA), Gated DeltaNet (GDN) için sorguya bağlı, parça düzeyinde bir dikkat mekanizması sunuyor. Her tamamlanmış parçayı tam bir afin durum geçişi olarak temsil ediyor ve içeriğe bağlı yönlendirme kapılarını, kendi kendine dikkatle havuzlanmış kompakt temsilcilerden hesaplıyor. Her kapı, ilgili geçmiş geçişi birim eşlemeyle enterpole ederek hem parçanın eklemeli belleğini hem de önceki durumları dönüştürme biçimini kontrol ediyor. Etkin destek düzenlileştirmesi ise seyrek çıkarım için yoğunlaşmış yönlendirmeyi teşvik ediyor.
Qwen3.5'in 0,8B'den 9B'ye kadar modellerinde HLA, yerel GDN'yi ve sabit parça karıştırmayı tutarlı biçimde geride bıraktı: LongBench-V2'de 5,57, RULER'da 3,97 puana varan kazançlar. 100B token ve 4K bağlamla sıfırdan eğitilen kontrollü 1,3B kurulumunda RULER kazancı 4K'da 0,83 puandan 32K'da 4,22 puana yükseldi. Bu, yinelemeli belleğin sorguya bağlı birleştirilmesinin uzun bağlamda giderek daha fazla fark yarattığını gösteriyor.
DistScene: Tek Görüntüden Kompozisyonel 3B Sahne Üretimi
DistScene, ortamı açık bir bileşen olarak modelleyerek tek görüntüden uzamsal olarak tutarlı 3B sahneler üretiyor.
DistScene, tek bir görüntüden kompozisyonel 3B sahne üretimi için ortamı ve tekil nesneleri birlikte modelleyen bir çerçeve. Sahneleri ağırlıklı olarak nesne koleksiyonları olarak temsil eden yöntemlerin aksine, nesne yerleşimi için geometrik bağlam sağlamak üzere ortamı açık bir sahne bileşeni olarak ele alıyor.
Çerçeve üç adımdan oluşuyor. Scene-Frame Generation, ortam ve nesne bileşenlerini paylaşılan bir koordinat çerçevesinde ayrı ayrı üreterek geometri ve göreli yerleşimin birlikte öğrenilmesini sağlıyor. Object-Centric Refinement, her nesneyi sahne bağlamıyla yerel bir çerçevede iyileştiriyor; böylece nesne düzeyindeki ayrıntı kalitesi korunuyor. Object-to-Scene Distillation ise önceden eğitilmiş nesne üretimi bilgisini, otomatik olarak oluşturulan ve render edilen sentetik sahneler üzerinden sahne üretimine aktarıyor. Bu sayede, sahne ölçeğinde büyük ölçekli gerçek veri toplama ihtiyacı azalıyor.
İç mekân ve dış mekân kıyaslamalarında yöntem, değerlendirilen temel yöntemlere kıyasla sahne düzeyinde uzamsal tutarlılıkta iyileşme gösteriyor. Nesne üretimindeki olgun ön bilgilerin sahne ölçeğine taşınması, 3B içerik üretim hatlarının önündeki en zor sorunlardan birine pratik bir yol açıyor. Oyun, mimari görselleştirme ve robotik simülasyon gibi alanlarda tek görüntüden tutarlı sahne üretimi giderek daha değerli hale geliyor.
OpenAI Açık Matematik Problemlerinde Yeni Sonuçlar Yayımladı
OpenAI, iç öncü modelinin açık matematik problemlerindeki sonuçlarını Lean kanıtlarıyla GitHub'da paylaştı.
OpenAI, iç bir öncü modelden elde edilen, matematikteki açık problemlere dair yeni sonuçları yayımladı. Şirket, Lean ile yazılmış kanıt formalizasyonlarını ve araştırma ayrıntılarını GitHub'da paylaştı.
Lean formalizasyonlarının paylaşılması önemli bir ayrıntı: Lean, kanıtların makine tarafından adım adım doğrulanmasına olanak veren bir kanıt asistanı. Böylece sonuçların doğruluğu, yalnızca şirketin beyanına ya da insan hakemlerin incelemesine bağlı kalmadan bağımsız biçimde denetlenebilir. Bu şeffaflık, yapay zeka kaynaklı matematik iddialarında sıkça dile getirilen en büyük itirazlardan birini, yani doğrulanabilirlik sorununu doğrudan ele alıyor.
Yapay zekanın matematiksel akıl yürütme alanındaki ilerlemesi, genellikle kıyaslama puanlarıyla ölçülüyor. Ancak benchmark puanları, modelin eğitim verisinde gördüğü problemlerle şişebiliyor. Açık problemler üzerindeki doğrulanabilir sonuçlar ise modellerin gerçekten yeni bilgi üretip üretemediği sorusuna daha somut bir yanıt sunuyor. Böyle bir sonuç, eğitim verisinden ezberlemenin mümkün olmadığı bir zeminde elde edildiği için çok daha güçlü bir kanıt değeri taşıyor.
Yayımlanan materyallerin matematik ve yapay zeka topluluğu tarafından incelenmesi, bu iddiaların ne kadar sağlam olduğunu ve bu yaklaşımın ne ölçüde genelleştirilebileceğini önümüzdeki dönemde ortaya koyacak.
Atlas'ın Yeni Eli, İnsansı Tasarımları Geride Bırakabilir
Boston Dynamics, Atlas için seri üretime uygun, sağlam yapılı ve insana benzemeyen yeni bir el tasarımı tanıttı.
Boston Dynamics, Atlas insansı robotu için seri üretim mühendisliğiyle tasarlanmış yeni bir el tanıttı. IEEE Spectrum'un haberine göre tasarım, üç parmak ve bir başparmaktan oluşuyor ve insan elini birebir taklit etmiyor.
Robotik alanında uzun süredir süren bir tartışma var: insansı robotlar, insanlar için tasarlanmış ortamlarda çalışabilmek için insan eline benzer eller mi taşımalı, yoksa görevlere göre optimize edilmiş farklı tasarımlar mı daha iyi sonuç verir? Boston Dynamics'in yaklaşımı, dayanıklılık ve üretilebilirliği öne çıkararak ikinci görüşü destekliyor. Haberin başlığındaki "outperform" ifadesi de, bu tasarımın insansı eller karşısında üstünlük sağlayabileceğine işaret ediyor.
El, bir insansı robotun en karmaşık ve en kırılgan bileşenlerinden biri. Çok sayıda eklem, sensör ve aktüatör barındırdığı için hem maliyeti hem de arıza riski yüksek oluyor. Maliyeti düşük, onarımı kolay ve seri üretime uygun bir el tasarımı, insansı robotların laboratuvardan fabrika zeminine geçişindeki en büyük engellerden birini hafifletebilir. Bu, sektörün prototip aşamasından ticari ölçeğe geçerken hangi mühendislik tercihlerine yöneleceğine dair önemli bir sinyal.
LEAP: Ayrıcalıklı Geometri Denetimini Görsel-Motor Öğrenmede Etkili Kılmak
LEAP, eğitimde ayrıcalıklı 3B geometriyle RGB politikalarını güçlendiriyor; çıkarım hızı ve girdiler değişmiyor.
Ayrıcalıklı 3B denetim, eğitim sırasında ek geometrik bilgiyi kullanarak RGB tabanlı görsel-motor politika öğrenmesini yönlendiriyor; dağıtımda geometrik girdi gerektirmiyor. Ancak düşük yeniden yapılandırma hatası, görsel temsillerin kontrol için yararlı geometriyi yakaladığını garanti etmiyor. Çalışma, bu denetimi zayıflatan üç sınırlılığı tanımlıyor: propriosepsiyon kısayolları, baskın görünüme bağımlılık ve görevle ilgisiz geometrinin baskın olduğu yeniden yapılandırma hedefleri.
LEAP (Latent Encoding with Aligned Privileged Geometry), yardımcı bir kod çözücüyle manipülasyon çalışma alanındaki nokta bulutlarını yalnızca görsel özelliklerden yeniden yapılandırıyor; eylem tahmini için propriosepsiyonu koruyor. Tam yeniden yapılandırmaya ek olarak, bilek görünümü bırakma (wrist-view dropout) ve korunan bilek kamerasına uyumlu kısmi yeniden yapılandırma hedefleri getiriyor. Bu sayede kodlayıcı tamamlayıcı yerel geometriyi yakalamaya teşvik ediliyor. Yardımcı kod çözücü çıkarımda kaldırıldığı için politika girdileri yalnızca RGB gözlemleri ve robot durumu olarak kalıyor.
RoboTwin, ManiSkill ve gerçek dünya görevlerinde Diffusion Policy ve ACT'ye kıyasla tutarlı ve belirgin iyileşmeler elde edildi. Parametre sayısındaki artış küçük, çıkarım hızında ise düşüş yok.