2026-10-08Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bu sayının ortak ipliği, sağlam ve ölçülebilir ilerleme: kıyaslamalar, değerlendirme araçları ve açık modellerle bir alanın nerede durduğunu artık daha net görebiliyoruz. Görü, dil ve robotikte aynı eğilim var; sistemler laboratuvardan sahaya, kısa kliplerden uzun videolara, tek dilden yüzlerce dile taşınıyor. Bu yazıları birlikte okumak, parçalı gelişmeleri tek bir resme bağlayıp yapay zekanın hangi alanlarda gerçekten olgunlaştığını görmenizi sağlıyor.
1.Araştırma
VCR-Bench: Video sınıflandırma dayanıklılığı için ilk modüler kıyaslama
Video sınıflandırıcıların saldırılara dayanıklılığı için açık kaynaklı, standart ve modüler ilk benchmark çerçevesi yayımlandı.
Araştırmacılar, video sınıflandırma modellerinin dayanıklılığını ölçmek için VCR-Bench adlı açık kaynaklı ve modüler bir kıyaslama çerçevesi sundu. Görüntü sınıflandırmada dayanıklılık için birçok benchmark varken, video tarafında benzer bir standart bulunmuyordu. Bu nedenle çalışmalar dağınık ve birbiriyle uyumsuz uygulamalara yayılıyor, raporlanan sonuçların tekrarlanması ve karşılaştırılması zorlaşıyordu.
Videoda zaman boyutu, saldırı, savunma ve ön işleme için ek serbestlik dereceleri getiriyor. Zamansal örnekleme, bozulma bütçeleri ve metrik toplulaştırma, görüntü senaryosunda karşılığı olmayan biçimlerde birbiriyle etkileşiyor. VCR-Bench; video yükleme, sınıflandırıcı sarmalayıcıları, saldırılar, savunmalar, algısal metrikler, yapılandırma ön ayarları ve sonuç kaydını ortak bir protokol altında standartlaştırıyor. Çerçeve şu an 30 video sınıflandırma modelini, 14 saldırıyı ve 10 savunma sarmalayıcısını bir araya getiriyor. Yazarlar, Kinetics-400 alt kümesinde temsili modelleri değerlendirerek temiz doğruluk, saldırı başarı oranı, algısal kalite, çalışma süresi ve bellek kullanımını raporluyor.
Çalışma, tekrarlanabilir kurulum ön ayarları ve genişletme arayüzleriyle birlikte yayımlandığı için video dayanıklılığı araştırmalarında ortak bir zemin oluşturma potansiyeli taşıyor. Makale ACM MM 2026'da kabul edildi.
S2Tok: Kalıcı uzamsal token'larla akışlı 3B Gauss yeniden yapılandırma
S2Tok, kalibre edilmemiş görüntü akışlarından kompakt ve sürekli güncellenen 3B Gauss sahne temsili üretiyor.
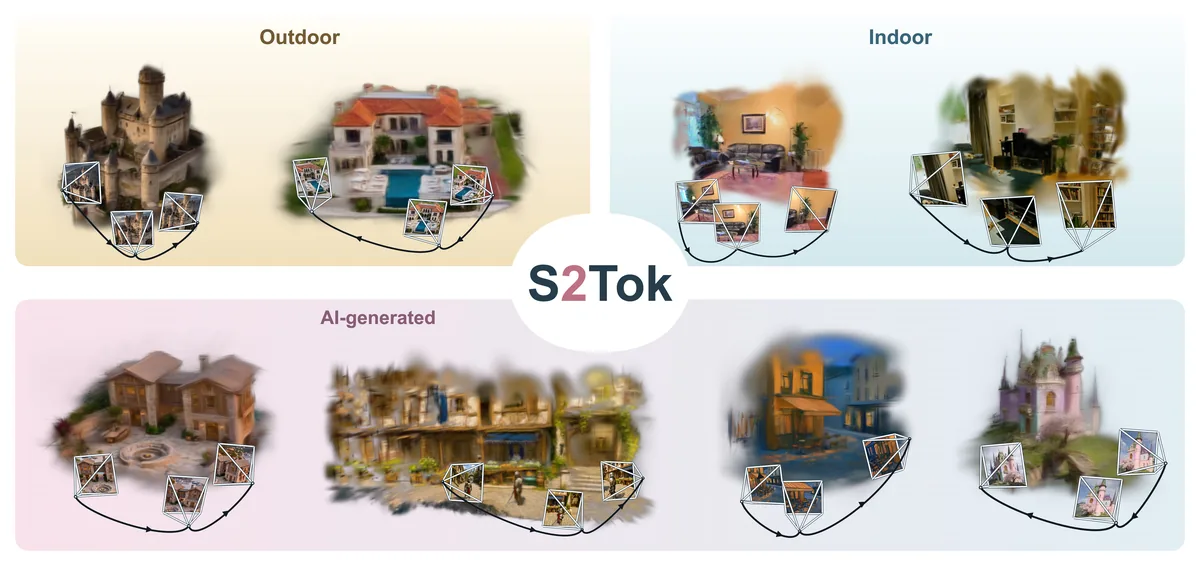
S2Tok'un kalibre edilmemiş görüntü akışından, farklı senaryolarda akışlı biçimde ürettiği nihai 3DGS sahneleri. Görsel: Li ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
S2Tok, kalibre edilmemiş görüntü akışlarından, boyutu uyarlanabilen ve kalıcı bir sahne durumu tutan ileri beslemeli bir 3B yeniden yapılandırma çerçevesi. Akışlı yeniden yapılandırma yalnızca ardışık geometrik tahminler üretmeyi değil, yeni gözlemleri içine katabilen ve her an render edilebilir kalan kalıcı bir sahne durumu korumayı gerektiriyor. Kamera parametrelerinin bilinmediği ve görüntülerin sürekli geldiği gerçekçi senaryolarda, bu iki gereksinimi birlikte karşılamak mevcut yöntemler için hâlâ zorlu bir problem.
Yöntemin temel fikri, mevcut temsilin güncellenmesi ile seçici genişletme arasında ayrım yapmak. Uzamsal bilgiye sahip bir transformer, gelen her gözlemi kalıcı sahne token'larıyla bütünleştiriyor. Öğrenilmiş bir kabul modülü ise temsili yalnızca gerektiğinde genişleterek gereksiz depolamayı sınırlıyor. Böylece sahne temsili, içeriğin karmaşıklığına göre büyüyor ve sabit boyutlu bir bellek varsayımına bağlı kalmıyor. Hiyerarşik bir kod çözücü ve Gauss başlığı, gelişen bu durumu piksele hizalı olmayan 3B Gauss'lara dönüştürüyor; böylece önceki kareleri saklamadan yeni görünüm render edilebiliyor.
Dört benchmark'ta yapılan deneyler, kompakt Gauss temsilleriyle rekabetçi akışlı render kalitesi elde edildiğini gösteriyor. Sonuçlar, gizli uzamsal token'ların çevrimiçi 3B yeniden yapılandırma için kalıcı bir hesaplama durumu olarak kullanılabileceğini destekliyor ve akışlı sahne temsilinde yeni bir tasarım yönüne işaret ediyor.
RACER: Uzun videolarda çerçeve seçimi için yansıtıcı ajan
Eğitim gerektirmeyen RACER, sorguyu alt sorgulara bölerek uzun videolarda doğru kareleri bulmayı hedefliyor.
Vid-LLM'ler, seçilen kareler üzerinden akıl yürüterek çeşitli video-dil görevlerinde başarılı. Ancak uzun videolarda karmaşık bir sorguya uygun kareleri, segmentlere dağılmış büyük bir aday havuzundan seçmek hâlâ zor bir problem. Makale, mevcut yaklaşımları görev ayrıştırması açısından inceliyor ve iki temel sorun tanımlıyor: benzerlik tabanlı yöntemlerdeki sorgu anlama boşluğu ile yargı tabanlı yöntemlerdeki yorumlama-seçim boşluğu. Birincisinde sorgunun örtük ihtiyaçları yakalanamıyor, ikincisinde ise modelden hem sorguyu yorumlaması hem de kare seçmesi birlikte bekleniyor.
Önerilen RACER, eğitim gerektirmeyen yansıtıcı bir ajan çerçevesi. Hafif bir Vid-LLM yalnızca karmaşık sorguyu, örtük bilgi ihtiyaçlarını açık hale getiren alt sorgulara dönüştürüyor. Bir gömme modeli ise erişim aracı olarak bu alt sorgularla ilgili kanıtı buluyor; böylece Vid-LLM doğrudan kare seçme yükünden kurtuluyor. Bulunan kareler, alt sorguların iyileştirilmesi için Vid-LLM'e geri besleniyor ve sorgu yorumunu ile kare seçimini yinelemeli olarak geliştiren bir yansıma döngüsü oluşuyor. Ek bir eğitim gerekmediği için yaklaşım farklı modellere kolayca uyarlanabiliyor.
Birden fazla benchmark'ta RACER, uzun video anlamayı tutarlı biçimde iyileştiriyor. Sınırlı kapasiteli bileşenlerle bile etkili kare seçimi sağlaması, ajan tabanlı entegrasyonun daha güçlü Vid-LLM'leri de destekleyebileceğine işaret ediyor.
Açık kaynak Tokka-Bench, 100 doğal ve 20 programlama dilinde tokenizer'ları beş metrikle ölçüyor.
Büyük dil modelleri alt sözcük (subword) tokenizer'larına dayanıyor ve bunların kalitesi diller arasında değişiyor; ancak geniş çaplı karşılaştırma için standart bir çok metrikli çerçeve yoktu. Tokka-Bench bu boşluğu dolduran, açık kaynaklı bir değerlendirme çerçevesi. Token başına bayt, benzersiz token kapsamı, subword fertility, sözcük bölünme oranı ve sözlük bileşimi olmak üzere beş tamamlayıcı metriği; 30'dan fazla yazı sistemini kapsayan 100 doğal dilde ve 20 programlama dilinde ölçüyor. Her yazı sistemine uyarlanmış, dile duyarlı segmentasyon kullanılıyor; böylece metrikler farklı dil yapıları arasında adil biçimde karşılaştırılabiliyor.
Yedi BPE tokenizer (GPT-2, GPT-4, gpt-oss, Llama 3.1, Gemma 3, Qwen3 ve Kimi K2) tek tek dillerde karşılaştırıldı. Bulgulara göre sözlük tahsis stratejisi, ham sözlük boyutundan daha belirleyici. Ayrıca son dönem tokenizer'larında doğal dil profilleri birbirinden ayrışırken programlama dili verimliliği benzer bir noktada yakınsamış durumda. Başka bir deyişle, tokenizer'ların dillere karşı tutumu tasarım tercihlerine göre belirgin biçimde farklılaşıyor.
Çerçeve, veri ve etkileşimli gösterge paneli herkese açık. Türkçe gibi morfolojik açıdan zengin diller için tokenizer seçiminde somut bir referans sunuyor ve gelecekteki tokenizer tasarımlarına da yön verebilir.
EmbeddingGemma 2: Açık, hafif, çok kipli gömme modeli
Google DeepMind, metin, görüntü, video, ses ve kodu ortak uzayda gömen 740 milyon parametreli açık modeli yayımladı.
Google DeepMind, EmbeddingGemma 2'yi duyurdu: metin, kod, görüntü, video ve sesi tek bir ortak gömme uzayında birleştiren, cihaz üzerinde çalışmaya uygun açık bir model. Gemma 4 mimarisi üzerine kurulu model, 740 milyon parametreye sahip ve Apache 2.0 lisansıyla yayımlanıyor. İlk sürüm 20 milyonu aşkın indirmeye ulaşmıştı.
Google'a göre model, MTEB Code ve MAEB gibi benchmark'larda kendi boyut sınıfındaki (1 milyar parametre altı) çok kipli gömme modelleri arasında lider; birçok daha büyük modelle de eşit veya daha iyi sonuç veriyor. Yapı modüler: yalnızca metin için 270M parametre yeterli, isteğe bağlı görüntü (170M) ve ses (300M) kodlayıcıları eklenebiliyor. Matryoshka Representation Learning sayesinde çıktı vektörleri 768 boyuttan 512, 256 veya 128'e kırpılabiliyor; bu da yerel vektör veritabanlarında 6 kata varan depolama tasarrufu sağlıyor. Kuantizasyonla Pixel 11 Pro'da yalnızca metin ağırlıkları için yaklaşık 191 MB, tam çok kipli model için yaklaşık 567 MB aktif RAM yeterli. 8K token bağlam penceresi, 5,5 dakikaya kadar ses, 29 görüntü veya 58 video karesinin yerel donanımda işlenmesine izin veriyor.
Bu sayede bir sesli notla belirli bir video klibi bulmak ya da saatlerce ses kaydını metin sorgusuyla taramak, tek bir model ve gizliliği koruyan yerel bir akışla mümkün hale geliyor.
HULK: İnsansı robotlar için tüm vücut kuvvetli manipülasyon
HULK, MPC ile yönlendirilen pekiştirmeli öğrenmeyle insansı robotların ağır nesneleri taşımasını ve dengede kalmasını sağlıyor.
İnsansı robotların büyük ve ağır nesneleri taşıması, tüm vücutla kuvvetli etkileşim gerektiriyor. Bu yükler robotun ağırlık merkezini kaydırıyor ve üst gövdeye sürekli yük bindirerek denge ile komut takibini zorlaştırıyor. HULK, bu problem için geliştirilmiş tüm vücut kontrol çerçevesi.
Yöntem, yüklü dinamik tahminleriyle pekiştirmeli öğrenmeyi yönlendirmek için model öngörülü kontrol (MPC) kullanıyor. İki öğretmen politika eğitiliyor: biri bilek kuvvetleri altında kol hareketlerini takip ediyor, diğeri nesneyi gövdesine bastırarak yürüyor. Eğitim sırasında bilek kuvveti öğretmenine, yük altında dengeyi iyileştiren bir yakalama noktası kontrol bariyer fonksiyonu ekleniyor. Her iki öğretmen de tek bir politikaya damıtılıyor; böylece robot tek bir kontrolcüyle hem kol hareketlerini hem de yük altındaki yürüyüşü yönetebiliyor. Değerlendirme hem simülasyonda hem Unitree G1 robotunda yapılıyor.
Simülasyonda bariyer fonksiyonlu öğretmen, kol başına 10 kg yükte değerlendirilen kontrolcüler arasında en düşük ileri ve yanal hız takip hatasına ulaşıyor; yalnızca MPC güdümlü pekiştirmeli öğrenmeye kıyasla toplam DCM (hareketin ıraksayan bileşeni) sapma büyüklüğünü %35,7 azaltıyor. Bilek kuvveti öğretmeni, gövdeye uygulanan 130 N'a kadar itme bozucusuna dayanabiliyor. Bu sonuçlar, ağır yük taşıyan insansı robotlarda dengeli ve dayanıklı kontrol için umut verici bir yol sunuyor.
SAFE: Akustik algılamayla kayma ve kırılma tespiti
İki pasif PVDF sensör, robotik kavramada kayma ve kırılmayı gerçek zamanlı ve düşük maliyetle ayırt ediyor.
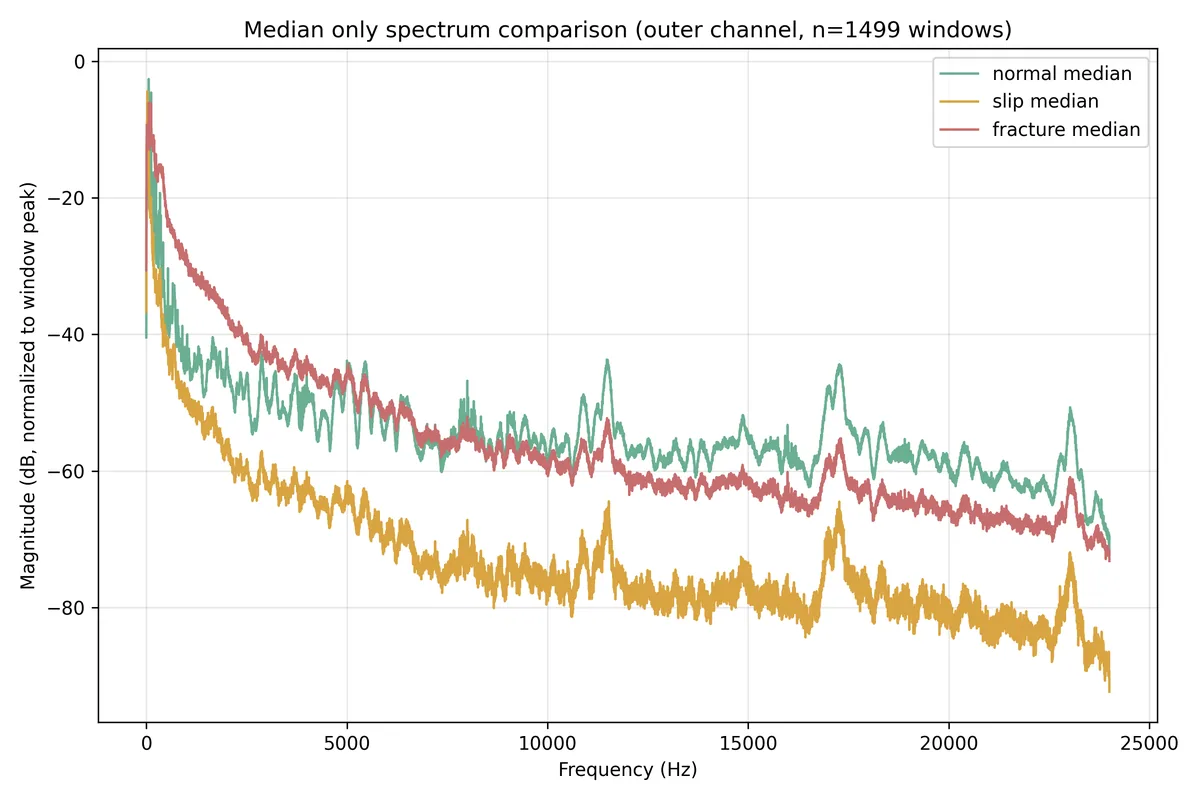
1499 pencere üzerinden dış kanalda her sınıfın medyan genlik spektrumu; sınıflar doğrudan frekans alanında ayırt edilebiliyor. Görsel: Wang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Kırılgan nesneleri tutan robotların, kayma veya kırılma gibi durumları anlayıp uygun tepki vermesi gerekiyor; özellikle malzeme özellikleri bilinmediğinde bu hâlâ zor. SAFE, görüşe veya önceden malzeme bilgisine dayanmadan, iki pasif polivinilidin florür (PVDF) akustik sensörü ve motor propriosepsiyonunu kullanarak kayma ve kırılmayı gerçek zamanlı tespit eden düşük maliyetli, genel amaçlı bir yaklaşım.
Sensörler esnek bir Fin Ray tutucuya monte edilmiş. Birleşik bir HistGradientBoosting sınıflandırıcı, 79 boyutlu bir öznitelik vektöründen durumu (normal, kayma veya kırılma) raporluyor. Tek tutuşu dışarıda bırakan çapraz doğrulamada SAFE, 0,884 Alert-F1 değerine ve kayma-kırılma karışıklığının neredeyse sıfır olduğu bir sonuca ulaşıyor; ablasyonlar akustik algılamanın vazgeçilmez olduğunu doğruluyor.
Bu tespit katmanı üzerine kurulan uyarlanabilir tutma kontrolcüsü, Jetson Orin Nano üzerinde 104 Hz'de çalışıyor ve farklı nesne kategorilerini kapsayan 46 kapalı döngü robot denemesinde %91,3 başarı sağlıyor. Sabit kuvvet stratejilerinin her biri ise ön ayarına uymayan nesne koşullarında %0'a düşüyor. Eğitimde görülmeyen yeni nesnelerde de %82,4 başarı elde ediliyor; yani nesneye özel kalibrasyon olmadan arızaya duyarlı kavrama kontrolü mümkün.
Claude Haiku 5.5 geldi: fiyatlar %90'a kadar düştü
Anthropic'in yeni küçük modeli OSWorld'de %15,7'den %72,4'e sıçradı; token fiyatları ciddi biçimde indirildi.
Anthropic, en hızlı ve en uygun fiyatlı küçük modeli Claude Haiku 5.5'i yayımladı. Model; özetleme, veritabanı sorguları, sınıflandırma ve canlı müşteri desteği gibi yüksek hacimli, maliyete duyarlı görevler için tasarlandı. Ortalamada Haiku 4.5'ten yaklaşık %75 daha ucuz; 100 bin token'a kadar olan istemlerde (Anthropic'e göre eski Haiku isteklerinin yaklaşık %90'ı) fiyat %90'a kadar düşüyor. Girdi için milyon token başına 0,10 dolar, çıktı için 0,50 dolar. 100 bin token üzerindeki istemler beş kat pahalı. Güncellenen tokenizer görev başına biraz daha fazla token tükettiği için gerçek tasarruf, token başı fiyatlardan daha düşük kalabilir.
Benchmark sonuçları büyük bir sıçramaya işaret ediyor. GDPval-AA v2.1'de 735'ten 1.620'ye çıkan model, Humanity's Last Exam'de araçsız %45,9, araçlı %57,4 elde ediyor (öncülünde %10,2 ve %18,7). En çarpıcı sıçrama bilgisayar kullanımında: OSWorld-2.1'de %15,7'den %72,4'e. Ajan tabanlı kodlama testi Terminal-Bench 4.0'da %39,2'ye ulaşıyor; Haiku 4.5 sıfır puan almıştı. Anthropic, OpenAI'ın bütçe modeli GPT-6 Luna'yı da karşılaştırmaya dahil ediyor ve Haiku 5.5 test edilen tüm kategorilerde önde. Yine de Sonnet 5.5 referans puanlarına göre daha büyük modellerin hayli gerisinde.
Bu hamle, yapay zeka fiyat rekabetinin sürdüğünü ve ajan odaklı iş yüklerinin küçük modellere kaydığını gösteriyor.