2026-10-09Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayıyı bir arada tutan soru şu: Bir model eğitim koşullarının dışına çıktığında neyi koruyor, neyi kaybediyor? Ajanları pekiştirmeli öğrenmeyle eğitmekten hedef odaklı dünya modellerine, hızlandırılmış robot politikalarının güvencesinden çocuk konuşmasına uyarlanan tanıyıcılara kadar her çalışma bu gerilimi farklı bir noktada çözüyor. Birlikte okununca, genellemenin ve güvenilirliğin artık sonradan eklenen bir özellik değil, eğitim tasarımının merkezi olduğunu gösteriyorlar.
1.Araştırma
Çocuk Konuşma Tanıma: Yetişkin Performansını Kaybetmeden Uyarlama
Çocuk konuşmasına uyarlanan ASR modelleri yetişkin performansını unutuyor; ağırlık birleştirme dengeyi kuruyor.
Arapça ve İngilizce üzerinde yapılan ampirik bir çalışma, otomatik konuşma tanıma (ASR) sistemlerinin çocuk ve ana dili olmayan konuşmacılarda zayıf kaldığını, ancak yetişkin modellerini çocuk konuşmasına uyarlamanın yetişkin performansında unutmaya yol açtığını gösteriyor. Araştırmacılar tam fine-tuning, LoRA ve eğitim sonrası ağırlık uzayı birleştirme (weight-space merging) yöntemlerini encoder–decoder, encoder–CTC ve AudioLLM tabanlı sistemlerde karşılaştırdı. Değerlendirmede WER'in yanı sıra Retention Index, Child Adaptation Gain ve Adaptation Recovery metrikleri kullanıldı; veri tarafında Arapça ana dili ve ana dili olmayan çocuk konuşması, İngilizce MyST ile MGB-2 ve LibriSpeech test-clean yetişkin benchmark'ları yer aldı. Bulgulara göre çocuk uyarlaması özellikle ana dili olmayan konuşmacılar için şart, fakat doğrudan uyarlama çoğunlukla yetişkin başarımını düşürüyor. İki dilli uyarlama, tek dile özgü uyarlamadan daha kararlı. Ağırlık birleştirme ise özellikle encoder–CTC, Whisper ve AudioLLM tabanlı sistemlerde dengeyi iyileştiriyor: LERP yetişkin performansını korumada, TIES ise çocuk kazanımını geri kazanmada öne çıkıyor. Encoder–decoder modelde ham WER açısından doğrudan iki dilli fine-tuning en iyi sonucu veriyor. Kod ve modeller açık; çalışma, çocuklara yönelik ve kapsayıcı konuşma teknolojileri geliştirenler için pratik bir yol haritası sunuyor.
Agent Lightning v1.0: 3.500 Satırda Ajan Eğitimi için RL
Microsoft, mevcut ajanları yeniden yazmadan pekiştirmeli öğrenmeyle eğiten hafif bir çerçeve yayımladı.
Microsoft Research Asia, Agent Lightning v1.0 ile ajanlar için pekiştirmeli öğrenme (RL) eğitiminde yeni bir paradigma öneriyor: Harnessed Agentic RL. Geleneksel yaklaşımda geliştiriciler ajanı eğitim çerçevesinin içinde yeniden uygulamak zorunda kalıyor. Bu hem emek ve maliyet açısından ağır hem de eğitilen ajan ile yayına alınan ajanın birebir aynı olmaması riskini doğuruyor; eğitimde öğrenilen davranış, canlı ortamda aynı biçimde ortaya çıkmayabiliyor. Agent Lightning ise canlıda kullanılan ajan harness'ının doğrudan RL döngüsüne katılmasını sağlıyor. Böylece eğitim ile üretim arasındaki fark ortadan kalkıyor. Sistemin tüm kontrol düzlemi yaklaşık 3.500 satır kodla yazılmış; ajanlar standart Kubernetes işleri olarak çalışıyor ve ücretli ticari sandbox hizmetlerine hiçbir bağımlılık yok. Ekip, yaklaşımı uçtan uca bir kodlama ajanı hattıyla sınadı. Qwen3.5-9B modeli SWE-bench Verified'da %41,8 olan Pass@1 skorundan %56,4'e çıktı. 14,6 puanlık bu artış, açık kaynak bir veri setinden yalnızca yaklaşık 6.000 eğitim örneğiyle elde edildi. Sonuç, ajan RL'ini küçük ekiplerin ve kendi altyapısını işletenlerin erişebileceği bir noktaya taşıyor: mevcut ajanı yeniden inşa etmeden, canlıdaki haliyle iyileştirmek artık mümkün.
Kapalı döngü video üretimi, prosedürel görevleri adım adım planlayıp yürütüyor.
WorldGuide, uzun ufuklu prosedürel görevlerde video üretimini kapalı döngülü bir görev yürütme problemi olarak ele alıyor. Yalnızca bir başlangıç görüntüsü ve görev hedefi verildiğinde model önce atomik bir eylemi tahmin ediyor, ardından bu eyleme karşılık gelen video klibi üretiyor. Ortaya çıkan sonuca bakarak bir sonraki eylemi seçiyor ya da görevi sonlandırıyor. Açık döngülü üretim yürütme sonuçlarına uyum sağlayamıyor; mevcut kapalı döngü sistemler ise çoğunlukla önceden eğitilmiş yürütücülere veya dolaylı doğrulamaya dayanıyor. WorldGuide'da Planner ve Executor aynı adım düzeyindeki prosedürel gösterimlerle eğitiliyor. Hiyerarşik görsel bellek ise geçmişin maliyetini sınırlı tutarken uzun vadeli durumu koruyor. Adım düzeyinde eylem-video denetimi eksikliğini gidermek için ekip, 245 görev ve 27 prosedürel kategoride yaklaşık 59 bin adım-etiketli videodan oluşan WorldGuide-Bench'i de yayımlıyor. Model bu benchmark'ta %33,33 Task Success elde ediyor. Bu oran, uzun ufuklu prosedürel video üretiminin hâlâ zorlu bir problem olduğunu da gösteriyor. Çalışma, video modellerini yalnızca makul görüntü üreten sistemlerden, ürettiği duruma göre karar veren ve hedefine ulaşana kadar kendini düzelten ajanlara taşımanın somut bir örneği.
MiMo-V2.6: Kendini Geliştiren Modeller İçin RL Ölçekleme
Xiaomi MiMo ekibi, RL hesaplamasını ölçekleyen omni-modal bir model ailesi tanıttı.
Xiaomi MiMo ekibi, büyük temel modelleri kendini geliştirmeye taşımanın merkezî yolu olarak gördüğü pekiştirmeli öğrenmeyi (RL) ölçekleyen MiMo-V2.6 serisini sunuyor. RL öncesinde geniş bir multimodal derlem üzerinde mid-training yapılıyor ve önceden eğitilmiş hibrit-SWA mimarisi üzerine sağlam bir altyapı kuruluyor. RL hesaplaması üç boyutta ölçekleniyor: daha büyük batch ve yüksek verim (asenkron eğitimde adım başına 1.568 örnek, 2,7–3,7 milyar token, 1 milyon tokene kadar bağlam), kod, genel, görsel ve siber alanlarını kapsayan daha çeşitli ortamlar ve daha fazla grader hesaplaması. Grup bazlı ajan değerlendirmesi, uzun ufuklu görevlerde daha doğru ödül sinyali üretirken modeli daha kısa ve token-verimli çözümlere yönlendiriyor. Ölçekte kararlılık için MoE router dondurulmuş ve ödül istismarına (reward hacking) karşı çok katmanlı bir savunma kurulmuş. Ekip ayrıca birleşik yörünge temsili, yüksek eşzamanlı çoklu çerçeve rollout'u ve eğitim-çıkarım tutarlılığı gibi altyapı bileşenlerini geliştirdi ve eğitim dinamiklerini, RL ortamlarını ve çerçevesini açık kaynak olarak paylaşıyor. Sonuç, RL ölçeklemesinde veri, ortam ve değerlendirme tarafının model boyutu kadar belirleyici olduğunu gösteriyor.
Nature MI'da yeni çerçeve: muhakeme token'ları anlatı değil, dışsallaştırılmış hesaplama durumu.
Dil modelleri yanıt vermeden önce giderek daha fazla muhakeme token'ı üretiyor; ancak ampirik kanıtlar, bu token'lar metin olarak okunduğunda modelin gerçek muhakeme sürecinin sadık bir açıklaması olmadığını gösteriyor. Nature Machine Intelligence'ta yayımlanan perspektif yazısında Levy ve arkadaşları, görünüş ile işlev arasındaki bu boşluğu kapatmak için State over Tokens (SoT) çerçevesini öneriyor. SoT'a göre muhakeme token'ları dilsel bir anlatı değil, ayrı üretim döngüleri arasında hesaplamayı taşıyan dışsallaştırılmış bir hesaplama durumudur. Bu bakış, token'ların neden doğru sonuca götürürken aynı zamanda sadık bir açıklama olmayabildiğini açıklıyor. Ayrıca iki yaygın yanılgıyı çürütüyor: metnin sürecin tamamını kaydettiği ve modelin sözcükleri, insan okurun onlara atfettiği anlamlarla kullandığı. Yazarlara göre modelin mekanizmasını anlamak için token'ları metin olarak okumanın ötesine geçmek, onları durum olarak çözmeye odaklanmak gerekiyor. Bu, yorumlanabilirlik araştırmalarında zincirleme muhakeme çıktılarına nasıl yaklaşılacağını da değiştirebilir. Örneğin bir modelin ürettiği düşünce zincirini ikna edici bir gerekçe olarak okumak yerine, hesaplamanın hangi ara durumları taşıdığını izlemek daha anlamlı bir yöntem hâline gelebilir. Çerçeve, hem yorumlanabilirlik hem de yapay zeka güvenliği araştırmaları için yeni sorular açıyor; çünkü bir modelin kendi muhakemesini anlattığını varsaymak yerine, bu anlatının gerçekte ne işe yaradığını sorgulamayı gerektiriyor.
Hızlandırılan VLA politikalarında görev bozulma riski, istatistiksel garantiyle sınırlanıyor.
Vision-language-action (VLA) modellerini her kontrol adımında çalıştırmak pahalı; eylem parçalama (action chunking) ve görsel token budama gibi hızlandırma teknikleri ise genellikle yalnızca gecikme ve ortalama başarıyla değerlendiriliyor. Oysa hızlandırma bilgi kaybına yol açıp orijinal politikanın çözebildiği görevleri bozabilir; bu risk ortalama metriklerde gizli kalıyor. CARE, bu sorunu eşleştirilmiş rollout'larla ele alıyor: aynı başlangıç koşullarından referans politikanın başardığı ama hızlandırılmış politikanın başaramadığı durumlar “hızlandırma kaynaklı başarısızlık” olarak tanımlanıyor. Kalibrasyon kümesindeki eşleştirilmiş rollout'lar, bu başarısızlık riskinin kullanıcının belirlediği bütçenin altında kaldığına dair sonlu örneklem garantisi veriyor; hiçbir aday yeterli değilse sistem referans modele dönüyor. Yöntem yalnızca nihai sonuçlara ve ölçülen hesaplamaya dayandığı için farklı hızlandırma mekanizmalarına değişmeden uygulanabiliyor. OpenVLA-OFT ile dört LIBERO paketinde CARE, 9,0–10,8 kat hızlanmayı sertifikalarken, %95 güvenle referansın çözdüğü bölümlerin en az %85,8'inin korunduğunu garanti ediyor. Çalışma, robotik politikalarda hız kazanımını güvenilirlikle birlikte raporlamanın yolunu gösteriyor. Hızlandırmanın ne kadar işe yaradığını değil, ne kadar güvenle işe yaradığını ölçmek, ajanların gerçek dünyada kullanımı için önemli bir adım.
MESSENGER: Bellek Destekli Sıralı Sahne Akışı Tahmini
Otoregresif sonraki kare tahminiyle sahne akışı hatası nuScenes'te %71,6 azaldı.
Sahne akışı (scene flow), dinamik ortamlardaki düşük seviyeli 3B hareket yer değiştirmelerini yakalıyor. İki kareye dayanan klasik tahmin ediciler uzun vadeli zamansal korelasyondan yoksun ve geleceği tahmin etmede zayıf; çok kareli yöntemler ise girdi sayısı arttıkça hesaplama yükü artıyor ve etkisiz hareket yayılımı nedeniyle uzun ufuklu tahminde bozuluyor. MESSENGER, geçmiş akış tahminlerini ve gizli durumları açıkça saklayan bir bellek tamponu kullanıyor. Her yeni kare için depolanan akışlar ve durumlar ilişkilendirilip geri çağrılıyor ve mevcut akış, sonraki kare tahmini mantığıyla öngörülüyor. Sisteme ayrıca, güvenilmez geri çağırmaları filtreleyen ve biriken hataları azaltan bir belirsizlik farkındalıklı yeniden ağırlıklandırma modülü ekleniyor. nuScenes ve Argoverse 2 deneylerinde uzun ufuklu gelecek ekstrapolasyonunda EPE3D, nuScenes'te %71,6, Argoverse 2'de %67,7 düşüyor. Yazarlar bu başarıyı, ağı geçmiş gözlemlere dayanarak sonraki kare dağılımını kademeli olarak öğrenmeye zorlayan otoregresif tahmin paradigmasına bağlıyor. Bu yaklaşım, özellikle otonom sürüş gibi geleceği öngörmenin güvenliğe doğrudan etki ettiği uygulamalar için önem taşıyor. Çalışma NeurIPS 2026'ya kabul edildi; kod yayımlanacak.
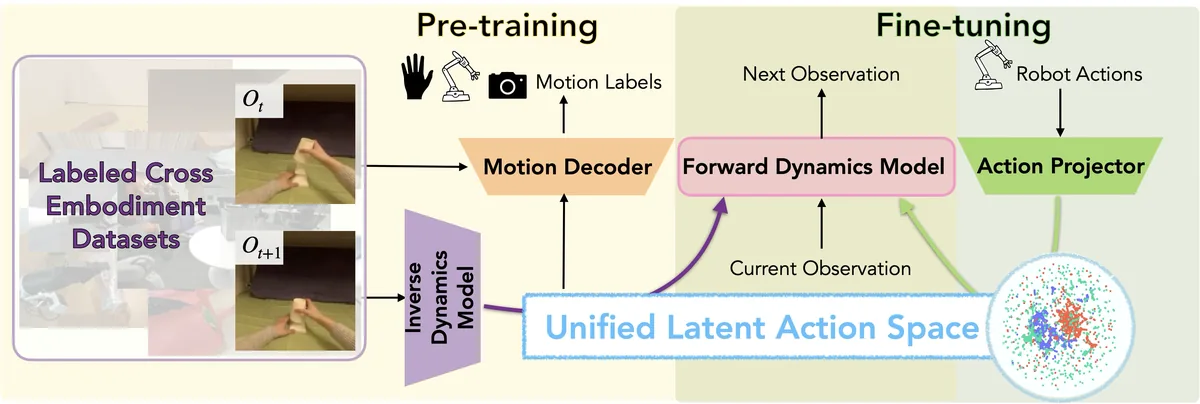
LAC-WM, farklı robotları ortak gizli eylem uzayında birleştirerek yeni robotlara uyumu artırıyor.
LAC-WM mimarisi: ön eğitimde ters dinamik modeli, farklı robotların görüntü gözlemlerini ortak bir gizli eylem uzayına kodlar ve bu eylemler ileri dinamik modelinin koşulu olur. Görsel: Huang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Robotların gövde ve eylem uzaylarının çeşitliliği, farklı robotlara genellenebilen dünya modelleri kurmayı zorlaştırıyor. Latent Action-Conditioned Robot World Model (LAC-WM), farklı robotlar arasında paylaşılan, öğrenilmiş birleşik bir gizli eylem uzayında çalışıyor. Ekip bunu, açık hareket etiketlerine koşullanan Explicit Action-Conditioned World Model (EAC-WM) ile karşılaştırdı. Açık eylem koşullaması robotlar arasında birbirinden kopuk eylem temsillerine yol açıyor ve yeni bir robota uyarlamada performansı sınırlıyor. İki model, beceri gerektiren manipülasyon görevlerinde ve değiştirilmiş bir LIBERO benchmark'ında test edildi. LAC-WM, EAC-WM'ye göre manipülasyonda %46,7'ye, LIBERO'da %11,7'ye varan iyileşme sağladı. En dikkat çekici bulgu ise ölçeklenme davranışı: önceden eğitimde kullanılan robot sayısı arttıkça LAC-WM'nin performansı yükselirken EAC-WM'nin performansı düşüyor. Yani veri çeşitliliği, açık eylem koşullamasında bir yük hâline gelirken birleşik gizli uzayda bir avantaja dönüşüyor. Sonuçlar, çapraz-gömülü öğrenmede birleşik eylem uzayının robotikteki temel zorluklardan birine doğrudan cevap verdiğini gösteriyor. Bu sayede her yeni robot için sıfırdan veri toplama ihtiyacı azalabilir ve mevcut veri setleri çok daha verimli kullanılabilir. Daha fazla robot verisinin gerçekten daha iyi genelleme getirebileceğine dair güçlü bir işaret; proje sayfası yayında.