2026-10-12Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bu sayıdaki yazıların ortak iplik: yapay zekanın dünyayı nasıl algıladığı, bunu içinde nasıl temsil ettiği ve bu temsili fiziksel eyleme nasıl dönüştürdüğü. Dokunma verisinden uzamsal akıl yürütmenin iç mekanizmalarına, üretken dünya modellerinden açık robotik araçlara uzanan bu seçki, algıdan somutlaşmaya giden hattın her halkasını tek bir bakışta görmenizi sağlıyor. Böylece hangi darboğazın hâlâ açık, hangisinin aşılmak üzere olduğunu birlikte okuyabilirsiniz.
1.Araç
AWS'den robotik için açık kaynaklı Fiziksel Yapay Zeka araç zinciri
AWS ve NVIDIA araçları, robotik geliştirmeyi tek açık kaynaklı hatta topluyor.
AWS, robotik için açık kaynaklı bir Fiziksel Yapay Zeka (Physical AI) araç zinciri yayımladı. Araç zinciri, AWS ve NVIDIA araçlarını bir araya getiriyor ve geliştirme sürecinin ana aşamalarını tek bir hat altında topluyor: sentetik veri üretimi, model eğitimi, simülasyon ve doğrulama, uç cihazlara dağıtım ve sürekli iyileştirme.
Bu yapı, robotik ekiplerin genellikle ayrı ayrı yönettiği veri, eğitim, test ve dağıtım adımlarını birbirine bağlıyor. Sentetik veri ve simülasyon sayesinde gerçek dünyada toplanması pahalı ya da riskli senaryolar sanal ortamda üretilip doğrulanabiliyor; ardından model uç cihaza taşınıyor ve sahadan gelen geri bildirimle yeniden iyileştiriliyor. Böylece her iterasyon, fiziksel robot üzerinde uzun test döngülerine ihtiyaç duymadan hızlanabiliyor.
Araç zincirinin açık kaynaklı olması, ekiplerin bileşenleri kendi ihtiyaçlarına göre uyarlamasına ve tek bir sağlayıcıya bağımlı kalmadan çalışmasına imkân tanıyor. Fiziksel yapay zeka uygulamalarını prototipten üretime taşımak isteyen girişimler ve araştırmacılar için bu, kurulum maliyetini ve entegrasyon yükünü azaltma potansiyeli taşıyor. Dağıtım ve sürekli iyileştirme adımlarının hatta dahil edilmesi de modellerin sahada ürettiği verinin yeniden eğitime akmasını kolaylaştırıyor. Makalenin tam metnine erişilemediği için ayrıntılar kaynaktaki kısa özete dayanıyor.
MIT'li ekibin yapay zekası Stratego'da üst sıradaki insan oyuncuları yendi.
MIT, Carnegie Mellon, New York Üniversitesi ve Stanford'dan araştırmacılar, Stratego adlı strateji oyununda dünyanın en iyi insan oyuncularını farkla yenen bir yapay zeka sistemi geliştirdi. Bu başarıya daha önce hiçbir yapay zeka ulaşamamıştı. Sistem, rakip modellere kıyasla daha verimli de çalışıyor.
Stratego, rakibin taşlarının kimliğinin gizli olduğu, yani eksik bilgiyle oynanan bir savaş oyunu. Araştırmacılardan Gabriele Farina'ya göre oyunda hesaba katılması gereken olası senaryolar patlayıcı biçimde artıyor; poker gibi oyunlar için geliştirilen yapay zeka teknikleri bu ölçekte işe yaramıyordu. Her hamlede hem kendi taşlarının bilinen konumları hem de rakibin gizli taşları hakkında yürütülen çıkarımlar birlikte düşünülmek zorunda olduğundan, arama uzayı klasik yöntemlerle yönetilemeyecek kadar büyüyordu. Yeni sistem makine öğrenmesindeki gelişmelerden yararlanarak bu engeli aşıyor.
Önemi oyunun ötesinde: Gizli bilgi içeren karmaşık durumlarda rakibi alt edecek stratejiler üretebilen bu yaklaşım, ileride askeri manevralar ya da iş dünyasındaki müzakereler gibi alanlarda karar vericilere destek olabilir. Eksik bilgiyle karar verme, gerçek dünyadaki stratejik sorunların çoğunun ortak özelliği olduğundan, bu sonuç oyun tahtasının çok ötesinde bir yön gösteriyor.
TouchScale, tek bir birleşik giyilebilir düzenekle kaydedilmiş, temas yoğun insan etkileşimlerinden oluşan 500 saatlik bir veri seti. Büyük ölçekli birinci şahıs insan videosu somutlaşmış öğrenme için önemli bir denetim kaynağı hâline geliyor; ancak video, fiziksel etkileşimi tanımlayan temas ve basıncı kaydetmiyor. Mevcut görsel-dokunsal veri setleri bu boşluğu dolduruyor, fakat hacimleri insan videosundan çok daha küçük. Üstelik en büyük kaynaklar çoğu zaman farklı sensörlerin veya etiketleme yöntemlerinin kayıtlarını birleştirdiği için veri ölçeğinin etkisini ayırt etmek zor.
TouchScale yaklaşık 2 bin tanımlı görev içeriyor; bunlar gündelik etkinlikleri ve yapılandırılmış manipülasyonu kapsıyor. Her kayıt, birinci şahıs RGB-D videoyu bilek kamerası videosu ve yoğun, tüm eli kapsayan iki elli dokunsal ölçümlerle zamansal olarak hizalıyor.
Tam veri setiyle eğitmek, eğitimde hiç kullanılmamış bir dokunsal sensörde, ek uyarlama yapmadan teması belirgin biçimde daha isabetli tahmin etmeyi sağlıyor: tahmin edilen ve gerçek temas bölgelerinin örtüşmesini ölçen IoU skoru 0,134'ten 0,383'e çıkıyor. TouchScale ile önceden eğitilen görsel kodlayıcı, karşılaştırılan görsel-dokunsal veri setleri arasında üç kıyaslamada da en yüksek eylem tanıma doğruluğunu veriyor. Robot politikasının görsel-dokunsal ara eğitiminde kullanıldığında ise dört temas yoğun manipülasyon görevinde gerçek dünyadaki ortalama başarı oranı %22,5'ten %57'nin üzerine çıkıyor.
Çok kipli modellerin içindeki uzamsal çalışma alanı: S-Space
MLLM'lerde nesne konumlarını kodlayan doğrusal bir alt uzay keşfedildi.
Araştırmacılar, çok kipli dil modellerinin (MLLM) uzamsal akıl yürütmesini destekleyen iç mekanizmaya ışık tutan S-Space'i keşfetti. S-Space, nesne belirteçlerinin yatay, dikey ve uzaklık eksenlerinde sürekli koordinatları kodladığı doğrusal bir temsil alt uzayı. Eksenler, uzamsal cevap skorlarının nesne belirteci aktivasyonlarına göre türevi alınarak belirleniyor; buna rağmen alt uzay belirli veri veya istemlerin ürünü değil, modelin kendi özelliği ve uzamsal olmayan sorularda da okunabiliyor.
Çalışma, S-Space'in modelin iç uzamsal çalışma alanı gibi işlediğini gösteriyor. Algı, nesne konumlarını buraya kodluyor ve bu temsiller doğru uzamsal yargılar için doğrudan okunabiliyor; iç akıl yürütme, bakış açısı değiştiğinde bu temsili dönüştürüyor; sözlü yanıtlar ise ona seçici biçimde erişiyor. Nedensel müdahaleler uzamsal yargıları değiştirirken uzamsal olmayan yanıtları büyük ölçüde koruyor. Vaka çalışmaları, alt uzayın daha önce görülmemiş varlıklara ve gözlemciye de konum atadığını, fiziksel yönleri soyut dilsel anlamlarla ilişkilendirdiğini gösteriyor.
S-Space aynı zamanda uzamsal akıl yürütme hatalarını teşhis etmek için araç olarak kullanılıyor. Yön sözcüklerinin okunması, kardinal ve görüntüye göre referans çerçeveleri arasında sistematik bir bağlanma ortaya koyuyor. Bu bulgular, MLLM'lerin uzamsal yeteneklerini ve sınırlarını anlamak için somut bir yol sunuyor.
DataVista: Veri videolarında çok kipli LLM teşhisi
İlk veri videosu kıyaslamasında en iyi model %70 doğruluğa ulaştı.
DataVista, veri videosu anlama için geliştirilmiş ilk kıyaslama. Veri videosu, veri görselleştirmesini video anlatımıyla birleştiren ve haberlerde ile iş analizinde yaygın kullanılan bir medya biçimi. Genel video anlamadan farklı olarak animasyonlu grafiklerden doğru veri okumayı, grafikler ve zaman boyunca kanıt birleştirmeyi ve anlatı düzeni ile görsel tasarımın bilgiyi nasıl ilettiğini kavramayı gerektiriyor. Mevcut kıyaslamalar ise ya genel videoları ya da statik grafikleri hedefliyor.
Kıyaslama, 961 gerçek dünya veri videosu ve 6.775 değerlendirme sorusu içeriyor. Sorular, üç düzeyli kademeli bir yetenek çerçevesine (veri algısı, zamansal akıl yürütme, anlatı anlama) göre 10 ince taneli soru türü ve beş konu alanı altında düzenlenmiş. 19 yaygın MLLM'nin değerlendirilmesinde en iyi model Gemini-3.1-Pro %70,0 genel doğruluğa ulaştı; bu, insan uzmanların performansının hâlâ oldukça altında. Modeller en çok Nedensel Akıl Yürütme ve Anlatı Yapısı sorularında zorlandı.
Kare sayısını artırmak ve altyazı eklemek esas olarak veri algısına ve zamansal akıl yürütmeye fayda sağlıyor; anlatı anlamadaki kazanç sınırlı kalıyor. Yanıtların analizi, grafik okuma, kanıt değerlendirme ve talimat anlamada tipik hata kalıplarını ortaya koyuyor. Kıyaslama GitHub'da erişime açık.
PanTact: Giyilebilir arayüzle tüm gövde ustalığı öğretmek
İnsansı robot, yalnızca insan gösterimlerinden tüm gövdesiyle manipülasyon öğreniyor.
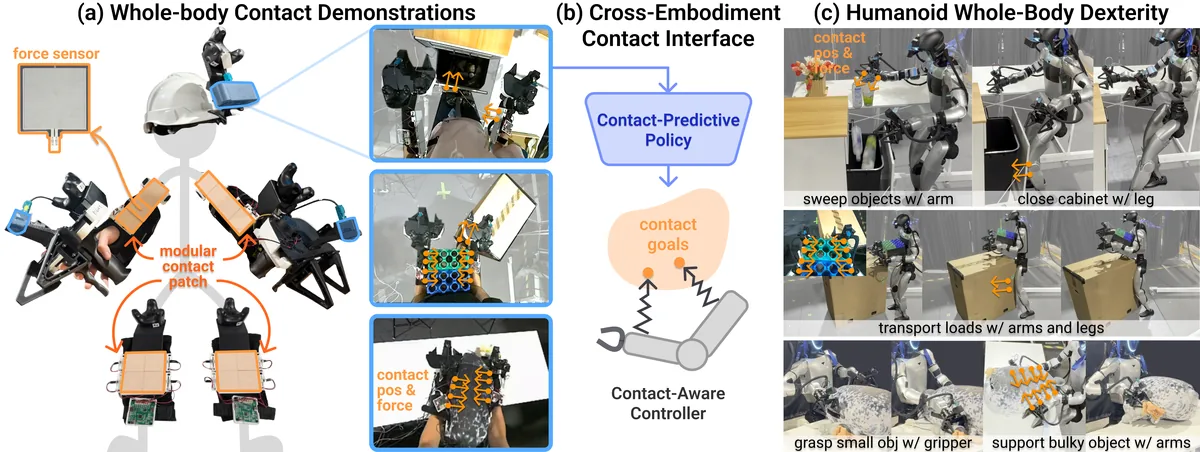
PanTact, robot kullanılmadan toplanan insan gösterimlerinden temas bilgisini aktarım arayüzü olarak kullanıp insansı robota tüm gövde ustalığı kazandırıyor. Görsel: Xu ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
PanTact, insansı robotların yalnızca elleriyle değil, uygun olan herhangi bir gövde yüzeyiyle nesne manipüle etmesini sağlayan bir sistem. Mevcut loko-manipülasyon araştırmalarının çoğu manipülasyonu ellerle sınırlıyor ve ortamla diğer gövde temaslarından kaçınıyor. PanTact ise robot gerektirmeyen insan gösterimlerinden tüm gövde ustalığını öğreniyor. Temel fikir, temasın cisimleşmeler arasında aktarılabilen, manipülasyon odaklı bir bilgi olması: temas konumları ve zamanlaması görevi tanımlıyor, robot ise bunları kendi fiziksel kısıtları içinde nasıl gerçekleştireceğine karar veriyor.
Sistem üç parçadan oluşuyor: birinci şahıs görüntüyü ve iki elli UMI tutucuları, tüm gövdedeki modüler temas yamalarıyla destekleyen giyilebilir veri toplama arayüzü; birinci şahıs gözlem farkını azaltıp tüm gövde temas hedeflerini tahmin eden bir görsel-motor politika; ve aktif temas hedeflerini uygun robot yüzeyleriyle gerçekleştiren temas farkındalıklı tüm gövde kontrolü.
Ekip PanTact'i, ek gövde temas sensörü olmayan bir Unitree G1 insansı üzerinde çalıştırdı. Robot; gövde desteği, itme, süpürme ve yük paylaşımı içeren tüm gövde ustalığı gösterdi. Bu sonuç, insansı robotların manipülasyon repertuarını ellerin ötesine taşımak için temas merkezli veri toplamanın uygulanabilir olduğunu gösteriyor.
Esnek örtük özyineleme: Tek model, değişken hesaplama
ELR, tek döngüde sıradan modele denk, ek döngülerle daha doğru dil modeli sunuyor.
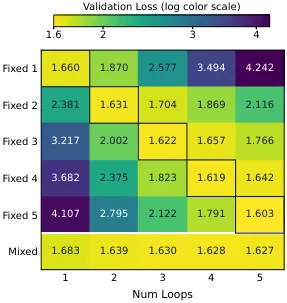
GPT-0.5B üzerindeki ablasyonlar, durum güncelleme kurallarının ve sabit ya da karışık derinlikli eğitimin ELR performansını nasıl etkilediğini karşılaştırıyor. Görsel: Ladhak ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Örtük özyinelemeli (latent recurrent) bir dil modeli, paylaşılan bir katman bloğunu tekrar tekrar uyguluyor; böylece tek bir kontrol noktası, döngü sayısını değiştirerek çıkarım hesaplamasını doğrulukla takas edebiliyor. Ancak bu modeller tek döngüde, aynı boyuttaki özyinelemesiz modelin belirgin biçimde gerisinde kalıyor; araştırmacıların "tek döngü vergisi" dediği bu açık, gecikmenin önemli olduğu durumlarda ayrı bir model tercih edilmesine yol açıyor.
Elastic Latent Recurrence (ELR), bu vergiyi ortadan kaldıran bir eğitim tarifi. Üç tasarım seçimine dayanıyor: öğrenilmiş adım boyutlu kapılı durum güncellemesi, her optimizer güncellemesi içinde karıştırılan döngü sayıları ve her geçişin döngü indeksi ile bütçesine koşullandırılması. İlk ikisi tek döngü doğruluğunu korurken üçüncüsü her ek döngüde kaybı düşürüyor. Karışık derinlikler ön eğitimin geç aşamasında devreye alınarak ek eğitim maliyeti sınırlanabiliyor. MoE modellerde ilk döngünün uzman rotalarını sonraki döngülerde yeniden kullanmak, doğrulukta ölçülebilir değişiklik olmadan güncelleme süresini %11,7 kısaltıyor. Çıkarımda yalnızca son döngünün dikkat KV önbelleğini tutmak, KV belleğini tek döngü seviyesinde tutarken ek döngülerin kazancının çoğunu koruyor.
On görevlik ortalamada ELR, tek döngüde boyutu eşleştirilmiş taban modelle neredeyse başa baş: 4B yoğun modelde 0,52 puan geride, 30B-A3B MoE hibrit modelde ise 1,04 puan önde. Dört döngüye çıkmak, 4B modele 7,25, MoE modele 4,75 puan daha ekliyor. Son eğitimle elde edilen Koi-4B, tek döngüde tahmini 18, dört döngüde 29 puan alıyor; ilki Qwen3.5-4B ile eşdeğer.
Odyssey-3: Ücretsiz denenebilen üretken dünya modeli
Odyssey-3, metin isteminden gerçek zamanlı etkileşimli ortamlar üretiyor.
Kaliforniya merkezli yapay zeka şirketi Odyssey, dünya modeli Odyssey-3'ün herkese açık araştırma önizlemesini başlattı. Model, metin isteminden gerçek zamanlı etkileşimli ortamlar üretiyor; kullanıcılar bu dünyaları farklı bakış açılarından keşfedip etkileşime girebiliyor. Geliştiriciler API erişimi için başvurabiliyor. Ücretsiz çevrimiçi demo, Odyssey-3 Flash üzerinde çalışıyor.
Model, önceki kareler ve kullanıcı eylemlerine dayanarak sürekli yeni video kareleri üreten, otoregresif bir difüzyon dönüştürücüsü (diffusion transformer) üzerine kurulu. Odyssey'e göre eğitim sırasında görsel gözlemlerden fiziksel ilişkileri ve neden-sonuç bağlantılarını öğreniyor. Eğitim verisi arasında olay açıklamalı internet videoları, klavye ve fare girdileriyle eşleştirilmiş oyun görüntüleri ve simüle edilmiş fiziksel etkileşimler bulunuyor. Ek bir eğitim tekniği gereken hesaplama adımlarını azaltarak gerçek zamanlı üretimi mümkün kılıyor. Temel model 14 milyar parametreli ve 832 × 480 piksel çözünürlükte video üretiyor; Odyssey-3 Pro ise 1280 × 720 destekliyor.
Şirket, Pro sürümünün Physics-IQ Verified video-video kıyaslamasında 66,1 puan aldığını ve fizik kıyaslamalarında zirvede yer aldığını belirtiyor; kaynak haber bu rakama bir çekince eklediğini ima ediyor, ancak metnin devamı mevcut içerikte yer almıyor. Odyssey-3, sanal dünyalar üretmenin ötesinde, simüle ortamlardaki robot kolları ve dronlardan video oyunu karakterlerine kadar farklı sistemleri kontrol etmek için bir temel olarak tasarlanmış.