2026-10-14Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünün sayısında yapay zekanın hangi yüke ne kadar maliyetle talip olduğu sorusu öne çıkıyor. Küçük ve hızlı modellerden seyrek dikkate, sıkıştırılmış muhakeme verisinden difüzyon düzeltmesine kadar verimlilik artık yalnızca hız meselesi değil. Veri kalitesi, algı ve fiziksel eylem bu denklemin parçaları. Bu makaleleri birlikte okumak, sahadaki ilerlemenin ölçekten çok daha akıllı kurulumlardan geldiğini gösteriyor.
1.Endüstri
Claude Haiku 5.5: En Hızlı ve En Ucuz Küçük Model
Anthropic'in Haiku 5.5'i, selefine göre ortalama %75 daha ucuz ve ayarlanabilir efor seviyesiyle geliyor.
Anthropic, bugüne kadar çıkardığı en ucuz, en hızlı ve en yetkin küçük model olarak Claude Haiku 5.5'i duyurdu. Model; özetleme, sıkıştırma, veritabanı sorguları ve sınıflandırma gibi yüksek hacimli ve maliyete duyarlı iş yüklerine göre tasarlandı. Canlı müşteri desteği ve tarayıcı kullanımı gibi hız gerektiren görevlerde de öne çıkıyor. Haiku 5.5, kodlama işlerinde Opus 5.5 ve Sonnet 5.5 ile alt ajan (subagent) olarak birlikte çalışabiliyor. Fiyat tarafında Haiku 4.5'e kıyasla çalıştırma maliyeti ortalama yaklaşık %75 düşüyor. Anthropic ayrıca Sonnet 5.5'in önbellek okuma fiyatını yarıya indirdi; bu, çoğu ajan tabanlı iş yükünde yaklaşık %20 tasarruf anlamına geliyor. Claude Max ve Team aboneleri için ajan ve uygulama geliştirmeyi desteklemek üzere aylık API kredisi de getirildi. Haiku 5.5, Haiku sınıfında ayarlanabilir efor seviyesi sunan ilk model; kullanıcılar maliyet ile zekâ arasında tercih yapabiliyor. Şirketin paylaştığı sonuçlara göre model, OSWorld 2.1'de %72,4 ve Terminal-Bench 4.0'da %39,2 skor alırken Haiku 4.5 bu testlerde sırasıyla %15,7 ve %0,0'da kalıyor. Hızlı ve ucuz modellerin ajan sistemlerinin yapı taşına dönüştüğü bir dönemde Haiku 5.5, büyük ölçekli dağıtımlarda maliyet-performans dengesini yeniden tanımlıyor.
Daha Az Eğitimle Daha Fazla Öğrenmek: Muhakeme Verisini Sıkıştırmak
Belirsizlik rehberli yöntem, tam veri SFT'nin yalnızca %0,22'lik optimizasyon bütçesiyle benzer muhakeme başarımı sağlıyor.
Muhakeme sonrası eğitimde (post-training) veri kümelerini büyütmek, eğitim maliyetini orantısız biçimde artırıyor. Araştırmacılar bu noktadan hareketle şu soruyu soruyor: Muhakeme denetimi, yetenekten ödün vermeden ne kadar sıkıştırılabilir? Önerilen çerçeve, öğretmen modelin ürettiği düşünce zincirini (CoT) tek bir sabit yol olarak ele almak yerine, ara muhakeme durumları çevresinde Monte Carlo ağaçları kurarak süreç düzeyindeki belirsizliği ölçüyor. Bu belirsizlik, ilk aşamada orijinal veri kümesini küçük ve öğretmen bilgisiyle zenginleştirilmiş bir havuza daraltıyor. İkinci aşamada ise öğrenciyi dikkate alan bir daraltma, SFT sırasında çevrimiçi yönlendirme yaparak optimizasyonu öğrencinin değişen öğrenme durumuna göre yoğunlaştırıyor. Böylece eğitim, öğrencinin gerçekten zorlandığı örneklere odaklanıyor ve gereksiz tekrarlar azalıyor. Farklı muhakeme benchmark'ları ve LLM aileleri üzerindeki deneylerde yöntem, tam veri SFT'nin optimizasyon bütçesinin yalnızca %0,22'sini kullanıyor; bu, 450 kattan fazla daha az eğitim maruziyeti demek. Buna rağmen muhakeme başarımı korunuyor ya da iyileşiyor. Sonuçlar doğrulanırsa, muhakeme modellerini eğitmenin maliyeti, daha çok veriden çok daha akıllı veri seçimine bağlı olabilir. Bu da küçük ekiplerin ve sınırlı bütçeli laboratuvarların muhakeme odaklı modelleri eğitebilmesinin önünü açabilir.
TerminalHorizon, uzun görevli terminal ajanları için veri sentezleyen otomatik motor; Qwen3.5-27B ile fine-tune edildi.
Terminal ajanları, yerel işlemlerin ötesine geçerek gerçek dünyadaki profesyonel görevleri üstlenmeye başlıyor. Kısa yörüngeler komutları ve araç çağrılarını gösterebilir, ancak ajanların keşif yoluyla kanıt biriktirmesini, geri bildirime göre strateji değiştirmesini ve ara sonuçları nihai çıktıya dönüştürmesini yansıtmaz. Ortam sentezi ise bu davranışların dayandığı kilit işi önceden tamamlayıp basitleştirebilir; böylece ajanın keşif, uygulama ve doğrulama yapma ihtiyacı ortadan kalkar. Çalışma bu soruna TerminalHorizon ile yanıt veriyor: uzun ufuklu terminal ajanları için tam otomatik bir veri sentezi motoru. Motor, gerçek profesyonel işlerden yola çıkıp bağımsız yürütme ile ortam kurulurken atlanan kilit işi tespit ediyor ve bu kanıtı ortamı yeniden kurmak için kullanıyor. Aynı hedef altında görevleri aşamalı olarak genişleterek önceki sonuçlara dayanan yeni gereksinimler ekliyor. Motorla 1,5 bin görev ortamı oluşturuldu ve Qwen3.5-27B bu veri kümesiyle denetimli fine-tuning'e tabi tutularak TerminalHorizon-27B elde edildi. Yazarlar, değerlendirdikleri tüm benchmark'larda belirgin başarım artışı bildiriyor. Ajan eğitiminde darboğazın model boyutundan çok, uzun ve gerçekçi yörünge verisinin kalitesinde olabileceğini gösteren bir çalışma.
WorldRecon: Büyük Ölçekli 3B Sahneler İçin Üretken Mesh
Pozsuz RGB görüntülerden bütünlüklü 3B sahne mesh'i üreten WorldRecon, Chamfer mesafesini %14,9 ve %43,1 düşürdü.
Pozsuz çoklu görüntülerden büyük ölçekli sahnelerin eksiksiz ve yüksek kaliteli mesh'lerini çıkarmak, hem geometrik sadakat hem de görülmeyen ya da seyrek yakalanan yüzeylerin makul biçimde tamamlanmasını gerektiriyor. WorldRecon, bu amaçla geliştirilmiş üretken bir çok görüntülü yeniden yapılandırma çerçevesi. Önce bir yeniden yapılandırma modeli, girdi görüntülerinden kaba ve gürültülü bir global nokta bulutu ile kamera pozları tahmin ediyor; bu çıktı, tüm sahne üretimi için küresel bir iskelet görevi görüyor ve örtüşen uzamsal bloklara bölünüyor. Kusurlu geometrik önsel bilgileri sağlam biçimde kullanmak için yerel 3B üretken model TRELLIS.2, yeniden yapılandırmaya dayalı özel bir koşullandırma mimarisiyle donatıldı. Böylece her blok, kendi nokta bulutu kırpımı ve ilgili görüntü gözlemlerinden üretilerek seyrek yapı, ayrıntılı geometri ve PBR malzemeleri elde ediliyor. Sahne düzeyinde tutarlılık ise komşu farkındalıklı latent inpainting ve örtüşen bloklar arasında yapısal, geometrik ve malzeme bağlamını yayan nedensel bir üretim prosedürüyle sağlanıyor. Sentetik ve gerçek veri kümelerindeki deneylerde yöntem, en güçlü temel yöntemlere göre Chamfer mesafesini %14,9 ve %43,1 azaltırken F-skorunu %17,3 ve %12,0 artırıyor. Oyun, simülasyon ve robotik için büyük sahnelerin otomatik 3B modellemesine doğru önemli bir adım.
Dyna Robotics, bir milyon saatlik insan videosuyla eğitilen dünya-eylem modeliyle robotları üretim ortamına taşıyor.
Dyna Robotics'in kurucu ortağı ve baş bilimcisi Jason Ma, Latent Space podcast'inde şirketin bir milyon saatlik insan videosu üzerinde eğitilmiş dünya-eylem modeli Dyna-2'yi anlatıyor. Model, gelecek video tahminini robot eylemleriyle birleştiriyor ve insandan robota aktarımda dört büyüklük mertebesi boyunca yeni ölçekleme yasaları iddia ediyor. Ma'ya göre gerçek dünyadaki asıl zorluk, güvenilir ve uzun ufuklu özerklik. Şirketin modelleri restoran peçetelerini 24 saat boyunca %99,4 başarıyla katladı; Din Tai Fung'da günde binlerce peçete katlıyor. Yeni bir göreve 45 dakikalık gösterimle uyum sağlanabildiği belirtiliyor. Dyna, kendi yarı-insansı donanımını geliştiriyor ve ajan altyapısı (agentic harness) sayesinde Dyna-2.1 ile saatlik iş akışlarını yürütebiliyor. Konuşma ayrıca difüzyon transformer'ları, flow matching, sentetik ortamlar ve modelin kendi ürettiği eğitim verisinin potansiyelini; dekstroz eller ve eksik duyusal veri gibi darboğazları da ele alıyor. Ma, laboratuvar demolarının ötesine geçip müşteri ortamında günlerce kesintisiz çalışan sistemlerin tasarımında hangi mühendislik tercihlerinin belirleyici olduğunu da tartışıyor. Demo odaklı robotik çağından üretimde çalışan sistemlere geçişin neye benzediğini gösteren, sektörden güncel bir bakış.
LLM ajanlarına görsel-geometrik kontrol paneli veren RoboHarness, BEHAVIOR Challenge'da en iyi VLA modellerini geride bıraktı.
Büyük dil modellerinin yükselişi genelci somutlaştırılmış yapay zekâ için yeni bir yol açtı; asıl soru, LLM'lerin fiziksel dünyada nasıl eyleme geçeceği. Doğrudan yaklaşım, robot eylem verisi ve video gösterimleri toplayıp mimariye bir eylem başlığı ekleyerek ölçekte bir görme-dil-eylem (VLA) modeli eğitmek. Yazarlar ise farklı bir görüş öne sürüyor: kodlama ajanları genelci manipülasyonu gerçekleştirebilir, bunun için yalnızca basit ama etkili bir robot harness'ı yeterlidir. RoboHarness, LLM ajanlarına görsel-geometrik bir kontrol paneli sunarak somutlaştırılmış görevleri doğrudan anlamalarını ve çağırmalarını sağlıyor. Ajan, sahneyi bu panel üzerinden okuyor, nesnelerin konumunu ve geometrisini değerlendiriyor, ardından kod üreterek robotu yönlendiriyor. Bu çerçeveyle Qwen3.8-Flash-Next, BEHAVIOR Challenge 2025 görevlerinde en gelişmiş VLA modellerinden daha iyi sonuç veriyor. Uygulamanın açık kaynak olarak yayımlanacağı belirtiliyor. Bulgu, robotikte yaygın olan büyük ölçekli eylem verisi toplama eğiliminin tek yol olmayabileceğine işaret ediyor. İyi tasarlanmış bir arayüzle genel amaçlı modeller fiziksel görevlerde rekabetçi olabilir. Bu yaklaşım, pahalı ve zahmetli robot verisi toplama sürecine olan bağımlılığı azaltabilir ve robotik araştırmalarında deneme maliyetlerini düşürebilir.
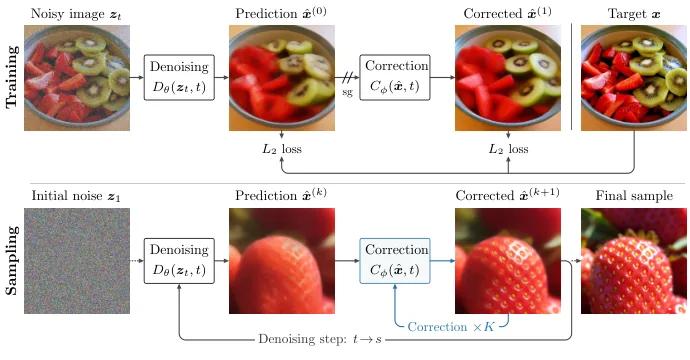
Eğitimde gürültü giderici ve düzeltici aynı temiz hedefi tahmin eder; örneklemede her tahmin bir sonraki adımdan önce K kez rafine edilir. Görsel: Ahn ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Difüzyon modellerinde yinelemeli örnekleme, maruz kalma yanlılığı (exposure bias) nedeniyle hata birikimine yol açabiliyor. Denoiser, eğitimde gürültüyle harmanlanmış gerçek görüntülerle çalışıyor; çıkarımda ise önceki adımlardaki kendi kusurlu tahminlerinden oluşan girdilerle karşılaşıyor. Araştırmacılar bu eğitim-çıkarım farkını azaltmak için bir düzeltme adımı öneriyor: düzeltici, temel modelin tahminini girdi olarak alıyor ve aynı gerçek hedefe karşı eğitiliyor. Örnekleme sırasında her gürültü giderme adımında denoiser'ın temiz örnek tahmini yinelemeli olarak iyileştiriliyor; böylece erken artefaktlar nihai örneğe taşınmıyor. Düzeltici yalnızca temel denoiser tahminleriyle eğitilse de çıkarımda kendi çıktılarına tekrar uygulanabiliyor. Yöntem, çeşitliliği büyük ölçüde korurken örnek kalitesini belirgin biçimde artırıyor. DiT, SiT ve JiT üzerinde yapılan değerlendirmelerde, rehberliksiz ve özellikle koşulsuz üretimde daha önce bildirilen FID skorları önemli ölçüde iyileşiyor; sonuçlar sınıflandırıcısız rehberlik (CFG) ile rekabet edebiliyor. Düzeltmeyi CFG ile birleştirmek çeşitliliği artırıyor ve CFG'nin tipik aşırı doygunluğunu azaltıyor. Ek çıkarım maliyeti ise iyileştirilmiş tahminlerin temel modele damıtılmasıyla ortadan kaldırılabiliyor. Bu bulgu, difüzyon örneklemesindeki hata birikiminin ek bir eğitim bileşeniyle hafifletilebileceğini ve üretim kalitesinin yalnızca rehberliğe bağlı olmadığını gösteriyor.
DoSA, token seçimini birebir koruyarak indexer'ı SGLang'e göre 2,74 kata kadar hızlandırıyor.
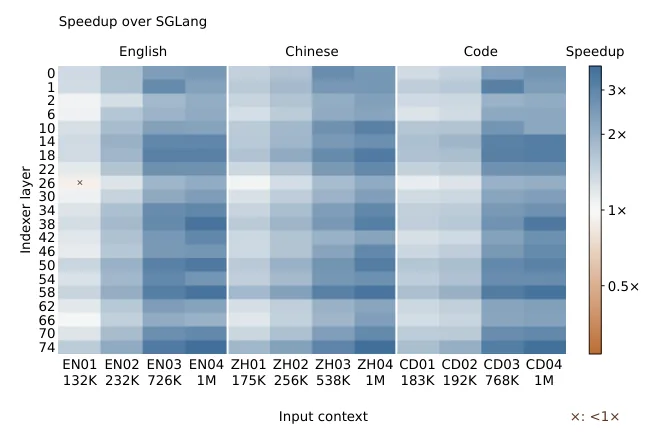
Son 32K sorguda katman bazında erişim hızlanması SGLang ile kıyaslanır; çarpı işareti taban çizgisinden yavaş hücreleri gösterir. Görsel: Meng ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Seyrek dikkat az sayıda anahtarı ziyaret eder, ancak bu anahtarları bulmak yine de her anahtarı her indexer başlığıyla puanlamayı gerektirebilir. DoSA (Dots Sparse Attention), token seçimini birebir koruyarak bu hesaplamayı koşullu hale getiren kayıpsız bir yöntem. Temel gözlem şu: Top-K seçimi, bir adayı elemek için tam skoru değil, yeterli kanıtı ister. Bir tohum küme, kazanan eşik için alt sınır sağlıyor; negatif olmayan başlık projeksiyonları ve ortak artık sınırları pozitif katkılar için üst sınır veriyor, aktivasyon bilgili toplama ise negatif başlıkların çıkardığı büyüklüğü sınırlıyor. Bu sertifika, tam puanlamayı yalnızca hâlâ uygun kalan adaylara yönlendiriyor. Yazarlar sertifikayı ve tam seçim koşullarını kanıtlıyor; geometri ile seçim marjlarının etkinliği nasıl belirlediğini de analiz ediyor. GPU uygulaması, İngilizce, Çince ve kod iş yüklerinde tüm Indexer'ı SGLang'e göre 2,74 kat, LiteTopK'ye göre 1,69 kata kadar hızlandırıyor. GLM-5.2 ve DeepSeek-V3.2 üzerinde uçtan uca değerlendirmede ilk token süresi (time-to-first-token) bu iki temel yönteme göre sırasıyla 1,94 ve 1,50 kata kadar iyileşiyor. Uzun bağlamlı çıkarımda doğruluktan ödün vermeden hız kazanmak isteyen altyapı ekipleri için somut bir katkı.