2026-10-16Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayıda üç eksen birbirini besliyor: ajanlar araç kullanmayı ve kendi verisini üretmeyi öğreniyor, mimariler dikkat mekanizmasının maliyetini aşağı çekiyor, görü modelleri ise neyi nereden öğrendiğini göstermeye başlıyor. Bu sekiz çalışmayı birlikte okumak, alanın tek bir hamlesini değil, ajan yığınından temsil öğrenimine uzanan bütünlüklü yönelimini görmenizi sağlıyor: daha açık, daha verimli ve daha denetlenebilir sistemler.
1.Araştırma
ProgAgent: Programatik Eğitimle Araç Orkestrasyonu Öğrenimi
Araç çıktılarını bağlama değil çalışma zamanı değişkenlerine yazan ProgAgent, uzun görevlerde bağlam çürümesini önlüyor.
HKUST NLP Grubu, büyük dil modellerinin araçları yalnızca 215 görevle çalıştırılabilir kod üzerinden yönetmeyi öğrenmesini sağlayan ProgAgent'ı tanıttı. Sistem, Programatik Araç Çağırma (PTC) yaklaşımını bir çıkarım zamanı hilesi olmaktan çıkarıp tam bir eğitim yığınına dönüştürüyor: doğrulanabilir uzun ufuklu görevler üreten bir hat, hafif bir PTC çalışma zamanı ve iki aşamalı bir eğitim tarifi. Geleneksel Doğrudan Araç Çağırma (DTC) yönteminde her araç yanıtı modelin bağlamına eklenir ve bu birikim bağlam çürümesine, yani orkestrasyonun çökmesine yol açar. PTC ise ara sonuçları bağlam yerine çalışma zamanı değişkenlerinde tutuyor. Dört ortam ölçeğinde örneklenen 215 görev, dört kıyaslamada benzer boyuttaki temel modellerden daha yüksek başarı oranı sağlamış. LOCA-bench'te ProgAgent-14B, 64 bin token'lık ortam durumunda %30,7 başarıya ulaşırken karşılaştırılan modeller sıfır puan aldı. PTC ile eğitilen modeller, hem PTC hem DTC arayüzü altında DTC ile eğitilenleri geride bırakıyor; bu da kazancın yalnızca arayüzden kaynaklanmadığını gösteriyor. Uzun ufuklu ajanlar için bağlam yönetimi, bellek eklemekten çok hesaplamayı koda taşımakla çözülebilir.
Görsel-Dil Modellerinde Yama Düzeyinde Eğitim Verisi Atfı
MOSAIC, bir görsel-dil modeli çıktısının hangi eğitim örneklerinden ve hangi görüntü bölgelerinden geldiğini izliyor.
Araştırmacılar, görsel-dil modellerinin (VLM) tahminlerini eğitim verisine kadar izleyen MOSAIC yöntemini önerdi. Mevcut atıf yöntemleri çoğunlukla örnek düzeyinde çalışıyor; dil modellerindeki gizli temsil tabanlı yaklaşımlar ise çok kipli ve uzamsal yapıdan yoksun. MOSAIC, görüntü ve metin için ortak bir seyrek gizli uzay öğreniyor. Bu uzaydaki kavramlar her kip içinde seyrek, bitişik görüntü bölgelerine dayalı, onları tanımlayan ifadelerle hizalı ve yaklaşık olarak ilişkisiz olacak biçimde kurgulanıyor. Ardından EK-FAC ile eğitim örneklerinin etkisi bu kavramlara ayrıştırılıyor ve katkılar belirli metin ifadelerine ile görüntü bölgelerine yerelleştiriliyor. Yöntem Qwen ve Gemma üzerinde görsel altyazılama, göğüs röntgeni anlama ve görsel soru yanıtlama görevlerinde değerlendirildi. Öğrenilen özellikler görev performansını düşürmeden daha yerel ve tutarlı çıktı; etkiye göre sıralanan gizli birimleri kaldırmak, aktivasyon veya sıklığa göre sıralananları kaldırmaktan model çıktısını daha fazla değiştirdi. Çalışma, bir modelin davranışının nereden geldiğini ve bu etkiyi hangi çok kipli kanıtın taşıdığını aynı çerçevede birleştiriyor; özellikle tıbbi görüntüleme gibi hassas alanlarda yorumlanabilirlik açısından önemli.
Hizalamadan Önce Arındır: Difüzyon Modellerinde Temsil Hizalama
LAP, yerel olarak tahmin edilebilir içeriği ayıklayıp artığa hizalayarak difüzyon eğitimini iyileştiriyor; FID 53,1'den 42,3'e düştü.
Temsil hizalama, difüzyon modelinin ara özelliklerini önceden eğitilmiş bir görsel kodlayıcıya benzetmeye zorlayarak eğitimi hızlandırıyor. Ancak standart yaklaşım, hangi bilginin üretim için faydalı olduğunu ayırt etmiyor. Yeni çalışmada önerilen yerel görünüm arındırma (LAP) yöntemi, hedef temsilden yerel olarak tahmin edilebilir içeriği çıkarıyor ve modeli geriye kalan artığa hizalıyor. Yalnızca hizalama hedefi değişiyor; difüzyon eğitiminde ya da çıkarımında herhangi bir değişiklik gerekmiyor. Kontrollü deneyler, hizalamanın etkisinin hedefin ne kadar görüntü bilgisi taşıdığına değil, hangi bilgiyi öne çıkardığına bağlı olduğunu gösteriyor. Yazarlar teorik olarak standart hizalamaya varyasyonel bir yorum getiriyor ve bazı kodlayıcıların arındırmadan neden daha fazla yararlandığını ölçen kesin bir sabit-okuma testi türetiyor. LAP, beş önceden eğitilmiş temsilde (MAE, AIMv2, CLIP, DINOv2, DINOv3) üretim kalitesini artırıyor; en büyük kazanç MAE'de görülüyor: ImageNet-256'da SiT-B/2 ile FID 53,1'den 42,3'e iniyor. Kazanımlar daha güçlü hizalama tariflerinde ve farklı tokenizer'larda da sürüyor. Difüzyon eğitiminden önce hesaplanan sabit-okuma skoru, arındırmanın faydasını 13 kodlayıcıda Spearman ρ=0,94 ile öngörüyor. Bu sonuç, hizalama hedeflerinin rastgele seçilmemesi gerektiğini gösteriyor: hangi bilginin hedeften çıkarılacağına eğitime başlamadan karar verilebiliyor.
OpenGCUA: Genel Amaçlı Bilgisayar Kullanımı İçin Tamamen Açık Yığın
Açık kaynak OpenGCUA, kod yürütme ve karar aktarımıyla sekiz modelde ortalama kısmi puanı 19,6 puan artırdı.
Bilgisayar kullanan ajanlar yalnızca arayüz tıklamaktan, görsel ve programatik arayüzler üzerinden görev tamamlamaya doğru evriliyor. OpenGCUA, modelin gözlem, eylem ve iş organizasyonu biçimini kendisinin seçtiği genel amaçlı bilgisayar kullanımı ajanları (GCUA) için tamamen açık bir yığın geliştirmeyi hedefleyen, topluluğa açık bir proje; GPT-6 Astra gibi öncü uygulamaların büyük ölçüde kapalı kalması sistematik incelemeyi zorlaştırıyordu. Tasarımın merkezinde kod yürütme var: ara sonuçlar sonraki işlemleri belirleyebiliyor ve modeller programlama yeteneklerini doğrudan bilgisayar etkileşimine uygulayabiliyor. Ekip ayrıca bazı gözlem ve görev durumu kararlarını sabit harness kurallarından modele devreden 'harness'tan modele karar aktarımı' önerdi. OSWorld-v2'de tam yapılandırma, GPT-6 Astra ve Claude Opus 5 dahil değerlendirilen sekiz modelin tamamında görev puanlarını yükseltti; ortalama kısmi puan 19,6 puan arttı ve görev başına raporlanan adım sayısı toplu GUI-only yürütmeye kıyasla ortalama %53,0 azaldı. Uygulama, istemler, sekiz modelin değerlendirme izleri, gerçek cihaz harness'ının ve cihazlar arası SDK'nın ön sürümleri yayımlandı. Gerçek macOS görevlerinde Qwen3.8-Max, GPT-6 Astra'nın 19,4 katı akıl yürütme token'ı kullandı; bu, gerçek cihaz verimliliğinde modeller arası büyük farkları gösteriyor.
MLExpert: Otonom Makine Öğrenmesi Mühendisliği İçin Ajan Modeli
35B MoE tabanlı MLExpert, MLE-Bench Lite'ta madalya oranını %37,9'dan %72,7'ye çıkardı.
Büyük dil modelleri, bilimsel araştırmaya yardımcı olmaktan yapay zeka sistemlerini otonom biçimde geliştirmeye doğru ilerliyor. Bu 'AI4AI' yönelimi, özyinelemeli kendini geliştirme için pratik bir yol sunuyor. Ancak uzun bir makine öğrenmesi mühendisliği (MLE) çalışması çok sayıda maliyetli deney içeriyor ve her deneyin geri bildirimi önceki birçok kararı yansıtıyor. Bu çalışma, uzun ufuklu MLE optimizasyonu için bir son eğitim yöntemi öneriyor ve 35B parametreli Uzmanlar Karışımı (MoE) tabanlı MLExpert ajan modelini eğitiyor. Kaggle-MLE Factory, çalıştırılabilir görevler ve model yönlendirmeli deney için bir etkileşim altyapısı üretiyor. Hiyerarşik ajan SFT, sonuç rehberli denetimle genel araç kullanımı ve kodlama yeteneklerini MLE'ye aktarıyor. Pencereli Etkileşim Pekiştirmeli Öğrenmesi (WIRL) ise ardışık deney sonuçları arasındaki çok turlu kararları bir yürütme penceresi sayıp ortak, sonuç tabanlı ödül atıyor; eşzamansız toplama ve politika düzeltmesi, yörünge bitmeden güncelleme yapılmasını sağlıyor. MLE-Bench Lite'ta temel modelin ortalama madalya oranı %37,9'dan %72,7'ye yükseldi ve Kimi-K3 ile GLM-5.3 gibi daha büyük öncü modellerle karşılaştırılabilir düzeye ulaştı. Ek deneyler, kazanımın NatureBench Lite, ajan iskelesi optimizasyonu ve algoritma optimizasyonuna da genellendiğini gösteriyor.
Genişleyen Dikkat: Sabit Durumlu Doğrusal Zamanlı Transformer
Dikkatin üstel çekirdeğini Taylor serisine açarak bağlam uzunluğundan bağımsız sabit sayıda özyinelemeli durum elde ediliyor.
Çalışma, dikkat mekanizmasının üstel çekirdeğini n terimli kesilmiş bir Taylor serisine açıyor ve her terimi tensör-kuvvet iç çarpımına çarpanlara ayırıyor. Sonuçta nedensel geçmiş, bağlam uzunluğu N'den bağımsız olarak, her token için tek bir rank-1 dış çarpımla güncellenen tam n özyinelemeli duruma indirgeniyor. Özyineleme, kesilmiş çekirdeğe göre kayıpsız (float64'te 2,2×10⁻¹⁶). Durumlar parçalar arasında toplanabilir (5,7×10⁻¹⁴) olduğundan ön doldurma paralel tarama ile yapılabiliyor. Ölçülen zaman üsleri softmax için N^2,28 iken durum tabanlı yöntemde N^0,91; kesişim N≈728'de, N=8192'de ise 20,8 kat hızlanma var. Token başına kod çözme gecikmesi sabit 7,3 µs; softmax ise N^1,04 ile büyüyor ve N=65536'da fark 76,0 kata çıkıyor. Doğruluk n arttıkça üstel biçimde iyileşirken maliyet birleşimsel olarak artıyor: m. durum C(d+m-1, m) genişliğinde ve bu SVD ile doğrulandı. Bu nedenle en uygun nokta ikinci derece, n=3: 6,5×10⁻⁴ hata ve baş başına 9.945 eleman. Sorgu ve anahtar normalizasyonu bir ön koşul; yoksa argüman yakınsama yarıçapını aşıyor ve terim eklemek fayda sağlamıyor. Bu bulgular, uzun bağlamlı modellerde softmax dikkatine hassas ve sabit bellekli bir alternatif sunuyor.
CoDA: Veri Motorları ve Eylem Politikalarının Birlikte Evrimi
Simülasyon motoru ve robot politikası ortak bellekle birlikte evriliyor; dağılım dışı başarı %5,3'ten %27,6'ya çıktı.
Üretken simülasyon robot ortamlarını otomatik kurabiliyor, ancak fiziksel olarak geçerli bir ortam eğitim için faydalı olmak zorunda değil. Asıl sorun, politikanın hatalarını hedefleyen ortamları ve onun üstesinden gelmeyi sağlayan denetimi bulmak. CoDA, bir simülasyon veri motoru ile eylem politikasının; ortam kurulumu, politika hataları ve öğrenme ilerlemesini tutan paylaşımlı heterojen bir bellek üzerinden birlikte evrildiği bir çerçeve. Bellek, bir görsel-dil eleştirmeninin doğrulanmış tanılarını, zorlukları yeniden üreten üretim programlarına ve politikanın bunları aşmasına yardım eden eğitim programlarına derliyor. Önerilen Text2potential ise bu tanıları eylem parçası değer öğrenmesi için aşamalı potansiyellere dönüştürüyor; standart ödül biçimlendirme varsayımları altında görevin en iyi politikasını koruyarak politika güncellemeleri için yoğun denetim sağlıyor. Ölçülen öğrenme ilerlemesi, sonraki üretimi ve program iyileştirmesini yönlendiriyor. Dört manipülasyon görev ailesinde dağılım dışı başarı, denetimli ince ayar sonrası %5,3'ten %27,6'ya çıktı ve aynı üretim bütçesiyle en güçlü kapalı döngü temel modeli 9,5 puan geride bıraktı. LIBERO-Pro'da 15 tur üretim ve eğitim, konum bozulmalarında başarıyı %25'ten %84'e, talimat bozulmalarında ise %1'den %76'ya yükseltti.
Intern Lumina U2: Çok Kod Kitaplı Difüzyon Dil Modeli
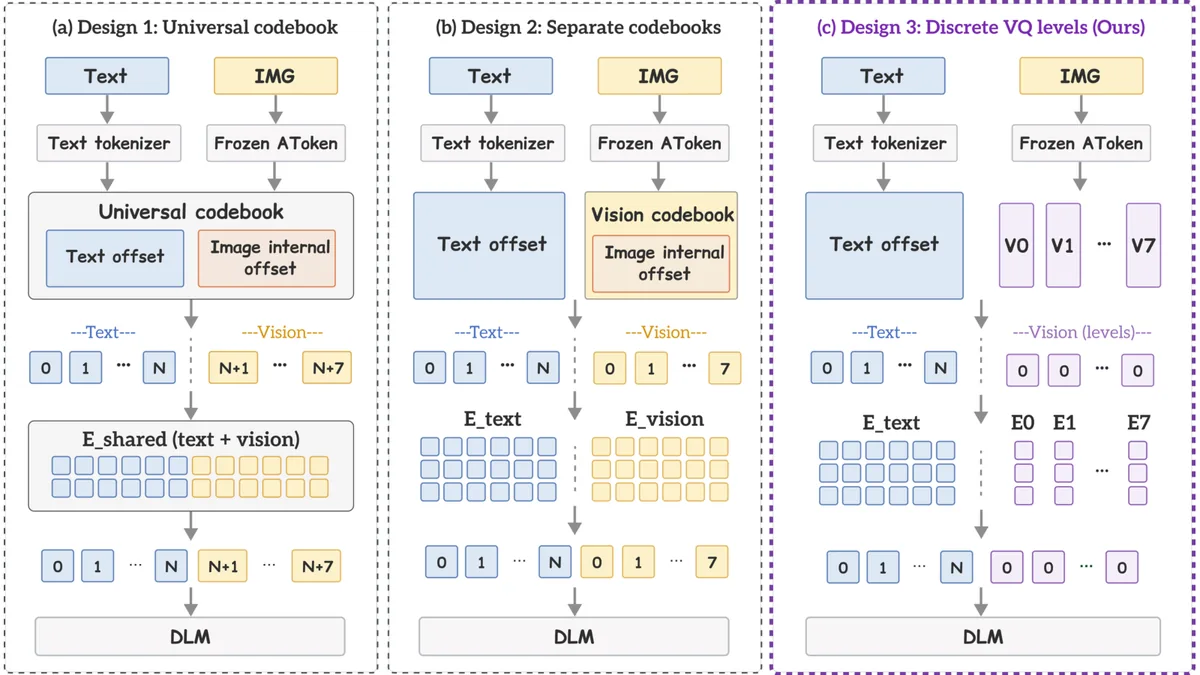
Görsel anlama ve görüntü üretimini tek omurgada birleştiren model, tamamen ayrık uzayda çok kod kitaplı görsel token'lar kullanıyor.
Çok kod kitaplı görsel token'ları omurgaya aktarmak için üç aday girdi arayüzü karşılaştırılıyor; Intern Lumina U2, sekiz kod kitabını ayrı ayrı gömüp her konumda birleştiren ve tek omurga token'ına izdüşüren üçüncü tasarımı benimsiyor. Görsel: Yu ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Birleşik çok kipli üretim ayrık, sürekli ve hibrit yaklaşımları kapsıyor. Tek kod kitaplı görsel tokenizer'lar metinle doğal uyum sağlıyor ama temsil kapasiteleri sınırlı; sürekli ve hibrit yaklaşımlar daha zengin ama metni ve görüntüyü farklı uzaylarda ve hedeflerle modelliyor, bu da kipler arasında optimizasyon çatışmasına yol açabiliyor. Intern Lumina U2, bildiğimiz kadarıyla çok kod kitaplı görsel token'ları tamamen ayrık bir uzayda temsil eden ilk difüzyon dil modeli. Her görsel konum, birbirini tamamlayan kod kitaplarından bir kod grubuyla ifade ediliyor. Girişte gömmeler her konumda birleştiriliyor; çıkışta hafif bir çok kod kitaplı otoregresif kafa konum içindeki kodları sırayla tahmin ederken, difüzyon omurgası tüm konumları paralel işliyor. AToken'ın birleşik 4D temsili üzerine kurulu model, tek omurgada görüntü, video ve 3D girdileri destekliyor ve görsel anlama, görüntü üretimi ve görüntü düzenlemede birleşik modeller arasında öncü performans elde ediyor. Ekip ayrıca Ascend ve NVIDIA platformlarında uçtan uca eğitim, çıkarım ve değerlendirme sistemi kurarak çapraz platform etkinliğini doğruladı; kararlılığa duyarlı bir örnekleme stratejisiyle çıkarım verimini de artırdı.