2026-10-19Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bu sayının ortak ipliği, yapay zekanın ekranın dışına taşınması: dokunsal robot derileri, otonom sürüşte 3B dünya modelleri ve çevrimiçi keşfeden robot ajanları, algının bedenle buluştuğu noktayı gösteriyor. Öte yandan açık dev modeller ve 16 MB'lık dondurulmuş sözlük gibi verimlilik hamleleri, bu yeteneklerin neye mal olacağını sorguluyor. Birlikte okuyunca resim netleşiyor: sıradaki sıçrama yalnızca daha büyük değil, daha duyarlı ve daha tutumlu sistemlerden gelecek.
1.Araştırma
İnsan derisinden esinlenen büyük ölçekli iyontronik robot derisi
Nature Machine Intelligence'ta yayımlanan çalışma, santimetrekareye 1.110 sensör düşen ve 10.000'den fazla birimden oluşan sinirsel-hiyerarşik bir iyontronik deri sunuyor. Sistem, insanın duyusal işleme mimarisini taklit ediyor: sinyaller katmanlar halinde kodlanıyor, birleştiriliyor ve bilişsel modellemeye aktarılıyor. Mevcut deri benzeri sensör dizileri çoğunlukla seri okuma kullandığı için eleman yoğunluğu arttıkça gecikme, sinyal karışması ve bant genişliği tüketimi ciddi sorunlara yol açıyordu. Araştırmacılar bu darboğazı, sensörlerin konumunu frekans tabanlı kodlayarak paralel iletim sağlayan bir yaklaşımla aşıyor. Böylece sinyal karışması bastırılıyor ve saniyede 100 kare hıza ulaşılıyor. Arka uçtaki yakınsak sıkıştırma ise bant genişliği tüketimini yüzlerce kat düşürüyor. Bu deriyle donatılan hümanoid robotlar, 300 µm'lik yüzey özelliklerini ayırt edebiliyor, hassas nesneleri zarar vermeden tutabiliyor ve ağrı benzeri uyarılara kendini koruyucu tepki verebiliyor. Yüksek yoğunluklu algılamanın düşük gecikme ve düşük veri yüküyle birleşmesi, bugüne kadar bu üç hedefi aynı anda yakalamakta zorlanan elektronik derilerin önündeki temel engeli kaldırıyor. Çalışma, robotların insana yakın bir dokunma algısına ve manipülasyon becerisine yaklaşması açısından önemli bir adım. Asıl sınav ise bu deri mimarisinin laboratuvar dışında, uzun süreli kullanımda ve gerçek dünya koşullarında aynı performansı koruyup koruyamayacağı olacak.
Öğrenilmiş gömme tablosunu donmuş ikili kodlarla değiştirmek boyutu küçültüyor, çoğu testte başarıyı koruyor.
Küçük dil modellerinde en büyük parça sözlüktür. Gemma 3 270M'de gömme tablosu, 268 milyon parametrenin 168 milyonunu oluşturuyor. Nicemleme yöntemleri bu tabloyu 16 bitte bıraktığı için, model sıkıştırıldıktan sonra dosyanın büyük kısmı yine ona ait kalıyor. Araştırmacı, bu tabloyu eğitilebilir parametresi olmayan, 512 bitlik kodlardan oluşan tek bir 16 MB'lık donmuş tabloyla değiştiriyor. Tablo, önceden eğitilmiş bir gömmeden temel bileşen izdüşümü ve işaret ikilileştirmesiyle bir kez türetiliyor. Aynı 2,05 milyar token üzerinde yapılan karşılaştırmada öğrenilmiş tablo, 2,6 kat daha fazla eğitilebilir parametre karşılığında 0,20 nat daha düşük doğrulama kaybı sağlıyor. Buna karşın LAMBADA, HellaSwag ve PIQA'da donmuş tablolu model daha iyi ya da eşit; yalnızca ARC-Easy öğrenilmiş tablodan yana. Üçlü (ternary) BitNet b1.58 gövdesiyle tüm model 46 MB tutuyor ve dizüstü CPU'da saniyede 615–740 token üretiyor. Donmuş tablo, nadir kelimelerde 1,7–2,3 nat avantaj sağlıyor ve eğitimden sonra eklenen 10.000 yeni kelimeyi yalnızca %3 maliyetle kabul ediyor. Öğrenilmiş tabloda aynı durumda başarı %43 çöküyor. Ağırlıklar, veri ve tüm değerlendirme yanıtları açık yayımlandı.
OPMD: Dil modeli damıtmasında çıktının ötesine geçmek
Öğretmen modelin yalnızca ne tahmin ettiğini değil, nasıl hesapladığını da öğrenciye aktaran damıtma yöntemi.
Politika içi damıtma (OPD), öğrenciyi kendi politikasından örneklenen önekler üzerinde denetleyerek dil modellerini geliştiriyor. Ancak denetim çıktı uzayıyla sınırlı kalıyor: öğretmenin neyi tahmin ettiği aktarılıyor, bu tahminleri üreten ara hesaplama ise denetlenmiyor. Ara temsilleri doğrudan eşleştirmek de yetersiz kalıyor, çünkü öğretmen ve öğrenci temsilleri geometrik olarak farklılaşabiliyor. Hizalanmış gizli durumlar bile öğrencinin sonraki hesaplamasında işe yaramayabiliyor. Önerilen OPMD, önce öğretmen temsillerini öğrencinin alt akış hesaplamasıyla uyumlu ara durumlara dönüştüren bir öğrenciyle uyumlu öğretmen kuruyor. Ardından bu durumları politika içi yörüngelerden öğrenciye içselleştiriyor. OPMD, değerlendirilen üç öğretmen-öğrenci düzeneğinin hepsinde damıtma temel yöntemleri arasında en yüksek ortalama doğruluğa ulaşıyor. Yöntem, çoklu öğretmen damıtmasına ve aileler arası denetimli ince ayara da genelleşiyor. Analizler, mekanizma denetiminin öğrencinin ara hesaplamasını ve çözüm stratejilerini anlamlı biçimde değiştirdiğini gösteriyor. Bu da yöntemin çıktı denetiminin ötesinde bilgi aktardığına işaret ediyor. Sonuçlar, mekanizma düzeyinde denetimin yalnızca daha iyi sayılar üretmekle kalmadığını, öğrencinin problemi çözme biçimini de dönüştürdüğünü ortaya koyuyor. Bu nedenle OPMD, politika içi damıtmayı bir adım ileri taşıyan ve küçük modellerin büyük modellerden daha verimli öğrenmesinin yolunu açan etkili bir çerçeve olarak öne çıkıyor.
DriveWorld3D: Otonom sürüşte kanıt kısıtlı 3B dünya modeli
Görsel gerçekçiliğin ötesinde, ölçüm kanıtına dayalı 3B dünya durumu ve üretken simülasyon öneriliyor.
Otonom sürüş için üç boyutlu modelleme; yol geometrisini, engel doluluğunu, trafik katılımcılarının davranışını ve gözlem belirsizliğini sınırlı hesaplama kaynaklarıyla sürekli kestirmek zorunda. Mevcut yeniden yapılandırma yöntemleri gerçekçi yeni görünümler üretebiliyor, ancak görsel kalite sürüş için gereken geometrik güvenilirliği yeterince yansıtmıyor. Üretken dünya modelleri senaryoları genişletip gelecek gözlemleri tahmin edebiliyor, fakat ölçümlerle desteklenmeyen içerik de üretebiliyor. DriveWorld3D, zamansal video öğrenmeyi, çoklu sensör ölçüm kısıtlarını ve çevrimdışı üretken simülasyonu birleştiriyor. Çevrimiçi bileşen; yol yüzeylerini, hacimsel doluluğu, dinamik varlıkları ve yol ilişkilerini tek bir dünya durumunda tutuyor. Fiziksel doluluk, gözlenebilirlik ve kanıt kaynağı ise ayrı temsil ediliyor. Çevrimdışı bileşen, kayıtlı sahneleri NeRF veya 3D Gaussian Splatting ile yeniden kuruyor ve nadir koşulları üretken modellerle genişletiyor. Üretilen içeriğin geometrik gerçek referans olarak kullanılması ise sınırlanıyor. Merkezî hipotez, açık kanıt yönetiminin eşit hesaplama bütçesinde tehlikeli yanlış boş alan tahminlerini ve örtülme riskini azaltabileceği. Bu ayrım, sistemin neyi gerçekten ölçtüğünü, neyi yalnızca çıkarım ya da üretim yoluyla tamamladığını açıkça işaretlemeyi mümkün kılıyor. Bu iddialar henüz deneysel doğrulamaya tabi. Doğrulanırsa yaklaşım, otonom araçların örtülmüş ya da hiç gözlenmemiş bölgelerde güvenli karar vermesi için daha güvenilir bir dünya modeli temeli sunabilir.
Beam: Sahiplenebileceğiniz 501B açık model yayında
Reflection'ın ilk modeli Beam, 1M bağlamlı, Apache 2.0 lisanslı bir uzman karışımı (MoE) olarak Hugging Face'te.
ABD merkezli yeni laboratuvar Reflection'ın ilk modeli Beam, Hugging Face'te açık olarak yayımlandı. Model, 501 milyar parametreli bir uzman karışımı (MoE) mimarisi; token başına 23 milyar parametre etkin. Girdi olarak metin alıyor, 1 milyon token bağlam penceresini destekliyor ve Apache 2.0 lisansıyla sunuluyor. Kodlama ve ajan odaklı kullanım senaryoları için tasarlanan Beam, öncü ölçekte bir modeli kendi donanımında, altyapısında ya da bulutunda çalıştırmak ve özelleştirmek isteyen ekiplere hitap ediyor. Model 52 katmandan oluşuyor; her MoE katmanında 256 uzman bulunuyor ve token başına 8'i yönlendiriliyor. Kontrol noktaları BF16, FP8 ve NVFP4 biçimlerinde mevcut. Muhakeme, konuşma turları boyunca bağlamda tutulabiliyor; beş muhakeme düzeyi (low'dan max'e) ve araç çağırma için özel bir gramer var. Beam, Rust tabanlı kendi açık kaynak harness'ıyla geliyor. transformers'ta yerel uygulaması ve vLLM ile SGLang'te ilk gün desteği bulunuyor. Spekülatif kod çözme için DFlash2 sürücü modeli de sunuluyor. Hugging Face ekibi çıkarım, SFT ve RL tarifleri hazırladı; Beam ile geliştirilen en iyi projelere 10.000 dolarlık Hub kredisi verilecek.
AMIFound: Tıbbi görüntü onarımı için hepsi-bir-arada temel model
Yedi görüntüleme kipinde gürültü ve artefaktları gideren model, 38 temel yöntemi geride bırakıyor.
Tıbbi görüntü kalitesi, güvenilir klinik tanı ve alt akış yapay zeka analizleri için kritik. Rutin görüntüler ise gürültü, hareket artefaktları, düşük kontrast ya da düşük doz çekim nedeniyle sıkça bozuluyor. Nature Machine Intelligence'ta yayımlanan çalışma, bilgisayarlı tomografi, MR, PET, endoskopi, ultrason, fundus görüntüleme ve röntgeni kapsayan AMIFound temel modelini tanıtıyor. Model, 7 temsilci bozulma türünü içeren 3,76 milyon eşleşmiş yüksek kaliteli ve bozulmuş görüntüyle eğitildi ve değerlendirildi. Paylaşılan bir kodlayıcı kip ve bozulma ipuçlarını yakalıyor. Dinamik yönlendirilen bir uzman onarım havuzu ise iyileştirme yolunu her girdi için uyarlıyor. AMIFound, 7 kipin tamamında 38 göreve özgü ve genelci temel yöntemi, tam referanslı kalite ölçütlerinde, klinisyen değerlendirmesinde ve birleşik bozulma dayanıklılık testlerinde geride bırakıyor. İyileştirilen görüntüler 44 hastalık tespit görevini, tümör evresi tahminini ve küçük hücreli dışı akciğer kanserinde sağkalım riski sınıflandırmasını da iyileştiriyor. Sonuçlar, düşük kaliteli klinik görüntülerin iyileştirilmesinde ve tıbbi yapay zeka iş akışlarının güçlendirilmesinde alana özgü bir temel modelin potansiyelini gösteriyor.
RAX: Robot ajanları için ölçeklenen çevrimiçi keşif
Kodlama ajanı, demonstrasyon verisi olmadan keşifle robot kontrol programları sentezliyor.
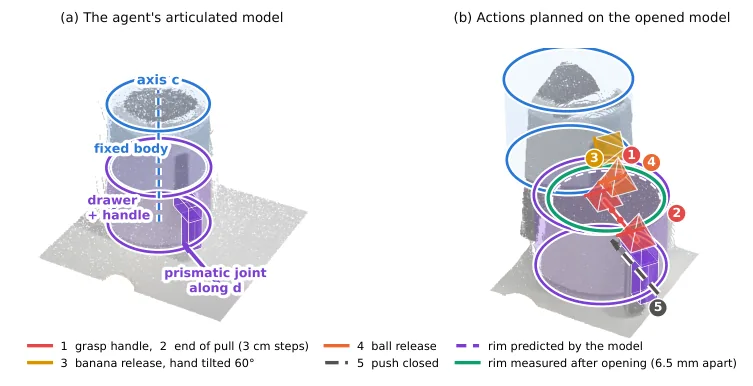
Ajan, nokta bulutu ölçümlerinden menteşeli bir hava fritözü modelini programla kuruyor ve RGB-D gözlemlere oturtarak 3B algı ve hareket planlaması için kullanıyor. Görsel: Huang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Robot öğrenmesi, demonstrasyon veri kümelerini ve model kapasitesini ölçekleyerek ilerledi. Yeni bir robot gövdesi ya da görev içinse genellikle ayrı bir teleoperasyon verisi gerekiyor ve ortaya çıkan politikalar taklit dağılımlarıyla sınırlı kalıyor. RAX (Robot Agent eXploration), keşfi ölçeklemeye odaklanan açık kaynaklı bir çerçeve. Genel amaçlı bir kodlama ajanı robot kontrol kodu üretiyor. Çalışmada eylem demonstrasyonu, elle tasarlanmış eylem ilkelleri ya da değer fonksiyonu rehberliği kullanılmıyor. Ajan çevrimiçi keşifle hedefe ulaşan karar dizilerini buluyor ve bunları algı-planlama-kontrol döngüsünü kapsayan modüler programlara derliyor. Tek kollu, çift kollu, el becerili, mobil ve hümanoid sistemlerde, simülasyonda ve gerçek robotlarda yapılan çoklu gövde çalışmasında, görülmemiş ortamlardaki genelleme keşif ölçeklendikçe tutarlı biçimde artıyor. Simülasyonda RAX, en iyi temel modelleri ortalama %37,4 farkla geçiyor. Gerçek robotlarda bellek gerektiren, mafsallı, yüksek hassasiyetli, deforme olabilen ve uzun ufuklu mobil manipülasyon görevlerini insan demonstrasyonu olmadan öğreniyor. Keşif ölçeklendikçe aktif algı, hata kurtarma, güvenlik korkulukları ve insan-robot iş birliği gibi yetenekler de ortaya çıkıyor. Yeni gövdeler yalnızca API'leri üzerinden entegre edilebiliyor.
Plan değişince hatırla: VLA modellerinde yeniden planlama güdümlü bellek
RePlanMem-VLA, politikanın kendi plan revizyonlarını görsel belleğe yazma sinyali olarak kullanıyor.
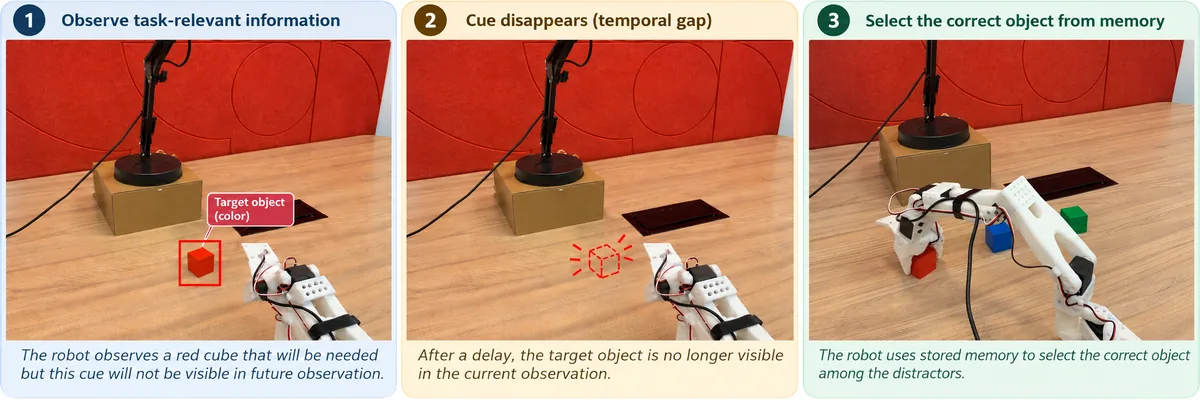
Gecikmeli ipucu görevinde robot, hedef rengi yalnızca bir an gördüğü için sonradan doğru nesneyi seçerken depolanmış görsel belleğe dayanmak zorunda. Görsel: Smelova ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Uzun ufuklu, çok aşamalı görü-dil-eylem (VLA) politikaları, mevcut gözlemde artık bulunmayan görsel bilgiye sıkça ihtiyaç duyuyor. Tüm gözlem geçmişini tutmak hem pahalı hem gereksiz tekrarlarla dolu. RePlanMem-VLA, politikanın kendi plan revizyonlarını çevrimiçi bellek yazma sinyaline dönüştürüyor. Kayan ufuklu yürütmede ardışık eylem öbekleri geleceğin aynı eylemlerinin bir kısmını tahmin ediyor. Zamansal olarak hizalanmış bu tahminler arasındaki alışılmadık büyük uyuşmazlık, göreve ilişkin önemli bir olayın işareti sayılıyor. Çalışma önce 35 uyuşmazlık ölçüsünü sıfırdan eğitilmiş otoregresif ve Flow-Matching Transformer'larda karşılaştırıyor. Seçilen sinyaller ardından MIKASA-Robo-VLA görevlerinde önceden eğitilmiş OpenVLA-OFT ve π0.5 politikalarında doğrulanıyor. Sonuçta olay dedektörleri 0,981–0,997 ROC-AUC değerine ulaşıyor. Bu sinyaller sınırlı bir görsel belleği tetikliyor. Robotu maskeleyen bir yazma filtresi de gereksiz kareleri eliyor. Bellek koruma deneylerinde RePlanMem-VLA, görevle ilgili gözlemleri sonraki karar noktasına kadar bölümlerin %100'ünde koruyor. Gerçek robot kayıtları da olay seçimi ve gereksizliği bastırmanın simülasyonun ötesinde geçerli olduğunu gösteriyor. Plan revizyonu, bir VLA'nın neyi hatırlayacağını kontrol eden politika içi bir sinyal olarak öne çıkıyor.