2026-10-21Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayıyı bir arada tutan ortak iplik, yapay zekanın artık yalnızca daha büyük değil, daha ucuz, daha seri ve hataya karşı daha dayanıklı olmayı öğrenmesi. Hassas görüden kendini geliştiren sürüş ajanlarına, çok token'lı tahminden açık çıkarım altyapısına kadar her çalışma aynı soruyu soruyor: sistemler gerçek dünyanın hızına ve belirsizliğine nasıl ayak uydurur? Bu makaleleri birlikte okumak, verimlilik ile uyarlanabilirliğin aynı hedefin iki yüzü olduğunu görmenizi sağlıyor.
1.Araştırma
EAGLE: Poligon Denetimiyle Daha Hassas Nesne Konumlandırma
Yeni hafif model başlığı, entropi temelli geometri öğrenmesiyle MS COCO'da mAP50-95'i 0,9 puan artırıyor.
EAGLE, kısmi poligon denetimiyle eğitilen nesne konumlandırma modellerinde geometrik hassasiyeti artıran, eğitim sonrası eklenen hafif bir model başlığı. Yalnızca sınırlayıcı kutularla eğitilen modeller, özellikle yüksek IoU eşiklerinde yeterli geometrik doğruluğa ulaşamıyor. Poligon maskeleri bu açığı kapatabiliyor, ancak tam anotasyonun maliyeti yüksek. Üstelik şekil karmaşıklığı düşük sınıflarda maske kaybı kutu konumlandırmasını bulanıklaştırıp performansı kötüleştirebiliyor. Araştırmacılar bu sorunu çözmek için bilgi kuramı ile istatistiksel şekil analizini birleştirerek sınıf başına geometrik karmaşıklığı ölçen bir çerçeve geliştirmiş. EAGLE bu çerçeveden aldığı entropi bilgisiyle kenarları iyileştiriyor ve konumlandırma skorlarını yeniden ayarlıyor. MS COCO ve Pascal SBD üzerindeki deneyler, entropi çerçevesinin şekil yeniden yapılandırma hatasını anlamlı biçimde öngördüğünü gösteriyor. EAGLE, zaten son teknoloji olan tespit çerçevelerinde MS COCO'da +0,9 mAP50-95 iyileşme sağlıyor ve çıkarım yükü ihmal edilebilir düzeyde kalıyor. Bu sonuç, mevcut dedektörlerin yeniden tasarlanmasına gerek kalmadan, yalnızca eğitim sonrası eklenen küçük bir başlıkla elde ediliyor. Kısmi poligon etiketiyle yetinen bu yaklaşım, anotasyon bütçesi sınırlı ekipler için de cazip bir seçenek sunuyor. Böylece çalışma, tam poligon anotasyonu olmadan hassas konumlandırma isteyen görü sistemleri için pratik ve düşük maliyetli bir yol sunuyor.
ECHO, gelecek token tahminini omurganın kendi son katmanına taşıyarak ek modül maliyetini ortadan kaldırıyor.
ECHO (Efficient Causal Self-Recursion), çoklu token tahmini (MTP) yöntemlerinin yardımcı modül bağımlılığını ortadan kaldıran yeni bir yaklaşım. Mevcut MTP yöntemlerinde çok ufuklu kayıp çoğunlukla omurgaya bağlı ek modülleri eğitiyor ve her yeni ufuk bir modül ile bir geçiş daha demek. ECHO'da ise omurganın kendi son katmanı tüm ufukları tahmin ediyor; böylece denetim, bir sonraki token'ı üreten parametrelere doğrudan ulaşıyor. Dinamik Derinlik Örnekleme (DDS), eğitim derinliğini derinlikle azalan olasılıklarla seçerek daha derin ufukları ucuz tutuyor. Ön eğitimde eklenen derinlik, yardımcı modüllerin doygunluğa ulaştığı yerde bile aşağı akış doğruluğuna dönüşüyor; kazanç özellikle akıl yürütme ve kodda yoğunlaşıyor ve eğitim yükü, her derinliği eğitmenin yarısı kadar. Çıkarımda ise ön eğitimli model kendi taslak üreticisi olarak çalışıyor, eğitildiği derinliğin ötesinde de taslak çıkarabiliyor ve sonradan eğitilen taslak üreticilerin zorlandığı açık uçlu, yüksek entropili üretimde hizalamasını koruyor. Yazarlar avantajın iki kat token bütçesi, tekrarlanan ön eğitim ve denetimli ince ayar sonrasında da sürdüğünü bildiriyor. Yöntem 200B-A13B ölçeğinde üretimde kullanılıyor.
Gizli dünya modeli, dağıtım sonrası deneyimlerden öğrenen sürüş sistemi için yansıma sinyalleri üretiyor.
EvoAD, uçtan uca otonom sürüş sistemlerinin dağıtım sonrasında insan sürücüler gibi deneyimle gelişmesini hedefleyen bir çerçeve. Mevcut sistemler yola çıktıktan sonra genellikle donmuş kalıyor; benzer sahnelerde aynı kararları tekrarlıyor ve hatalar ancak maliyetli veri toplama ve yeniden eğitimle giderilebiliyor. EvoAD, sürüş deneyimlerini kuş bakışı özellik belleğinde saklıyor, geometrik ve semantik benzerliğe göre ilgili örnekleri çekiyor ve aday yörüngelerin gelecekteki sonuçlarını planlamaya odaklı sıkıştırılmış bir uzayda gizli dünya modeliyle değerlendiriyor. Belleği harici metin bağlamı olarak kullanmak veya dünya modellerini yalnızca eylem öncesi simülasyonda çalıştırmak yerine, yürütülen sürüş sonuçlarını gelecek kararlar için yeniden kullanılabilir iyileştirme sinyallerine dönüştürüyor. Böylece sistem, önceki yörüngelerin nasıl daha iyi olabileceğini teşhis edip temel sürüş politikasını yeniden eğitmeden benzer gelecek senaryolarda davranışını inceltebiliyor. NAVSIM v1 ve v2 deneylerinde yansıma turları boyunca tutarlı iyileşmeler ve en gelişmiş sonuçlar elde edilmiş. Bu yaklaşımın en dikkat çekici yanı, ağırlıkları güncellemeden yalnızca deneyim belleği ve dünya modeli üzerinden iyileşme sağlaması. Çalışma, dünya modellerinin dağıtım sonrası kendini geliştirmede yansıtıcı bir mekanizma olarak kullanılabileceğini gösteriyor ve sürekli öğrenen sürüş sistemlerine giden yolda somut bir adım sunuyor.
DexGraspFlow: Farklı Robot Ellerine Tek Kavrama Modeli
Topoloji farkındalıklı akış eşleştirme, üç robot elinde %95,33 simülasyon başarısı sağlıyor.
DexGraspFlow, farklı el geometrilerine ve eklem yapılarına sahip robot elleri için ortak bir beceri tutma üretimi sunan, link düzeyinde koşullu SE(3) akış eşleştirme çerçevesi. Çapraz gövde kavramada temel zorluk, linkler arası uzamsal ilişkilerin elin kinematik topolojisini tek başına yakalayamaması. Model yerel nesne geometrisini, link geometrisini ve mevcut pozları kodluyor. İkili akışlı bir DiT, linkler arası koordinasyonu ve link-nesne etkileşimini modellerken, kinematik ağaç mesafelerinden türetilen dikkat yanlılıkları yapısal bilgiyi açıkça ekliyor. Model ötelenme ve dönme hız alanlarını birlikte öğreniyor, bunları entegre ederek link pozlarını üretiyor ve eklem konfigürasyonlarını ters kinematikle elde ediyor. Çıkarım sırasında avuç içi yönelim rehberliği, yeniden eğitim gerektirmeden kontrollü kavrama üretimine imkân tanıyor. Üç robot eli ve 30 nesne-el çiftinde ortalama %95,33 simülasyon başarısı elde edilmiş; ters kinematik dahil üretim gecikmesi, en iyi referans yönteme göre yaklaşık %49 daha düşük. Model ayrıca yedi parmak çıkarılmış varyanta sıfır-örnekle uyum sağlıyor ve gerçek robotta 100 denemede %91 başarı sunuyor. Bu sonuçlar, tek bir modelin farklı el tasarımları arasında yeniden eğitim olmadan genellenebildiğini gösteriyor. Robotik el çeşitliliğinin hızla arttığı bir dönemde bu esneklik, her yeni donanım için ayrı kavrama modeli geliştirme maliyetini ciddi biçimde azaltabilir.
DeepSeek, Üretim Çıkarım Altyapısı DeepInfer'i Açık Kaynak Yaptı
DeepSeek, günde 155T token işleyen çıkarım yığınını açtı; tahmini marj yüzde 80'in üzerinde.
DeepSeek, DeepSeek-V4.1-Flash'ı ölçekli olarak çalıştıran kendi çıkarım çerçevesi DeepInfer'i açık kaynak olarak yayımladı. Sistem, vLLM'nin özelleştirilmiş bir sürümü; SGLang ve TensorRT-LLM'e atıf yapıyor ve 72 saate kadar istem önbelleklemesi sunuyor. Ancak şirketin en değerli parçaları, yani ultra optimize KV önbelleği, ön doldurma/kod çözme ayrıştırması ve yük dengeleme açık kaynağa dahil değil. Şirketin paylaştığı üretim verilerine göre ön doldurma GPU'su başına saniyede 1,5 milyon önbellek dahil girdi token'ı işleniyor, girdi önbellek isabeti %96, kod çözme GPU'su başına saniyede 14.000 çıktı token'ı üretiliyor. Fiyatlar milyon token başına 0,15/0,60 dolar. Latent Space'in hesaplarına göre günde 155T token, tepe dışı fiyatlarla kart başına saatte yaklaşık 38 dolara denk geliyor; kart başına 5-8 dolarlık toplam maliyetle çıkarım marjı yüzde 80'in üzerinde. Hesap, gigawatt başına yaklaşık 166 milyar dolar ve 81 günlük geri ödeme süresi veriyor. Yayın, Fireworks, Baseten ve Modal gibi kapalı kaynaklı oyuncuların hakim olduğu çıkarım altyapısı alanında açık kaynaklı bir karşılık anlamına geliyor.
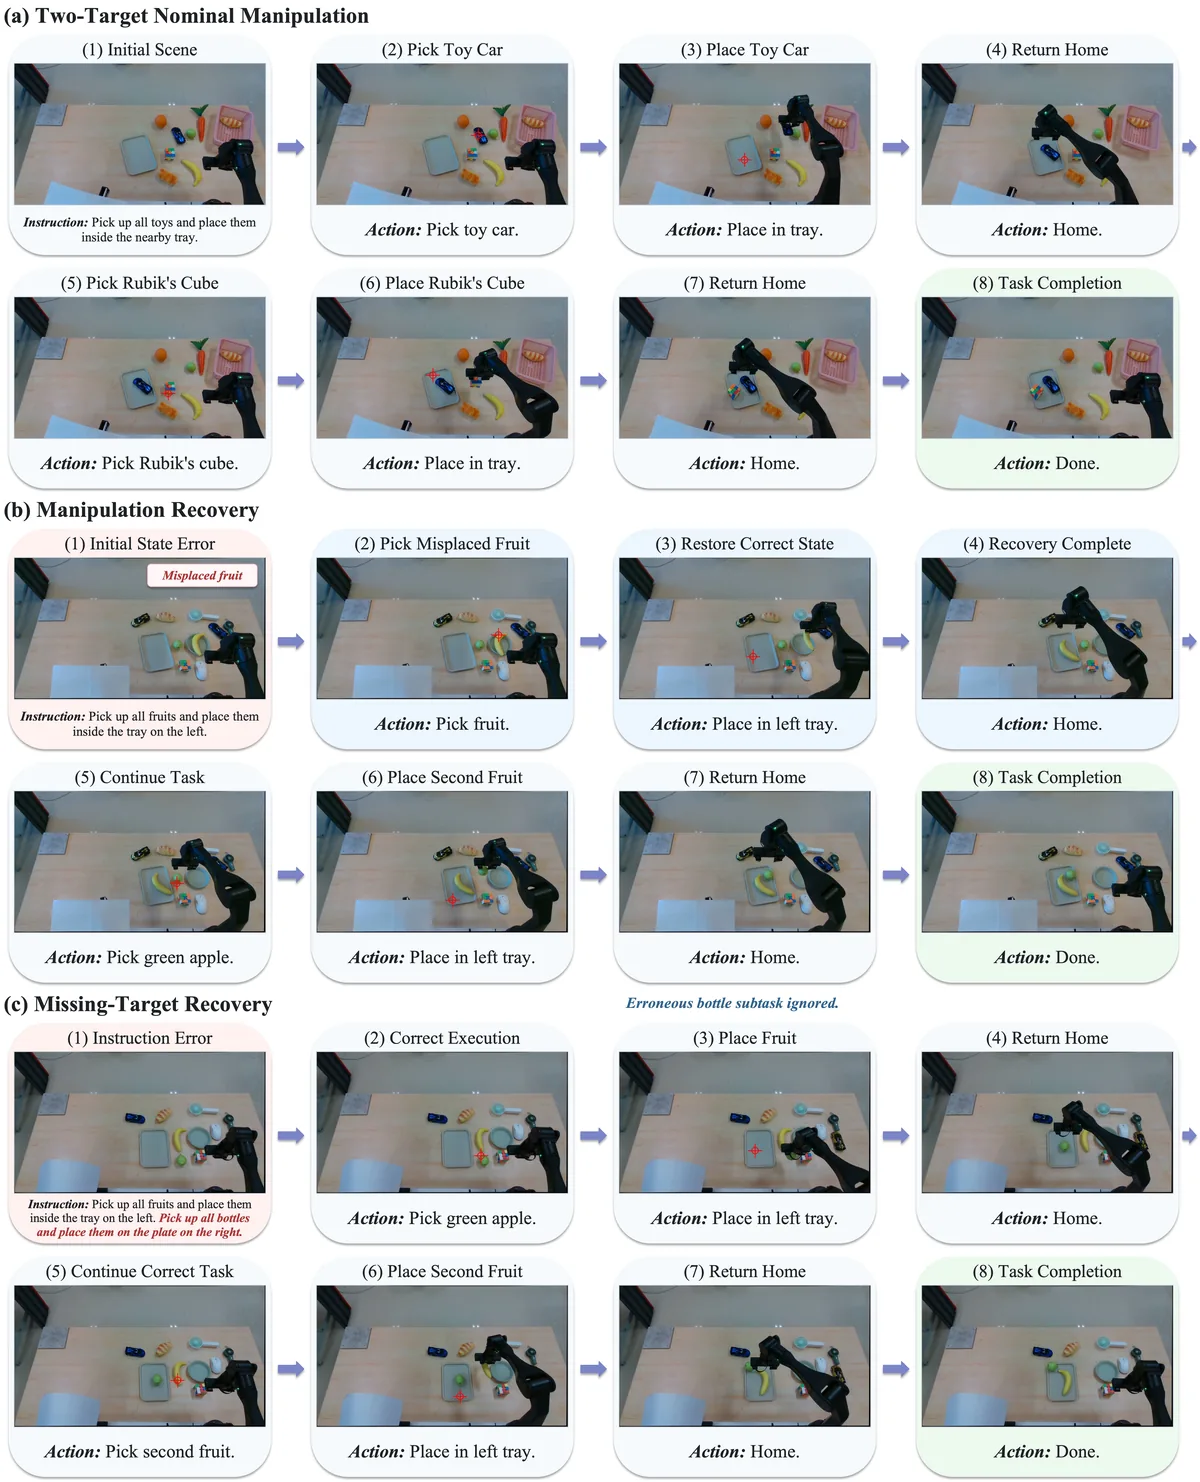
Hatadan Dönüş: Somutlaşmış VLM'lere Yeniden Planlama Öğretmek
AGT-GSPO, 2B parametreli VLM'in hatadan kurtarma oranını 22,95 puan artırıyor.
Gerçek robot denemeleri, AGT-GSPO ile eğitilen modelin yanlış yerleştirilen meyveyi düzeltip görevi sürdürdüğünü ve mevcut olmayan şişe alt görevini atlayarak uygulanabilir yerleştirmeyi tamamladığını gösteriyor. Görsel: Wang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Bu çalışma, manipülasyon görevlerinde yürütme hatası sonrası ortamın kurtarma için yeniden planlama gerektiren durumlara düştüğü senaryoyu ele alıyor. Mevcut kurtarma yöntemleri ya sabit politikalı çıkarım zamanı mekanizmalarına dayanıyor ya da doğrulanmış eylem sonuçları yerine başarısızlık örneklerinden ve referans düzeltmelerden öğreniyor. Araştırmacılar doğrulanabilir etkileşimle öğrenmeyi mümkün kılmak için görev ilerlemesi ve yürütme hatası geri bildirimi sunan ERR-Env ortamını ve nominal, ara ve hata durumlarını kapsayan ERR-Bench kıyaslamasını geliştirmiş. Önerilen AGT-GSPO, görev ilerlemesi ve hata durumları için tur düzeyinde ödülleri eylem gruplu avantaj tahminiyle birleştiren çevrimiçi bir pekiştirmeli öğrenme yöntemi; bununla kompakt 2B parametreli ERR-VLM eğitilmiş. ERR-Bench değerlendirmesi, farklı VLM'lerde görev ilerlemesi ile yürütme güvenilirliği arasında bir uyumsuzluk olduğunu ortaya koyuyor. AGT-GSPO, hatasız tamamlama için Strict Success Rate'i 10,25 puan, Recovery Rate'i ise 22,95 puan yükseltiyor. Ablasyonlar ve sıfır-örnekle aktarım deneyleri yöntemin etkinliğini doğruluyor. Küçük bir modelin hem ilerleme hem de güvenilirlik açısından daha büyük modellerle rekabet edebilmesi, hedefli eğitimin ölçekten daha belirleyici olabileceğini düşündürüyor. Çalışma, somutlaşmış ajanlarda hata kurtarmanın doğrulanabilir etkileşimle eğitilebileceğini gösteriyor.
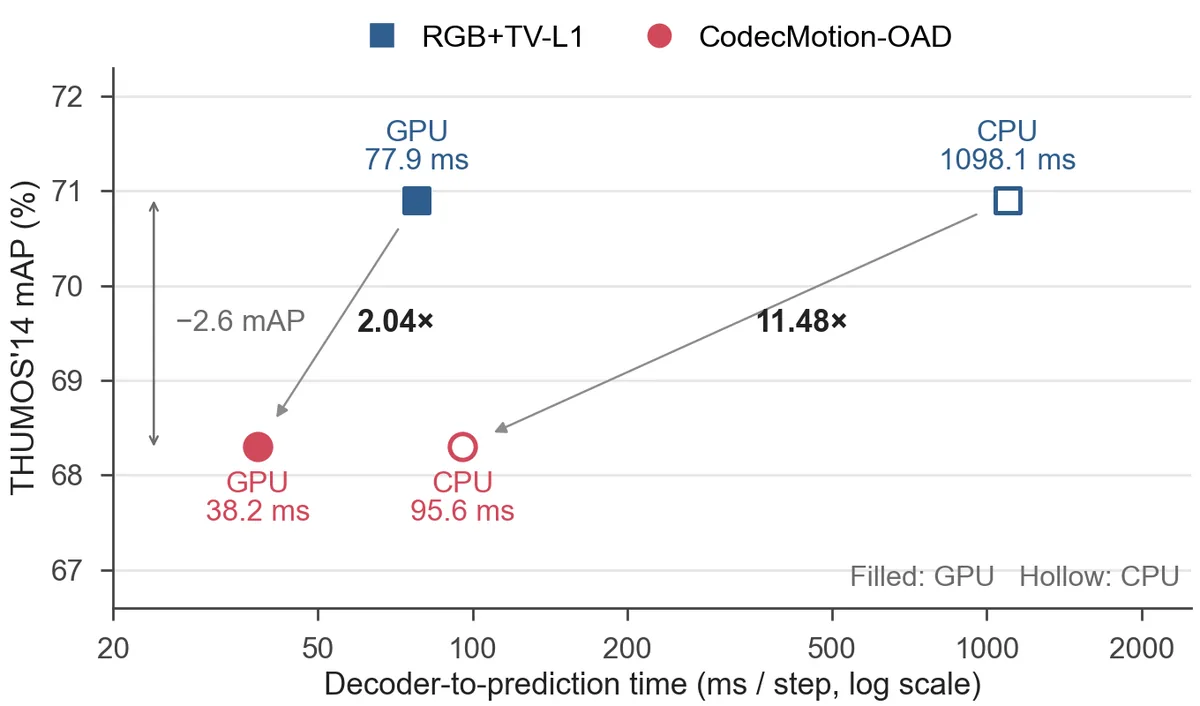
CodecMotion-OAD: Optik Akış Yerine Codec Hareket Vektörleri
Çevrimiçi eylem tespitinde işlem süresi CPU'da 11,48 kat, GPU'da 2,04 kat kısalıyor.
CodecMotion-OAD, 68,3 mAP ile RGB+TV-L1'in 70,9 mAP'ine yakın kalırken işlem süresini GPU'da 2,04 kat, CPU'da 11,48 kat azaltıyor. Görsel: Sun ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
CodecMotion-OAD, akış halindeki videolarda süren eylemleri tespit eden çevrimiçi eylem tespiti (OAD) sistemlerinde yoğun optik akış hesaplamasını codec hareket vektörleriyle (MV) değiştiriyor. Mevcut sistemler genellikle RGB görünümünü optik akışla birleştiriyor, ancak akış çıkarımı büyük bir hesaplama darboğazı. MV'ler ise video çözme sırasında zaten hazır; ayrı bir akış hesabı gerekmiyor. THUMOS'14'te yalnızca hareket girdisiyle optik akış MV'lerden 11,2 mAP puan üstün; RGB birleşiminden sonra fark 3,7 puana iniyor. Yöntem, mevcut zamansal dedektör mimarilerini koruyup akışı MV ile değiştiriyor. İki aşamalı eğitimde önce MV özellikleri, eylem etiketi kullanmadan önceden eğitilmiş akış özellik arayüzüne hizalanıyor, ardından RGB+MV dedektörleri gerçek etiketlerle ve dondurulmuş RGB+Flow öğretmeninin yumuşak tahminleriyle eğitiliyor. Yazarlar, codec MV'lerin kare düzeyinde OAD'a ilk uygulanışı olduğunu belirtiyor. THUMOS'14'te MiniROAD ile 68,3 mAP elde ediliyor; eşleşen damıtımlı RGB+Flow'un 70,9 mAP'ine karşılık, çözücüden tahmine işlem süresi CPU'da 11,48 kat, GPU'da 2,04 kat azalıyor. Doğruluktaki küçük kayıp, özellikle sınırlı donanımlı uç cihazlar ve düşük gecikme gerektiren akış uygulamaları için hız kazancıyla rahatlıkla dengeleniyor.
ElevenLabs'ten İki Yeni Gerçek Zamanlı Konuşma Modeli
Eleven Realtime v1 Max, 0,57 saniyelik yanıt süresiyle Big Bench Audio'da yüzde 98,8 doğruluğa ulaşıyor.
ElevenLabs, gerçek zamanlı yapay zeka konuşmaları için tasarlanmış iki yeni konuşmadan konuşmaya modeli olan Eleven Realtime'ı yayımladı. Max varyantı, Big Bench Audio kıyaslamasında yüzde 98,8 doğruluk ve 0,57 saniyelik yanıt süresi elde ediyor. Şirket, Artificial Analysis liderlik tablosunda şu anda hem daha hızlı hem de daha doğru başka bir model bulunmadığını söylüyor. Daha küçük v1 Mini, düşük maliyetle doğal konuşmalar için geliştirilmiş; bir kişinin konuşmayı bitirdiğini ya da yalnızca onay sesi çıkardığını ayırt edebiliyor. V1 Max ise müşteri desteği gibi daha karmaşık görevleri hedefliyor. Her iki model de ElevenAgents platformu ve OpenAI uyumlu bir Realtime API üzerinden sunuluyor. Fiyatlandırma dakika başına ücret ve token maliyetinden oluşuyor; v1 Max, v1 Mini'den daha pahalı. OpenAI uyumlu arayüz, mevcut sesli ajan uygulamalarını kullanan geliştiricilerin geçiş maliyetini düşürebilir. Konuşma sırasını doğru algılama yeteneği de doğal diyalog hissi için kritik bir fark yaratıyor. Sesli ajanlarda en büyük sorunlardan biri gecikme: yanıt birkaç yüz milisaniyeyi aştığında kullanıcı akışın bozulduğunu hissediyor. Sistem bu eşiğin altında kalırken yüksek doğruluğu koruyabiliyor. Lansman, sesli ajan uygulamalarında hız ile doğruluk arasındaki tercihi azaltmayı amaçlıyor.