2026-10-22Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayının ortak ipliği, robotik ve görü alanında ilerlemenin artık yalnızca daha büyük modellerden değil, daha iyi ölçüm, daha ustaca bileşim ve daha zengin veriden geldiği gerçeği. Uzun ufuklu kıyaslamalardan sanal dünyalarda ölçeklemeye, 3B hizalamadan iki elli beceri takibine uzanan çalışmalar, fiziksel dünyada çalışan ajanların hangi darboğazlarda tıkandığını gösteriyor. Düzenleyici denetimlerle birlikte okununca, sahada neyin mümkün, neyin sorumluluk gerektirdiğini aynı çerçevede görmek mümkün.
1.Araştırma
Embodied Playground: Uzun Ufuklu Robot Ajanları İçin Yeni Kıyaslama
410 ortamlık yeni benchmark, temel model ajanlarının uzun görevlerdeki akıl yürütmesini ölçüyor.
Araştırmacılar, temel model tabanlı robot ajanlarının fiziksel, stratejik ve uzamsal akıl yürütmeyi uzun görev süreleri boyunca ne kadar tutarlı sürdürebildiğini ölçen Embodied Playground adlı bir benchmark geliştirdi. Ajanların görev ilerleyişini izlemesi, ara kısıtları karşılaması ve yürütme geri bildirimini kullanarak planlarını revize etmesi gerekiyor; çünkü önceki eylemler sonraki kararları doğrudan şekillendiriyor. Ortam; temel manipülasyon, sıralı bulmacalar ve çok aşamalı ev içi etkinlikleri kapsayan 410 görev ortamından oluşuyor ve planlama derinliği, geometrik kısıtlar ile fiziksel yürütme talepleri açısından çeşitlilik sunuyor. Ekip ayrıca beş paket ve 16 görev türünden seçilen 100 görevlik EP-100'ü, EP-Easy ve EP-Hard zorluk bölünmelerini ve kompakt EP-20 seçkisini derledi. Ortak protokol; gözlem ve araç erişimini, kaynak bütçelerini, tekrarlı denemeleri ve hedef tamamlama, kural uyumu ile fiziksel geçerlilik için bağımsız denetimleri tanımlıyor. Böylece farklı ajanlar aynı koşullar altında adil biçimde karşılaştırılabiliyor. Foundation model ajanlarının kısa demolardan öteye geçip uzun ufuklu görevlerde gerçekten güvenilir olup olmadığını tutarlı biçimde karşılaştırmak için ortak bir zemin sağlıyor.
Skor dekorelasyon kaybı, difüzyon politikası bileşenlerini birbirinden farklı işlevlere yönlendiriyor.
Doğrusal olarak birleştirilen skorlara sahip difüzyon politikaları, çok görevli robot öğrenmesinde modüler adaptasyon ve kompozisyonel genelleme vaat ediyor. Ancak mevcut eğitim hedefleri bileşenlerin uzmanlaşmasını teşvik etmiyor; sonuçta birleşik tahmin, birbirinin aynısı olan kopyaların ortalamasına dönüşüyor ve mimarinin temel varsayımı boşa çıkıyor. Araştırmacılar bu soruna, projektif kompozisyon teorisinden esinlenen ve mevcut sistemlere kolayca eklenebilen bir skor dekorelasyon yardımcı kaybıyla yanıt veriyor. Yöntem, bileşenlerin gürültü tahminleri arasındaki örtüşmeyi doğrudan cezalandırıyor. Böylece her bileşen, ortak bir ortalamaya yakınsamak yerine görevin farklı bir yönünü öğrenmeye zorlanıyor. Yaklaşımın en dikkat çekici yanı ise pratikliği: mimaride yalnızca küçük değişiklikler gerektiriyor ve ek hesaplama yükü de düşük kalıyor. Birden fazla benchmark'ta yapılan deneylerde dekorelasyon kaybı, bileşenler arasındaki ölçülebilir çift sayımı azaltıyor, görev ayrıştırmasını iyileştiriyor ve davranışsal olarak anlamlı uzmanlaşma üretiyor. Üstelik bunların hiçbiri çok görevli performanstan ödün verilerek elde edilmiyor. Bu sonuçlar, bileşenlerin gerçekten farklı roller üstlendiğini gösteriyor. Önemi de burada yatıyor: kompozisyonel politikaların hem yorumlanabilirliği hem de gerçek modülerliği artıyor. Bir bileşenin hangi beceriyi temsil ettiği daha net okunabilir hale gelebilir; yeni görevlere uyum sağlarken parçaları yeniden birleştirmek de daha güvenilir olabilir. Bu da çok görevli robot öğrenmesinde daha şeffaf ve daha sağlam bir yolun kapısını aralıyor.
Register Anything Model: Tek Modelle Genellenebilir 3B Hizalama
RAM, iç mekân, dış mekân ve nesne alanlarında 6-DoF nokta bulutu hizalamasını tek modelle yapıyor.
Register Anything Model (RAM), farklı sensörleri ve ortamları kapsayan alanlarda 6-DoF dönüşümleri güçlü biçimde tahmin eden birleşik bir 3B nokta bulutu hizalama modeli. Mevcut yöntemler genellikle tek bir alana göre özenle ayarlandığından yeni alanlarda belirgin biçimde bozuluyor. Ekip bu açığı, iç mekân, dış mekân ve nesne verilerinden oluşan çeşitli bir kümede tek model eğiterek kapatıyor. Asıl zorluk, sahne ölçeği, sensör gürültüsü, nokta yoğunluğu ve yapısal örüntülerdeki büyük geometrik farklılıklardı. Bunun için nokta bulutlarını geometrik özelliklerine göre uyarlanabilir biçimde voxelleştirip standart bir geometrik uzaya normalleştiren bir strateji geliştirildi; böylece belirgin yerel yapılar korunurken çözünürlük standartlaşıyor. Model, hiyerarşik bir kabadan ince aşamaya paradigmasını izliyor ve tüm noktalar üzerinde küresel dikkat yerine yerel geometrik tutarlılığı modelleyen verimli bir geometrik transformer kullanıyor. 12 benchmark'ta inlier oranı ve hizalama recall'ı açısından state-of-the-art sonuçlar elde edilirken, her alanda ayrı eğitilen rakiplerin de önüne geçiliyor. Tek bir modelin bu kadar farklı alanda güçlü kalabilmesi, genelci kayıt sistemleri için önemli bir adım. NeurIPS 2026'da kabul edilen çalışmanın kodu ve modelleri açık.
120 eğitim konfigürasyonu, sürekli ön eğitimde veri, çeşitlilik ve model boyutunun etkisini ölçüyor.
Veri, çeşitlilik ve model kapasitesini ölçeklemenin fiziksel ortamlardaki somutlaşmış öğrenmeyi iyileştirdiği biliniyor; ancak bu kazanımların farklı görsel stil, dinamik, kontrol ve hedeflere sahip sanal dünyalara taşınıp taşınmadığı belirsizdi. Çalışma, sürekli ön eğitimi (CPT) veri hacmi, çeşitlilik ve model boyutu eksenlerinde kontrollü biçimde inceliyor: 0,8B–27B arası dört model boyutu, 50–1.600 saat arası altı veri bütçesi ve yalnızca Minecraft'tan çok dünyalı derlemlere uzanan beş karışımla toplam 120 konfigürasyon. Bulgulara göre daha fazla veri, korpus içi performansı artırıyor; çeşitlilik ilişkili dünyalara aktarımı iyileştirirken uzak dünyalarda sınırlı kalıyor; model boyutu ise veri verimliliğini yükseltiyor ama tek dünyalı eğitimde uzak dünyalara daha kötü genelleniyor. Ekip, geniş çapta fayda sağlayan erken bir arayüz aşaması ile kazanımların daraldığı sonraki bir dünya aşaması gözlemliyor ve doğrulama kaybını veri hacmi, çeşitlilik ve model boyutuyla ilişkilendiren ampirik bir ölçekleme yasası uyduruyor. Modeller 3B dünyalarda Minecraft uzmanları ve frontier modellerle rekabet ediyor, gerçek zamanlı senaryolarda en iyi sonucu veriyor. Yine de taklidin sınırları ve uzak dünyalardaki kalıcı açıklar, genelci ajanlar için sürekli ön eğitimin ötesinde daha zengin eğitim aşamaları gerektiğini gösteriyor.
Yeni yöntem, sürüş videosu düzenlemelerinde yapısal halüsinasyonları ve zamansal şoku önlüyor.
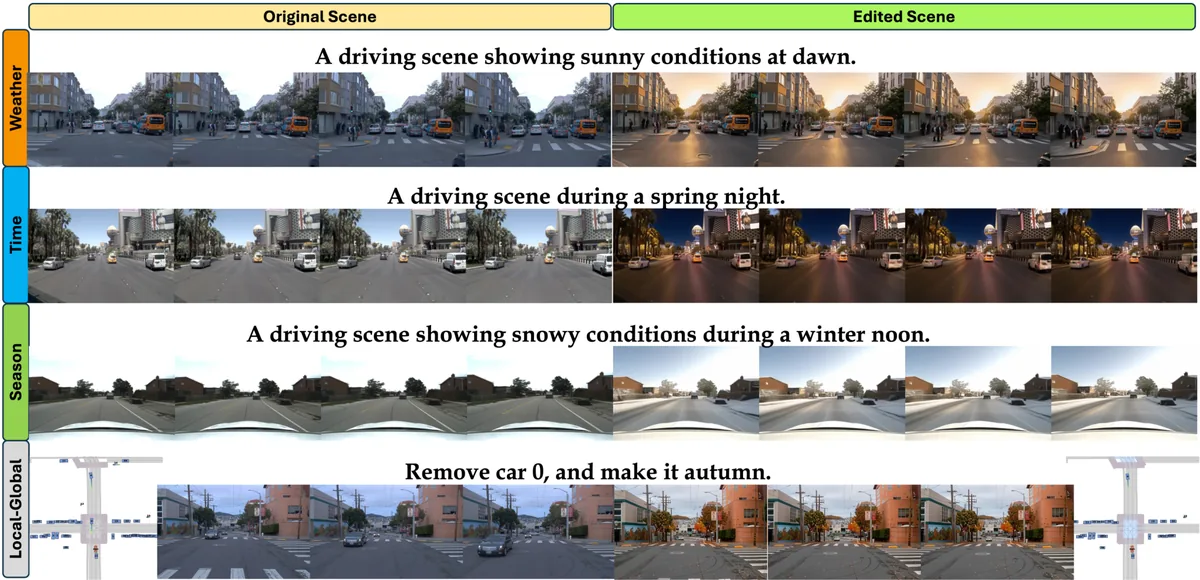
HorizonComposer, genel görünüm düzenlemeleri sırasında karmaşık trafik semantiğini koruyor; bu da düzenlemelerin art arda uygulanabilmesini sağlıyor. Görsel: Soroco ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Talimat güdümlü video üretim modelleri, çeşitli çevre koşullarını simüle ederek otonom sürüş sistemlerini stres testine tabi tutmak için ölçeklenebilir bir yol sunuyor. Ancak sürüş sahneleri, katı trafik semantiğiyle yönetilen yoğun bir Operasyonel Tasarım Alanı içinde işliyor ve genel amaçlı video editörleri küresel koşul düzenlemelerinde bu semantiği bozarak yapısal halüsinasyonlara ve zamansal şoka yol açıyor. HorizonComposer bu semantiği üç düzeyde koruyor. Önce, zamansal olarak hizalı gerçek videolar ile sentetik düzenlemeler birleştirilerek hibrit bir veri kümesi kuruluyor. İkinci olarak, eğitimde çevrimdışı pekiştirmeli öğrenmedeki avantaj koşullandırması uyarlanıyor: hibrit veriden çıkarılan yoğun, piksel düzeyindeki ödüller, üretimi yapısal olarak güvenilir piksellere yönlendiriyor. Üçüncü olarak, statik görüntü koşullandırmasını dinamik video bağlamıyla uzlaştıran düşünme kareleri (thinking frames) mekanizması zamansal şoku azaltıyor. Yöntem, çok aktörlü dinamiklerin bozulmasını önleyerek state-of-the-art uzamsal-zamansal tutarlılık sağlıyor: içerik korumada %39, zamansal tutarlılıkta %12 göreli kullanıcı tercihi artışı, ayrıca yol çizgisi segmentasyonunda %5 ve çoklu nesne tespitinde %7 kazanç. Bu iyileşmeler, sentetik senaryoların sürüş sistemlerini test etmede daha güvenilir hale geldiğini gösteriyor.
Açık Model Ekosisteminde Yeni Düzenleyici Denetimler
ABD ve Çin, açık ağırlıklı yapay zeka modelleri için denetim mekanizmalarını devreye sokuyor.
Açık ağırlıklı yapay zekanın jeopolitiği bu sonbaharda yeniden hız kazanıyor. Çin Ticaret Bakanlığı (MOFCOM), frontier yapay zeka modellerinin uluslararası paylaşımdan önce hükümet onayı almasını öngören bir politika önerisi yayımladı; ancak öneride açık kaynak teknolojiler için otomatik onay öngörüldüğünden tepkiler abartılı bulunuyor, yine de çerçeve gelecekte Çin yapay zeka sektörünü düzenlemek için kullanılabilir. ABD İç Güvenlik Bakanlığı (DHS) ise DeepSeek'i ve modellerini federal sivil tedarikten men eden bir emir yayımladı; ince ayarlı veya DeepSeek çıktılarıyla eğitilmiş modellerin durumu belirsiz. Yerli bir açık model ekosisteminin gerekliliği bir kez daha öne çıkıyor. DeepSeek ayrıca dahili çıkarım yığınını DeepInfer adıyla açtı; vLLM ve SGLang'den belirgin biçimde verimli olduğu tahmin ediliyor ve token satışında yaklaşık %90 brüt marj sağladığı düşünülüyor. Çıkarım şirketleri bu araçları hızla benimseyecek, bu da DeepSeek modellerinin fiyatlarını ekosistemde aşağı çekecek. Bu adım, önde gelen bir laboratuvarın çıkarım araçlarını ilk kez paylaşması olarak açık kaynak yapay zeka için önemli bir sinyal. Politika ve teknoloji cephesindeki bu gelişmeler birlikte, açık modellerin hem düzenleyici hem de ekonomik açıdan yeniden şekillendiğini gösteriyor.
Tek bir politika, iki robot eliyle insan gösterimlerini izleyip görülmemiş nesnelere genelleniyor.
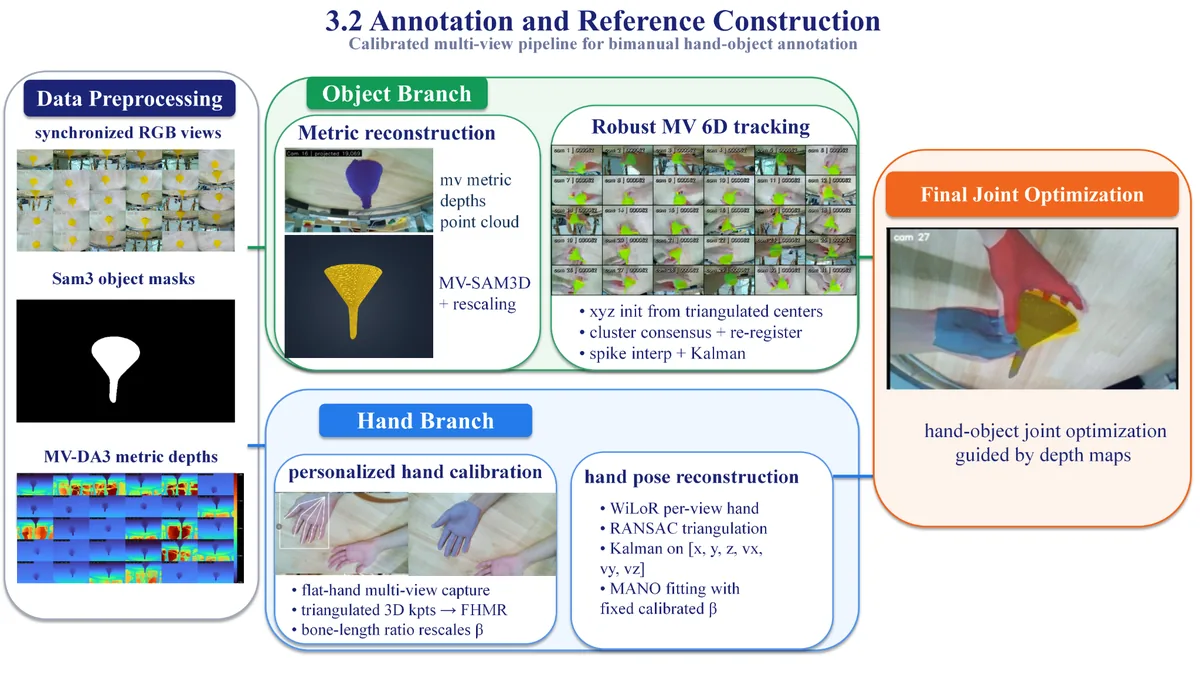
Eşzamanlı çok görüşlü RGB gözlemlerinden SAM3 nesne maskeleri ve metrik derinlik elde ediliyor; nesne kolu 6D takip, el kolu ise katılımcıya özgü el takibi yapıyor. Görsel: Sun ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
El becerisi odaklı referans takibindeki ilerlemeler büyük ölçüde tek elli manipülasyona odaklanıyordu; günlük hayattaki iki elli beceri davranışları ise çözümsüz kalmıştı. DONIC, farklı operasyon kategorileri ve insan hareket kaynakları üzerinde ortak eğitilen ilk genelci iki elli takipçi. Ekip ayrıca, 229 nesne üzerinde 1.575 diziyi kapsayan ve sürekli iki elli etkileşimi vurgulayan çok görüşlü BiHOI veri kümesini sunuyor; yeniden yapılandırılan etkileşimler robot referanslarına dönüştürülüyor. DONIC, proximal policy optimization ile davranış klonlamayı bir geri bildirim döngüsünde birleştiriyor: doğrulanmış başarılı yürütmeler eğitim gösterimi olarak geri dönüştürülüyor. Nesne merkezli, el başına ödül, her eli referans temas rolüne göre denetlerken nesne hareketi geri bildirimini koruyor. Clip-Centered Advantages ise referansa bağlı avantaj ofsetlerini kaldırırken yörünge içi farkları muhafaza ediyor. İnce ayar olmadan tek bir checkpoint, eğitim nesnelerinin görülmemiş yörüngelerinde %86,79, tutulan nesnelerde %57,32 başarı elde ediyor ve en iyi iki elli takip baseline'larını sırasıyla 77,36 ve 45,73 puan geride bırakıyor. Bu fark, genelci bir iki elli takipçinin görülmemiş nesnelere de genelleyebildiğini ve robotik manipülasyonda önemli bir boşluğu doldurduğunu gösteriyor.