2026-10-23Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünün sayısını bir arada tutan ortak ilke şu: iyi görmek ve verimli öğrenmek, yapay zekada hâlâ en belirleyici iki kaldıraç. Sürüş sahnesinden el hareketine, gezegen ölçeğinde gömmelerden çok dilli modellere uzanan çalışmalar, algının nasıl kurulduğunu ve bilginin açık kaynaklarla nasıl yayıldığını gösteriyor. Birlikte okununca, tek bir alandaki ilerlemenin diğerlerine nasıl sızdığını görmenizi sağlıyor.
1.Araştırma
Foundation4D: Otonom araçlar için birleşik algı modeli
NVIDIA'nın Foundation4D'si, çok kameralı sürüş videosundan geometri, 3B algılama ve doluluğu tek modelde çıkarıyor.
NVIDIA ekibi, çok kameralı sürüş videosundan geometri tahmini, 3B nesne algılama, anlamsal doluluk ve Gaussian yeniden yapılandırmayı tek bir ileri beslemeli modelde birleştiren Foundation4D'yi tanıttı. Ortak omurga, kameralar ve zaman boyunca gelen gözlemleri verimli biçimde birleştirmek için çarpanlara ayrılmış uzamsal-zamansal dikkat kullanıyor. Video çıkarım hattı ise poz grafiği optimizasyonuyla kamera yörüngelerini iyileştiriyor ve nesne izlerini pencereler arasında birleştiriyor. Ekip ayrıca 1.253 sürüş klibi için yoğun derinlik ve anlamsal doluluk etiketleri içeren PAI-Foundation4D benchmark'ını yayımladı. Benchmark'a özel fine-tuning sonrasında model, karşılaştırılan yöntemler arasında Waymo ve nuScenes'te en düşük derinlik hatasını, nuScenes'te en yüksek algılama mAP'ini ve OpenOccupancy'de en yüksek doluluk mIoU'sunu elde ediyor. Görevleri birlikte eğitmek de fayda sağlıyor: algılamayı geometri ve doluluk ile birlikte eğitmek mAP'i 1,2 puan artırırken, geometriyi algılamayla birlikte eğitmek kameradan araca çeviri hatasını yüzde 13,4 azaltıyor. Tahmin edilen geometri ve yörüngeler, simülasyon için sürüş sahnelerinin LiDAR'sız yeniden yapılandırılmasında önsel olarak da kullanılabiliyor. Bu sonuçlar, otonom araç algısında ayrı ayrı modeller yerine tek bir temel modele geçişin hem doğruluk hem verimlilik açısından anlamlı olabileceğini gösteriyor.
SplatLab: 3DGS araştırması için otonom bilimsel keşif
SplatLab, bir 3DGS makalesini yeniden üretip genişletiyor, deneyleri koşturuyor ve makaleyi kendisi yazıyor.
SplatLab, 3B Gaussian Splatting (3DGS) alanında araştırma sürecini uçtan uca otomatikleştiren bir sistem. Bir araştırma istemi, hedef makale URL'si ya da hiçbir girdi verilmeden çalışabiliyor: yayımlanmış bir temel yöntemi yeniden üretiyor, bir uzantı öneriyor, Mip-NeRF 360 ve LLFF üzerinde eğitip ablasyon yapıyor, makaleyi yazıyor ve raporlanan her sayıyı kayıtlı bir eğitim koşusuna bağlıyor. Sistem beş tasarım tercihiyle öne çıkıyor: doğrulanmış yeniden üretim omurgasından türetilen eklentiler, sekiz ada üzerinde GPU PSNR'ına göre puanlayan Elo turnuvası, başarısızlıkta puan düşüren sürekli bir çürütücü, her iddianın kayıtla desteklenmesi zorunluluğu ve 3DGS depoları arasında aktarılabilir yedi kategorili bir taksonomi. PSNR hedefli koşularda SplatLab'in ürettiği makaleler, yeniden üretilen hedeflerini +0,18 ile +3,78 dB arasında geçti; bunun en büyük kazancı, daha önce hiçbir 3DGS yönteminin bulunmadığı astrofotografik bulutsu render'ında geldi. Araştırma döngüsü, aylarca süren yüksek lisans öğrencisi emeğinden, büyük ölçüde otonom çalışan birkaç günlük hesaplamaya iniyor. Çalışma NeurIPS 2026'da kabul edildi; kod ve deney kayıtları açık. Bu, araştırma otomasyonunun artık canlı ve yoğun bir bilgisayarlı görü alt alanında somut sonuçlar verebildiğini gösteriyor.
TILDE: Gömülü temel modellerden öğretmen eşliğinde damıtma
TILDE, eylem ön eğitimi olmadan robot politikalarına gömülü temel model yeteneklerini aktarıyor.
Büyük ölçekli eylem ön eğitimi, gömülü temel modellere (EFM) güçlü manipülasyon yetenekleri kazandırıyor; ancak bu yetenekleri yeniden üretmek ciddi miktarda robot verisi ve hesaplama gücü gerektiriyor. TILDE, bu yetenekleri eylem ön eğitimi almamış politikalara aktarmak için iki fikri birleştiriyor: öğrencinin kendi ürettiği durumlarda on-policy damıtma yapmak ve öğretmenin yürüttüğü kurtarma yörüngelerinden öğrenmek. Yöntemin ikinci bileşeni olan AutoDAgger, bu kurtarma verisini otomatik biçimde topluyor. Bir robotik ödül modeli görev ilerlemesini sürekli izliyor ve politika takıldığında ya da yoldan çıktığında öğretmen müdahalesini tetikliyor. Böylece kurtarma deneyimi, insan gözetimi ya da manuel kontrol olmadan toplanabiliyor. AutoDAgger, kurtarma yörüngesi toplamayı insan döngülü yönteme kıyasla 2 kattan fazla hızlandırıyor. Gösterilerden öğrenmeyi, on-policy öğretmen denetimini ve öğretmenin düzeltici davranışını bir araya getiren TILDE, üç gerçek dünya görevinde davranış klonlamaya göre görev performansını 4,1 kata kadar artırıyor. Yöntem ayrıca mimariler arası damıtmayı da destekliyor; yani öğretmen ve öğrenci aynı model ailesinden olmak zorunda değil. Bu yaklaşım, güçlü robot politikaları için gereken veri ve hesaplama maliyetini düşürme yönünde pratik bir yol sunuyor ve robotik alanında temel model yeteneklerinin daha küçük politikalara aktarılmasını kolaylaştırıyor.
Akıl yürüten LLM'lerin anlaşılması ve izlenebilirliği
Akıl yürütme belirteçleri, LLM'lerin iç hesaplamalarının doğru bir açıklaması değil; izlenebilirlik için bu bir sorun.
Öncü büyük dil modelleri artık sorunları adım adım çözecek şekilde eğitiliyor ve insanın anlayabileceği dilde akıl yürütme metni üretiyor. Bu yaklaşım, 2022'de bir istem tekniği olarak önerilen düşünce zinciri (chain-of-thought) yöntemine dayanıyor; 2024 civarından itibaren öncü modeller bu yöntemi eğitim sürecine dahil etti. Ancak üretilen akıl yürütme belirteçleri, modelin iç hesaplamalarını doğru biçimde yansıtmayabiliyor. Bu da düşünce zincirinin bir yorumlanabilirlik yanılsaması yaratabileceği endişesini doğuruyor. Yapay zekâ güvenliği araştırmacılarının yaklaşık 1.000 ön baskıyı taradığı bir çalışmada, makalelerin yüzde 25'inde yazarların düşünce zincirini açıkça bir yorumlanabilirlik tekniği olarak ele aldığı görüldü; bunların arasında klinik karar verme gibi yüksek riskli alanlar da bulunuyor. Nature Machine Intelligence'ın bu sayısındaki bir görüş yazısında Levy ve arkadaşları, akıl yürütme belirteçlerinin sadık açıklamalar olmaması sorununu inceliyor ve bu belirteçlerin izlenebilirliğini sağlamanın daha sezgisel yollarını araştırıyor. Modeller çok adımlı sorunları çözdükçe ve çok ajanlı sistemlerde birbirleriyle tartıştıkça, çıktıların ardındaki gerçek süreci denetleyebilmek daha da kritik hale geliyor. Özellikle sağlık gibi hata maliyetinin yüksek olduğu alanlarda, model açıklamalarına körü körüne güvenmek ciddi riskler taşıyabilir.
EgoHand: Egosentrik videodan tek gözlü 3B el yeniden yapılandırma
EgoHand, 14 milyon görüntüyle eğitilip egosentrik videoda en iyi el yeniden yapılandırma sonuçlarını bildiriyor.
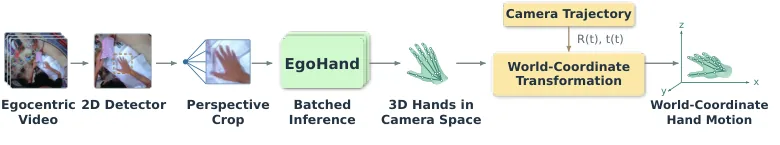
EgoHand, egosentrik videodaki elleri tespit edip kırparak toplu çıkarımdan geçiriyor ve el hareketini dünya koordinatlarında veriyor. Görsel: Chen ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
EgoHand, egosentrik videodan tek gözlü 3B el yeniden yapılandırmasında en iyi sonuçları bildiren yeni bir model. Yaklaşımın merkezinde 14 milyon görüntülük bir eğitim külliyatı var: sahne çeşitliliği ile denetim kalitesini dengelemek için sentetik veri, doğal ortam videoları ve çok kameralı hareket yakalama verisi birleştirilmiş. Model, parametrik temsil olarak SOMA-Hand'i kullanıyor; 2B el kırpıntılarını bir transformer kodlayıcıyla işliyor ve geometrik tutarlılığı ile görüntü hizalamasını iyileştirmek için kamera ipuçları ile yardımcı bir 2B dal ekliyor. HOT3D, ARCTIC ve H2O üzerindeki sıfır atış değerlendirmeleri, rakip yöntemlere göre daha düşük eklem konumu, kök öteleme ve ivme hatasını yaklaşık 9,69 ms çıkarım gecikmesiyle gösteriyor. Kör bir kullanıcı tercih çalışmasında katılımcılar, EgoHand'in el pozlarını Apple EgoDex ve Ropedia Xperience-10M'inkilere tercih etti. Model ve kaynak kodu OpenMDW lisansıyla yayımlandı ve ticari kullanıma açık. Düşük gecikme ve sıfır atış genellemesi, bu çözümü gerçek zamanlı uygulamalar için de uygun kılıyor. Sonuç olarak EgoHand, artırılmış gerçeklik ve robotik gibi egosentrik el takibine dayanan uygulamalar için güçlü ve serbestçe kullanılabilir bir temel sunuyor.
Ai2, OlmoEarth v1.3 ile tüm dünya için yıllık, 10 metre çözünürlüklü uydu gömmelerini açık olarak yayımladı.
Ai2, en gelişmiş uydu gömme modellerinden biri olarak tanıttığı OlmoEarth v1.3'ü yayımladı. Model, bir yıllık radar (Sentinel-1) ile çok bantlı (Sentinel-2 ve Landsat) uydu zaman serilerini okuyarak Dünya üzerindeki her 10 metrelik piksel için 128 boyutlu bir vektör üretiyor; ilk 64 boyut ise tek başına daha küçük bir gömme olarak da kullanılabiliyor. Ekip, bu gömmeleri tüm gezegen için önceden hesaplayıp Source Cooperative üzerinden paylaştı ve gömmeler üzerinden haritaları keşfedip özelleştirmek için tarayıcı tabanlı bir araç, OlmoEarth Embeddings Explorer'ı da sundu. Böylece bir ürün haritası, arazi örtüsü haritası ya da değişim analizi, üzerine küçük bir sınıflandırıcı eğitilip yerelde çalıştırılan hafif bir modelleme problemine dönüşüyor. Altı kıtayı kapsayan 27 değerlendirmede 128 boyutlu gömmeler 27'nin 20'sinde en yüksek puanı alırken, yarı boyuttaki 64 boyutlu sürüm 18'inde önde; karşılaştırma AlphaEarth Foundations ve Tessera v2 ile yapıldı. Ekip ayrıca tropikal tarım için yeni bir ürün türü benchmark'ı olan PLANTEUR'u sundu; gömmeler, sınıflandırıcının hiç görmediği yerlere en iyi genelleme sağlıyor. Model ağırlıkları, ön eğitim verisi ve ön eğitim kodu dahil her şey açık. GPU erişimi ve görüntü indirme gerektirmeden kullanılabilmesi, yer gözlemi araştırmalarının önündeki eşiği belirgin biçimde düşürüyor.
Çok kipli bağlam içi öğrenme önce görsel temellendirme ister
ProCoRe, görsel temellendirmeyi pekiştirerek ICL verisi görmeden çok kipli bağlam içi öğrenmeyi iyileştiriyor.
Büyük dil modelleri güçlü bir bağlam içi öğrenme (ICL) yeteneği gösteriyor, ancak bunu çok kipli modellere (MLLM) taşımak zor. Önceki yöntemler genellikle ICL'ye özgü veri kümeleriyle ek eğitime dayanıyor; bu, uyarlama yapılan benchmark'ta başarıyı artırsa da diğer benchmark'lara iyi genellenmiyor ve önceden iyi çözülen görevlerde unutmaya yol açabiliyor. Araştırmacılar asıl darboğazın 'görsel temellendirme' olduğunu tespit etti: MLLM'ler gösterimlerdeki göreve uygun görsel kanıta bakmak yerine metinsel ipuçlarına fazla güveniyor ve halüsinasyonlu çıktılar üretiyor. Önerilen ProCoRe, çok kipli karşıt veriler üzerinde karşıt pekiştirmeli öğrenme ile görsel temellendirmeyi güçlendiriyor: karşıt görüntü çiftleri için alt yazı üretiyor, bunları önermelere ayırıyor ve ilgili görüntüyle hizalanmayı ödüllendirip uyumsuz olanı cezalandıran ödüller optimize ediyor. ICL biçimli eğitim örneği hiç görmemesine rağmen ProCoRe, hazır Qwen-VL-3-8B modeline göre ortalama çok kipli ICL sınıflandırma doğruluğunu yüzde 5,6, alt yazı ROUGE-L skorunu yüzde 13,8 artırıyor ve ICL verisine bağımlı en iyi yöntemleri geride bırakıyor. Ekip ayrıca, MLLM'lerin görsel gösterimleri gerçekten anlayıp anlamadığını sınayan kişiselleştirilmiş bir çok kipli ICL alt yazı benchmark'ı olan PICL'i de tanıttı. Çalışma NeurIPS 2026'da kabul edildi.
AQL-Lite: Arapça LLM'ler için veri odaklı sürekli ön eğitim
AQL-Lite, kürate veriyle kısmi parametre eğitimi yaparak Arapça uyarlamanın kazancının yüzde 94'ünü yarı sürede yakalıyor.
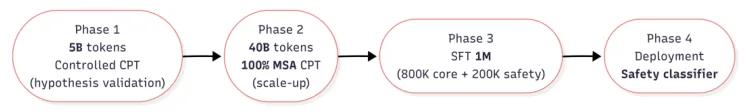
AQL-Lite tarifi önce 5 milyar token'lık kontrollü kurulumda doğrulanıyor, ardından 40 milyar token'a ölçekleniyor; talimat ayarı ve güvenlik filtrelemesiyle tamamlanıyor. Görsel: Boukhalfa ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Arapça büyük dil modellerinin eğitimi; gürültülü web verisi, lehçe çeşitliliği ve sürekli ön eğitimin (CPT) yüksek maliyeti gibi sorunlarla karşı karşıya. AQL-Lite, çok dilli bir LLM'yi Modern Standart Arapça'ya (MSA) uyarlamak için zaman ve kaynak açısından verimli bir çerçeve sunuyor. Çerçeve, yapısal temizlik, sezgisel ve model tabanlı filtreleme, MSA seçimi ve tekilleştirmeden oluşan kalite öncelikli bir kürasyon hattını, ağ genelinde RS-LoRA adaptörleri ile son sekiz transformer bloğu ve gömme matrisini katman bazlı öğrenme oranlarıyla eğiten kısmi parametre CPT tarifiyle birleştiriyor. Eşit 1 milyar belirteçlik bütçede AQL ile kürate edilmiş veri üzerindeki CPT, dört benchmark'lık Arapça ortalamayı ham web metnine göre 3,51 puan yükseltiyor; ham metin ise temel modele göre kazanç sağlamıyor. 5 milyar belirteçlik kontrollü karşılaştırmada AQL-Lite, tam parametreli CPT'nin kazancının yüzde 94'ünü (ortalama 73,19'a karşı 73,58) duvar saati süresinin yüzde 52'sinde yakalıyor ve her benchmark'ta yalnızca adaptör kullanan yöntemleri geçiyor. 40 milyar MSA belirtecine ölçeklenip bir milyon örnekle talimat ayarı yapılan 12 milyar parametreli model, yedi benchmark'lık Open Arabic LLM Leaderboard v2'de 75,3 puan alıyor. Sonuçlar, özenle kürate edilmiş külliyat üzerinde kısmi parametre CPT'nin düşük kaynaklı dillerde verimli uyarlama için pratik bir yol olabileceğini düşündürüyor.