2026-10-26Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bu sayıdaki çalışmalar aynı soruyu farklı yönlerden soruyor: Daha azıyla daha fazlası nasıl yapılır ve nerede sessizce kaybederiz? Ucuzlayan robot verisi, kendini geliştiren dil modelleri ve açık kaynak konuşma sistemleri verimlilik vaadini büyütürken, düşük hassasiyetli ince ayar ve belirsiz üretim gibi tuzaklar bedelini hatırlatıyor. Birlikte okuyunca ajan çağının hem fırsatını hem sınırlarını görüyorsunuz.
1.Araştırma
TrajectoryFlowNet: Az veriyle akış alanı ve parçacık yolu tahmini
Fizik bilgili model, sınırlı yörünge ölçümüyle uzun menzilli parçacık yollarını ve akış alanlarını birlikte öğreniyor.
TrajectoryFlowNet, seyrek yörünge ölçümlerinden hem uzun menzilli parçacık yollarını hem de tam alan akışlarını tahmin eden, Lagrangian–Eulerian yapıda fizik bilgili bir sinir ağı mimarisi. Geleneksel yöntemler Navier–Stokes denklemlerinin çözümüne dayanır; bu hem derin fiziksel bilgi hem de yüksek hesaplama maliyeti gerektirir. Mevcut makine öğrenmesi yaklaşımları ise veri seyrek olduğunda uzun menzilli yörüngeleri genelleyemiyor ve çoğu zaman fiziksel tutarlılığı koruyamıyor. Önerilen model bu iki sınırlamayı birlikte aşmayı hedefliyor: düzensiz sınırlara sahip karmaşık akış desenlerini ele alabiliyor, herhangi bir parçacığın uzun yörüngesini görüntüleyebiliyor ve tahminlerin fiziksel tutarlılığını koruyor. Lagrangian bakış parçacıkların izlediği yolları, Eulerian bakış ise uzayın her noktasındaki akış alanını temsil ettiğinden, tek bir çerçevede ikisinin birleştirilmesi yöntemin temel gücünü oluşturuyor. Yazarlar modeli sayısal örneklerde (kapaklı boşluk akışı, karmaşık silindir akışı) ve deneysel vakalarda (aort ve ventrikül kan akışı) doğruladı. Sonuçlar, parçacık yüklü akış dinamiklerinin yakalanabildiğini ve gerçek uygulamalarda akış alanlarının doğru biçimde yeniden oluşturulabildiğini gösteriyor. Bu yaklaşım, kan akışı gibi doğrudan ölçümün zor olduğu alanlarda hız ölçümü ve görüntülemeyi daha ucuz ve erişilebilir kılma potansiyeli taşıyor; böylece klinik ve mühendislik uygulamalarında seyrek verilerle bile güvenilir akış analizi yapmanın önünü açıyor.
Üç ortografik siluetten fiziksel olarak kararlı blok yapıları üreten iki aşamalı çerçeve: StackGen3D.
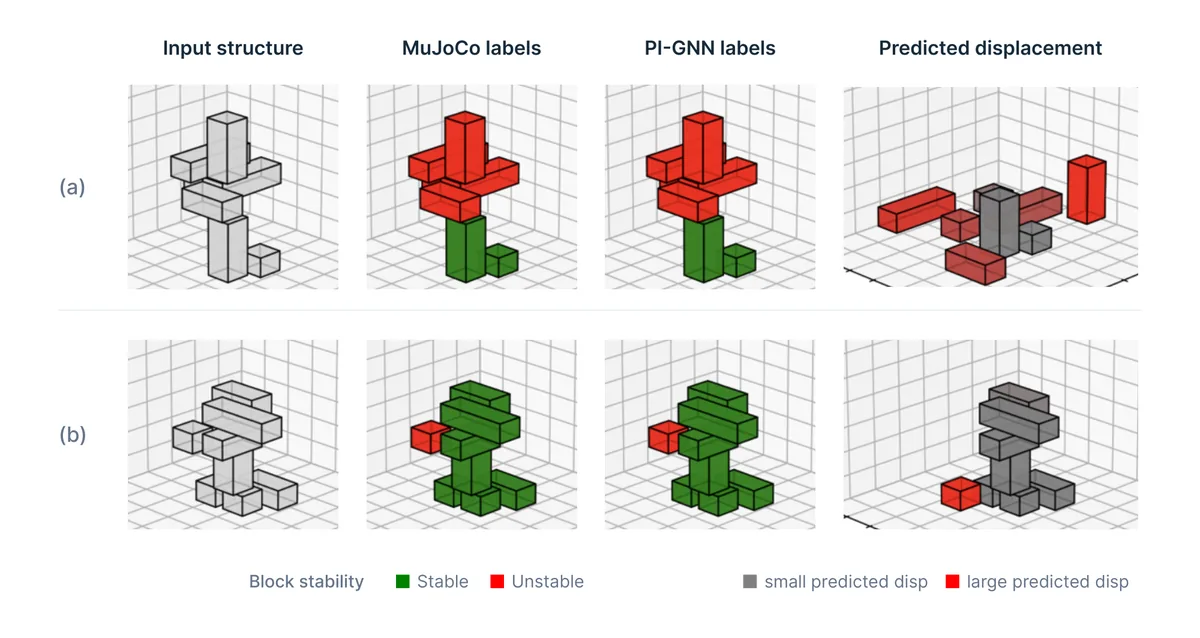
PI-GNN'in karmaşık yapılarda blok blok yaptığı kararlılık tahminleri MuJoCo etiketleriyle karşılaştırılıyor; öğrenilen destek akıl yürütmesinin basit yapılardan karmaşık yapılara aktarıldığı görülüyor. Görsel: Zhang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
StackGen3D, verilen bir blok envanteri ve üç ortografik siluet koşuluna göre fiziksel olarak kararlı blok yapıları üreten bir çerçeve. Birinci aşamada, bloklar arasındaki destek ilişkilerini modelleyen fizik bilgili bir çizge sinir ağı (PI-GNN) geliştiriliyor; bu ağ, çeşitli ve kararlı yapılardan oluşan bir veri kümesini derlemek için hızlı bir kararlılık tahmincisi olarak kullanılıyor. İkinci aşamada, hedef siluetlerle tutarlı blok konfigürasyonlarının çok kipli dağılımını yakalamak için bu veri kümesi üzerinde koşullu bir flow-matching modeli eğitiliyor. Çıkarım sırasında hafif geometrik seçim ve iyileştirme adımları, fizik simülasyonuna ihtiyaç duymadan bloklar arası girişimi azaltıyor. Bu sayede pahalı simülasyon döngülerine bağımlı kalmadan hızlı üretim mümkün oluyor. İlk deneyler, PI-GNN'in basit yığınlardan karmaşık yapılara parametre sayısı eşleştirilmiş bir çok katmanlı algılayıcıdan belirgin biçimde daha iyi genelleştiğini gösteriyor. Yapı üretiminde Best-of-10 seçimi fiziksel kararlılığı %45,3'ten %72,4'e çıkarırken 0,970 siluet IoU değerini koruyor; yani kararlılık artarken hedef siluetlere uyum bozulmuyor. Bulgular, ilişkisel fiziksel akıl yürütmeyi, ölçeklenebilir veri derlemeyi ve koşullu üretken modellemeyi birleştirmenin yaratıcı 3B montaj için potansiyelini ortaya koyuyor ve robotik montaj ile otomatik tasarım gibi alanlara kapı aralıyor.
Verisiz öz-eğitim: Dil modelleri kendini geliştirebilir mi?
OPST, yalnızca üst düzey konu tanımlarıyla modelin kendi soru-cevaplarından öğrenmesini sağlıyor.
On-Policy Self-Training (OPST), politika içi öz-damıtmayı (on-policy self-distillation) kendi ürettiği soru-cevap çiftleri ve ayrıcalıklı akıl yürütme gösterimleriyle çalışan bir öz-eğitim çerçevesine dönüştürüyor. Mevcut yaklaşımlar doğru cevaplı soru-cevap çiftlerine, insan tarafından hazırlanmış problem kümelerine ya da başka denetim sinyallerine bağımlıyken, OPST denetimi uç noktaya taşıyor: yalnızca kaba, üst düzey konu tanımlarıyla yönlendirilen model, insan yazımı hiçbir istem ya da cevaba erişmeden kendi sorularından ve ayrıcalıklı akıl yürütme izlerinden bir müfredat oluşturuyor. Bir sahte doğrulama filtresi, bir problemi yalnızca model cevabını yeni bir bağlamda ve başka sözcüklerle ifade edilmiş haliyle de yeniden üretebiliyorsa tutuyor; böylece kalitesiz ya da tutarsız örnekler eğitime girmeden elenmiş oluyor. Tamamen sentetik ayrıcalıklı bilgi üzerinde öz-damıtma, modelin birden fazla alanda gelişmesini sağlarken eğitilmediği alanlardaki yeteneklerini de koruyor. Çerçeve metin ve çok kipli alanlarda, standart dil kıyaslamalarında ve görsel soru yanıtlamada tutarlı iyileşme gösteriyor. Sonuçlar, temel modellerin dış görev denetimi olmadan güçlendirilebilecek zengin örtük yetenekler barındırdığını gösteriyor. Bu da pahalı insan etiketlemesine duyulan ihtiyacı azaltarak model geliştirmeyi daha ölçeklenebilir kılma potansiyeli taşıyor.
Nvidia Flora ile robot videosu etiketleme çok ucuzlıyor
Nvidia'nın açık kaynak Flora motoru, bir saatlik robot videosunu 72 sente etiketliyor; GPT-6 Astra'da bu 88 dolar.
Nvidia'nın GEAR araştırma laboratuvarı, robot videolarını etiketleyen açık bir veri motoru olan Flora'yı yayımladı. Büyük robot modelleri, üç tür etikete ihtiyaç duyan videolardan öğreniyor: eylem tanımları, adım adım ilerleme puanları ve görev başarısı yargıları. Mevcut araçların çoğu yalnızca birini sağlıyor; GPT-6 Astra gibi büyük dil modelleri birkaçını üretebiliyor ama gereken video hacmi için çok pahalı. Flora, ince ayarlı üç Qwen3.5 modelinden oluşuyor: eylem segmentlerini ayıran 9B bir model, eylemleri öncesi ve sonrasıyla birlikte betimleyen 27B bir model ve başarıyı 1–5 ölçeğinde derecelendiren, her yarım saniyelik adımı sınıflandıran 27B bir ödül modeli. Nvidia'nın 50 videoluk testine göre Flora, tam akıl yürütme kapasitesiyle çalışan GPT-6 Astra'dan biraz daha yüksek kalite elde ediyor (%57,1'e karşı %53,7) ve saat başına yaklaşık 0,72 dolara mal oluyor; Astra'da bu yaklaşık 88,49 dolar. Ancak maliyet rakamları, GPU başına saatte 10 dolarlık varsayılan kira bedeline dayanan projeksiyonlar. Üstelik Flora eylem sınırlarını daha iyi bulsa da Astra eylemleri çoğu zaman daha kesin tanımlıyor. Nvidia sistemin GR00T eğitiminde 512 GB300 GPU üzerinde günde 200.000 saate kadar videoyu etiketlediğini belirtiyor; modeller Hugging Face'te açık.
Granite Speech 5.0: Daha doğru ve hızlı konuşma işleme
IBM, Granite Speech koleksiyonuna yeni 2B modeli ve iki güncellenmiş modeli ekledi.
IBM, Granite Speech koleksiyonunda üç güncelleme duyurdu: yeni granite-speech-5.0-2b modeli ile granite-speech-5.0-470m-turboctc ve granite-speech-4.1-2b-plus'ın revize sürümleri. 5.0-2b, 4.1 2B'nin aynı parametre sayısındaki halefi; İngilizce, Fransızca, Almanca, İspanyolca, Portekizce ve Japonca'yı yazıya döküyor, bu dillerle İngilizce arasında çeviri yapıyor, ayrıca İngilizceden İtalyanca ve Mandarin'e çeviri sunuyor. 390.000 saatlik kamuya açık sesle ve Japonca otomatik konuşma tanıma (ASR), anahtar kelime yanlılığı ve çeviri için üretilmiş sentetik verilerle eğitildi. Yenilikler arasında İngilizce kısa biçim kıyaslamalarında daha yüksek doğruluk, gürültü ve yankıya karşı dayanıklılık, istemde dil belirterek çok dilli yazıya dökmeyi yönlendirme, daha uzun ve doğal konuşmalarda daha iyi çeviri ve her desteklenen dilde 2.000 terime kadar anahtar kelime listesi var. 470m-turboctc yüksek verimli ve cihaz üstü yazıya dökme için çok dilli, yerel noktalama ve büyük harf desteğiyle gürültüye daha dayanıklı hale geldi; 4.1-2b-plus ise konuşmacı atfı, zaman damgaları ve uzun konuşma performansını iyileştirdi. Toplamda koleksiyon, kayıtlarda kimin ne zaman konuştuğunun önemli olduğu toplantı ve çağrı senaryolarını da kapsıyor.
HiSTEVE 1.0: Minecraft'ta insan arayüzüyle VLA ajanı
HiSTEVE, yalnızca görüntü ve klavye-fare ile Minecraft'ta uzun ufuklu görevleri tamamlayan hiyerarşik bir VLA ajanı.
HiSTEVE, Minecraft gibi açık uçlu oyunlarda insan oyuncular gibi çalışan sanal somutlaşmış ajanlar kurmayı hedefleyen hiyerarşik bir görü-dil-eylem (VLA) ajanı. Mevcut ajanlar ya uzun ufuklu özerklik olmadan yerel görsel-motor kontrol sunuyor ya da ortam API'leri veya önceden tanımlı becerilerle yürütülen üst düzey planlamaya dayanıyor. HiSTEVE, yetenek farkındalıklı bir ajan donanımıyla bu boşluğu kapatıyor. Orkestrasyon katmanında ilerlemeyi izleyen yapılandırılmış bir bellek ve VLA'nın yetenekleri dahilinde alt görevleri seçen bir VLM planlayıcı bulunuyor; alt görevin tamamlandığını güvenilir biçimde belirlemek için VLA politikası bağlamını kullanan bir görev tamamlama durum dedektörü de ekleniyor. Kontrol katmanında tek bir VLA, yalnızca görsel algı ve yerel klavye-fare eylemleriyle tüm alt görevleri yürütüyor. Farklı arayüz etkileşimleri arasındaki girişimi azaltmak için rejime özgü RMSNorm dalları ve ayrı fare hareketi token gömmeleri kullanılıyor. VLA; dünya bilgisi enjeksiyonu, taklit öğrenmesi ve ortam geri bildirimli pekiştirmeli öğrenmeyle eğitiliyor. HiSTEVE, MineStudio Bench'te %85,0 ve OpenHA'da %37,4 ortalama başarı oranıyla atomik görevlerde en iyi sonuçları veriyor; ayrıca sıfırdan demir kazma yapmak gibi uzun ufuklu görevleri de tamamlıyor.
bf16 VLA ince ayarı güncellemelerin çoğunu sessizce siliyor
fp32 ana kopya olmadan bf16'da ince ayar, ağırlık güncellemelerinin büyük kısmını yuvarlayarak yok ediyor.
Bir görü-dil-eylem (VLA) modeli, eğitilebilir ağırlıkları bfloat16'da (bf16) ve fp32 ana kopya olmadan ince ayarlandığında, AdamW her güncellemeyi doğrudan bf16'ya yazıyor ve bir ağırlığın 1/512'sinden küçük güncellemeleri sessizce yuvarlayıp siliyor. 12 açık VLA kod tabanının 9'unda varsayılan ya da belgelenmiş bir tarif böyle eğitim yapıyor; 4'ü tam ağırlık matrisleriyle çalışıyor ve LeRobot'un SmolVLA varsayılanı ile π0/π0.5 kılavuzlarını da içeriyor. Yazarın LIBERO çalıştırmalarında, kopya olmadan her 100 adımda yapılan bir ölçüm bf16 ağırlık güncellemelerinin en az %79'unun silindiğini gösteriyor. Hugging Face Hub'da örneklenen tam ağırlıklı SmolVLA ince ayarlarının %99'u eylem uzmanını bf16'da saklıyor; eğitim yapılandırması olan son π0.5 ince ayarlarının %84'ü bf16 bayrağını ayarlıyor. LIBERO-Object'te fp32 kopya, öğrenme oranı on kat düşükken başarıyı SmolVLA için %4,3'ten %49,3'e, π0.5 için %5,1'den %80,9'a çıkarıyor; π0.5'in varsayılan oranında ise %89,0'dan %97,7'ye. SmolVLA'nın varsayılan oranında kazanç, 50 eylemlik açık döngü parçalarda 10,2 puan, her 10 eylemde yeniden planlamada ise 4,2 puan. Yapılan karşılaştırmaların hepsinde kopyalı her çalıştırma kopyasızı geçiyor (p < 0,05). Çözüm basit: eğitim sırasında eğitilebilir ağırlıkları fp32'de tutmak; LeRobot'ta SmolVLA için tek satırlık bir değişiklik yetiyor.
Çalışma, yapılandırılmış üretimi tek çıktı yerine geçerli çıktılar kümesi üzerinde çıkarım olarak yeniden tanımlıyor.
Yapılandırılmış üretim genellikle girdiden tek bir yapılandırılmış çıktıya belirlenimci bir eşleme olarak ele alınır. Oysa doğal dil, yapısal olarak farklı ama anlamsal olarak geçerli birden çok yoruma izin verir. Mevcut yöntemler tek referanslı denetime dayandığı için belirsizliği tek bir tahmine indirger ve eksik belirtilmiş girdilerde kararsız, tutarsız çıktılar üretir. Bu çalışma problemi, tek çözüm yerine makul yapılandırılmış çıktılar kümesi üzerinde çıkarım yapan belirsizlik farkındalıklı bir yaklaşım olarak yeniden formüle ediyor. Yazarlar, standart eğitimin geçerli alternatifleri doğal olarak bastırdığını gösteriyor ve optimizasyon sırasında belirsizliği koruyan çok geçerli öğrenme çerçevesini benimsiyor. Yöntem, yapılandırılmış çıktılardan bir aday uzayı kuruyor, her adayı varlıkları ve ilişkilerini yakalayan bir çizge olarak temsil ediyor ve seçimi anlamsal uyum ile ilişkisel tutarlılık üzerinden çizge tabanlı akıl yürütmeyle yapıyor. Böylece rakip yorumlar, token düzeyindeki olasılıkların ötesinde ilkeli biçimde karşılaştırılabiliyor. Yapılandırılmış üretim kıyaslamalarındaki deneyler, değişen belirsizlik düzeylerinde doğruluk, kararlılık ve dayanıklılıkta tutarlı iyileşme gösteriyor. Bulgular, belirsizliği açıkça modellemenin önemine ve tek çıktı tahmininden küme düzeyinde akıl yürütmeye geçişe işaret ediyor. Çalışma NeurIPS 2026'da kabul edildi.