2026-10-28Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bu sayıda ortak iplik, yapay zekanın dünyayı nasıl algıladığı, onu içinde nasıl modellediği ve bunu hangi maliyetle yaptığı. Her kameradan 3B yeniden yapılandırma, dünya simülasyonları ve somutlaşmış ajanlar, algıdan eyleme uzanan tek bir hattın halkaları. Gizlilik ve verimlilik çalışmaları ise bu hattın sürdürülebilirliğini sınıyor. Birlikte okuyunca, alanın tek tek sıçramalardan çok bütünleşik bir mimariye yöneldiğini göreceksiniz.
1.Araç
vLLM v0.32.1rc0: RL eğitimcileri için ağırlık aktarım protokolü belgelendi
vLLM'nin yeni sürüm adayı, pekiştirmeli öğrenme eğitimcileri için ağırlık aktarımı HTTP protokolünü belgeliyor.
vLLM projesi, v0.32.1rc0 sürüm adayını yayımladı. Sürümün öne çıkan değişikliği, pekiştirmeli öğrenme (RL) eğitimcileri için ağırlık aktarımı (weight-transfer) HTTP protokolünün belgelenmesi oldu.
RL tabanlı eğitim süreçlerinde, model ağırlıklarının eğitim tarafından çıkarım sunucusuna sürekli ve hızlı biçimde aktarılması gerekiyor. Politika modeli her güncellemeden sonra yeniden yüklenmeli ki örnek üretimi (rollout) en güncel ağırlıklarla yapılabilsin. Bu akış, döngünün hem hızını hem de tutarlılığını doğrudan belirleyen kritik bir adım. Şimdiye kadar bu aktarım için ortak ve belgelenmiş bir yöntem bulunmadığından, her trainer geliştiricisi kendi çözümünü yazmak veya vLLM'in iç yapısını incelemek zorunda kalıyordu.
Yeni dokümantasyon, aktarımın HTTP üzerinden hangi protokolle yapılacağını tanımlayarak trainer geliştiricilerinin vLLM ile entegrasyonunu kolaylaştırmayı hedefliyor. Sürüm notları kısa olduğu için protokolün tam kapsamı, hangi uç noktaların ve veri biçimlerinin desteklendiği gibi ayrıntılar için belgelerin doğrudan incelenmesi gerekiyor.
Bu gelişme, açık kaynak çıkarım altyapısının yalnızca model sunmakla kalmayıp RL eğitim döngülerinin de ayrılmaz bir parçası haline geldiğini gösteriyor. Standart bir aktarım protokolü, farklı eğitim çerçevelerinin vLLM ile daha tutarlı çalışmasının önünü açabilir ve ekosistemdeki ortak çalışabilirliği artırabilir.
Any3R: Her kamera tipinden ileri beslemeli 3B yeniden yapılandırma
Any3R, lens tipinden bağımsız çalışarak balık gözü dahil her merkezi kameradan 3B geometri çıkarıyor.
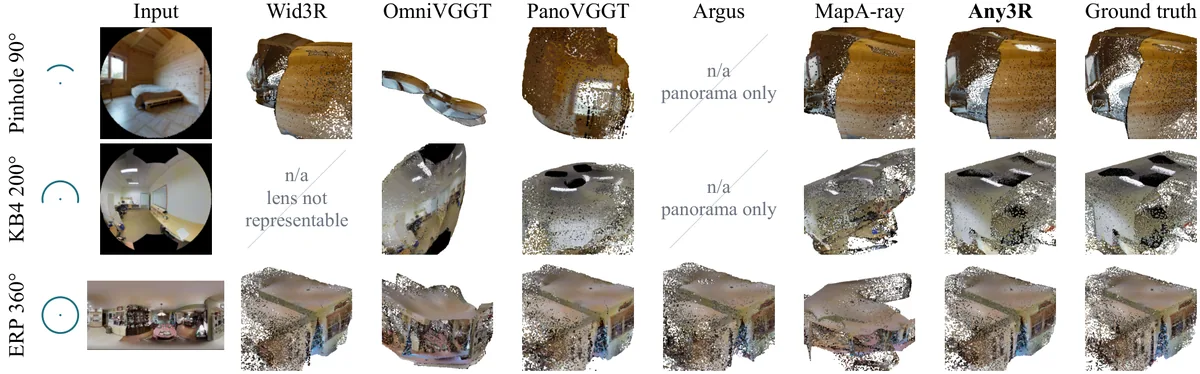
Kamera türünü bilen yöntemlerle nitel karşılaştırma: her satır tek bir kamera tipini gösteriyor, n/a hücreleri yöntemin o kamerayı desteklemediği anlamına geliyor. Görsel: Chen ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Geometri temel modelleri, görüntü kümelerinden kamera pozlarını ve yoğun geometriyi ileri beslemeli bir ağla kurtarabiliyor; ancak pinhole görüntüler bekliyorlar. Bu varsayım yalnızca girdide değil, omurganın içinde de gömülü: konumsal kodlama ve eğitim kaybı, bir görüntü konumunu uzaydaki bir yöne bağlıyor ve ikisi de merceğe bağımlı.
Any3R, her piksel boyunca uzanan birim yön vektörlerinden oluşan yoğun ışın alanını kullanıyor. Bu temsil, lens tipi, bozulma katsayısı veya görüş alanı sınırı gerektirmeden her merkezi kamerayı tanımlıyor. Açısal koordinatlar, döner kodlamaya her yama için ölçülen ışın açısını veriyor; katı açı ağırlıklandırması ise nokta kaybını her pikselin küre üzerinde kapladığı alanla ölçekliyor. Böylece ne kodlama ne de denetim lense bağlı kalıyor. Üç veri kümesindeki on üç merkezi kamerayla yapılan kıyaslamada, her yöntem kendi tahmin ettiği kamera pozlarıyla yeniden yapılandırma yaparken Any3R en tutarlı biçimde doğru yöntem oldu.
Model, bir sahnede birçok kamera tipinin karışmasına karşı dayanıklı ve lens başına yeniden eğitim gerektirmiyor. Bu da farklı kameralarla toplanmış kitle kaynaklı ve arşiv görüntü koleksiyonlarından ölçeklenebilir 3B yeniden yapılandırmanın yolunu açıyor.
OmniBrain-0: Somutlaşmış zekâ için birleşik ajan modeli
Xiaomi ekibinin OmniBrain-0'ı, manipülasyon ve navigasyonu tek bir hafif karar modelinde birleştiriyor.
Xiaomi Embodied Intelligence ekibi, manipülasyon ve navigasyonu ortak bir üst düzey karar modeliyle koordine eden hafif ve birleşik bir somutlaşmış ajan olan OmniBrain-0'ı tanıttı. Model; görev anlama, planlama, ilerleme takibi ve geri bildirime dayalı toparlanmayı tek çatıda topluyor.
Eğitim üç aşamadan oluşuyor: somutlaşmış ön eğitim, alana özgü ajan damıtması ve çok öğretmenli politika-içi damıtma (MOPD). Güçlü öğretmenlerin etkileşim deneyimi önce manipülasyon ve navigasyon uzmanlarına damıtılıyor, ardından bu uzmanların karar yetenekleri OmniBrain-0'da birleştiriliyor. Birleştirme yalnızca araç arayüzünde değil, öğrenilmiş karar modelinin içinde gerçekleşiyor. Ayrıca bir Meta-Ajan'ın yürütme kanıtlarını rafine edilmiş ölçütlere, adım düzeyinde hatırlatıcılara ve doğrulanmış yörüngelere dönüştürdüğü Rubric-Guided Recursive Self-Improvement (RSI) veri döngüsü sunuluyor. Model; LIBERO-Pro, LIBERO-Plus, RoboCasa365, RoboTwin 2.0 ve R2R-CE Val-Unseen'de ve gerçek dünya manipülasyon görevlerinde değerlendirildi.
Sonuçlar, OmniBrain-0'ın alanlar arası güçlü görev performansını, kapalı kaynaklı öğretmenine kıyasla belirgin biçimde düşük çıkarım ve yürütme maliyetiyle birleştirdiğini gösteriyor. Bu da büyük ajanların somutlaşmış yeteneklerinin kompakt tek bir modele verimli biçimde aktarılabildiğine işaret ediyor.
PrinGS, eğitilmiş 3DGS sahnelerinden yüz ve plaka gibi hassas içeriği bir saniyeden kısa sürede siliyor.
3D Gaussian Splatting (3DGS), yüksek doğruluklu yeni görünüm sentezi ve 3B sahne yeniden yapılandırması için tercih edilen temsil haline geldi. Ancak öğrenilen temsil; insan yüzleri, plakalar, belgeler ve bilgisayar ekranları gibi hassas görsel bilgileri de kodluyor ve eğitilmiş splat'ler paylaşıldığında ciddi gizlilik riskleri doğuruyor.
PrinGS, eğitilmiş bir splat'i doğrudan anonimleştiren temsil düzeyinde bir çerçeve öneriyor. Kullanıcı, hassas içeriği gösteren bir referans görünüm veriyor; yöntem bu bölgeleri alttaki 3B temsilde konumlandırıp anonimleştiriyor. Böylece hassas bilgi sonradan üretilen hiçbir yeni görünümde yer almıyor, sahne geometrisi ve görsel kalite ise korunuyor. Eğitim sonrası anonimleştirme bir saniyeden kısa sürüyor. Çerçeve ayrıca, hassas içeriğin optimizasyon sırasında temsile gömülmesini baştan engelleyen, tasarımdan gizlilik (privacy-by-design) odaklı bir eğitim stratejisiyle genişletiliyor. Yöntem, %39,47 yüz algılama oranı korunurken %9,79'luk çok düşük bir Yüz Benzerlik Ölçütü (FSM) elde ediyor ve hassas metni OCR karakter hata oranı 1,00 ile tamamen okunamaz hale getiriyor.
Çalışma, gizliliğe duyarlı 3B temsiller yolunda ilk adım olmayı hedefliyor. 3DGS sahnelerinin giderek daha çok paylaşıldığı düşünülürse, bu alandaki araştırmaların önemi artacak gibi görünüyor.
DeepMind'ın Genie 4 dünya modeli, gerçek zamanlı simülasyonda foto-gerçekçilik ve yerel ses üretimi getiriyor.
Google DeepMind, gerçek zamanlı etkileşimli simülasyonda daha önce görülmemiş gerçekçilik sunan yeni dünya modeli Genie 4'ü duyurdu. Model yerel olarak çok kipli: müzik, ortam sesleri ve etkileşimli diyalog, dünyayla eş zamanlı üretiliyor.
Genie 4, Gemini ailesinin yeteneklerinin üzerine kurulu. Gemini Omni simülasyonları gerçek dünyadaki görünüm ve davranışa demirlerken, diğer Gemini modelleri simülasyonun tutarlılığını ve sürekliliğini korumak için gereken karmaşık muhakemeyi sağlıyor. Kullanıcılar klavye ile gezinip kamerayı kontrol edebiliyor, metin istemleriyle sahneyi gerçek zamanlı yönlendirebiliyor; hava durumunu değiştirmek, yeni bir kişi veya nesne eklemek gibi müdahalelerde Gemini istemi çevredeki sahneye uyarlıyor. DeepMind, modelin fotogerçekçilik, akıcı hareket ve yerel ses alanlarında geliştiğini belirtiyor.
Genie 4, güvenilir test kullanıcılarına araştırma önizlemesi olarak sunulmaya başlandı; ardından Google AI Ultra aboneleri için Project Genie ile Gemini API ve Google AI Studio'nun erken erişim ortaklarına açılacak. DeepMind'a göre dünyayı anlamak ve simüle etmek AGI inşasının temel unsurlarından biri; Genie 4 de robotlar ve ajanlar için eğitim ortamları geliştirmekten yeni etkileşimli deneyimler yaratmaya uzanan alanlarda sonsuz çeşitlilikte, güvenli simülasyonlar vaat ediyor.
Döngüsel dönüştürücülerde kısaltma gerekli mi? Bir ölçekleme çalışması
Yaklaşık 600 eğitimle yapılan çalışma, döngüsel dönüştürücülerde tam BPTT'nin kısaltılmışa üstün geldiğini gösteriyor.
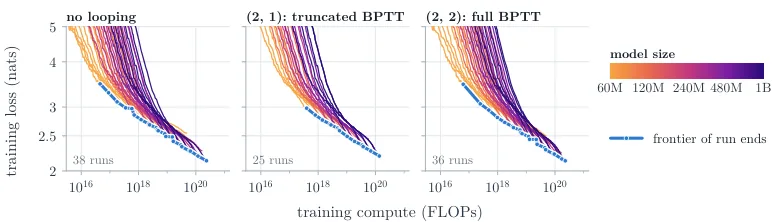
Döngüsüz, (2, 1) ve (2, 2) yapılandırmaları için ölçekleme deneylerinin eğitim eğrileri; her eğri ayrı bir çalıştırmaya ve model boyutuna karşılık geliyor. Görsel: Xiong ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Döngüsel dönüştürücüler (looped transformers), paylaşılan bir katman bloğunu yeniden kullanarak eğitilebilir parametre sayısını artırmadan hesaplama derinliğini artırıyor. Eğitimde zamanda geri yayılım (BPTT) kullanılıyor; hesaplama tasarrufu için BPTT sıklıkla yalnızca son birkaç döngüye kısaltılıyor, ancak bu durum döngünün faydasını zayıflatabilecek yanlı gradyanlar üretiyor.
Çalışmada model boyutu, eğitim token sayısı ile ileri ve geri döngü sayıları, yaklaşık 600 eğitim koşusunda birlikte değiştirildi. Döngü ve kısaltmanın etkisini etkin parametreler üzerinden yakalayan birleşik bir ölçekleme yasası uyduruldu. Kısaltmanın eğitim hesaplamasında tasarruf sağlamasına rağmen, ileri ve geri döngü sayıları birlikte optimize edildiğinde yasa tam BPTT'yi tercih ediyor. Eşleştirilmiş hesaplama bütçesinde, daha az döngü üzerinden tam BPTT, aynı bütçeli kısaltılmış ayarlardan tutarlı biçimde daha iyi sonuç veriyor. Model boyutu serbest bırakıldığında yasa, tam eğitilmiş iki döngüyü en iyi döngülü ayar olarak belirliyor.
Deneysel olarak bu ayar, hesaplama açısından optimal döngüsüz modele göre yaklaşık %27 daha az gömme dışı parametreyle ve yalnızca %8 daha fazla eğitim hesaplamasıyla daha düşük doğrulama kaybı elde ediyor. Bulgu, döngüsel mimarilerde 'kısalt' yerine 'daha az döngü ama hepsini eğit' stratejisini öne çıkarıyor.
Çapraz kipli yönlendirme vektörleri hem görüntü hem metin üretiminde var
Birleşik çok kipli modellerde metinle bulunan yönlendirme vektörleri, sıfır atışla görüntü üretimini de etkiliyor.
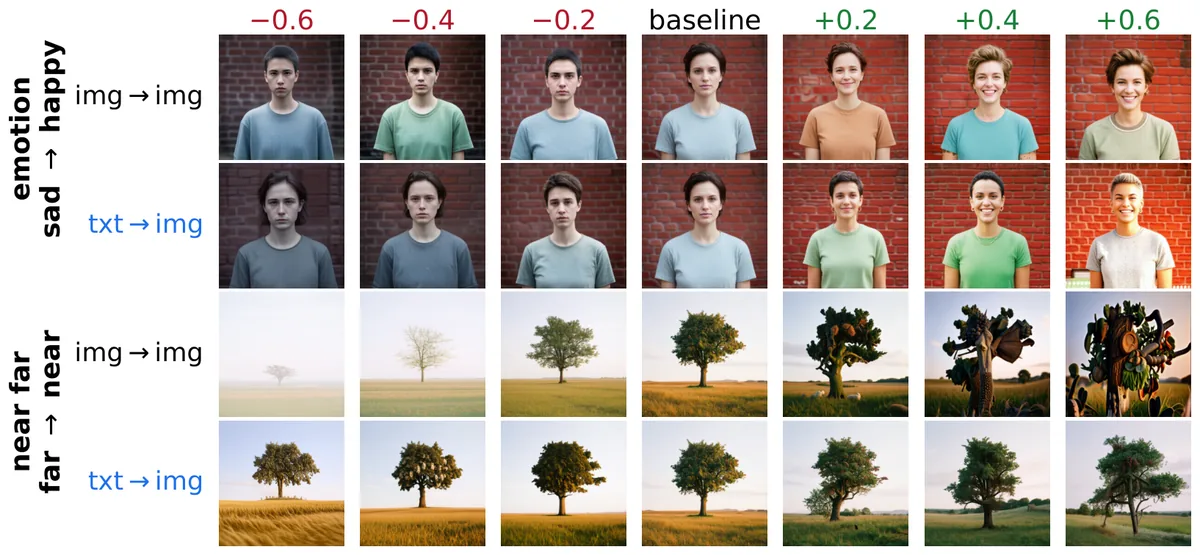
UniAR'da kipler arası ve kip içi yönlendirme: aktarılan vektör, kip içi vektörle benzer bir değişim üretiyor. Görsel: Zeng ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Güncel yapay zeka modellerinde kavramlar ve mekanizmalar kipler arasında birleşik mi, yoksa her kip için ayrı mı uygulanıyor? Çalışma bu soruyu çapraz kipli yönlendirme (cross-modal steering) üzerinden ele alıyor: bir kipin token'larında üretimi başarıyla yönlendiren vektörler bulunuyor, ardından bu vektörler başka bir kipin token'larına eklendiğinde üretimi sıfır atışla yönlendirip yönlendirmediği ölçülüyor. Yönlendirme nedensel bir müdahale olduğu için bu yaklaşım, temsil benzerliği gibi salt ilişkisel hizalamaların ötesine geçiyor.
Dil ve görüntü üretimi için ortak parametrelere sahip birleşik çok kipli modeller (UMM) incelendi. Duygu ve nesne boyutu gibi farklı kavramlarda, yönlendirme vektörlerinin her iki yönde de (metinden görüntüye ve görüntüden metne) sıfır atışla aktarıldığı gösterildi. Resmî ile günlük dil gibi tek bir kipe oldukça özgü kavramlarda bile vektörler, diğer kipte resmî giysi ve tasarım gibi tutarlı ve yorumlanabilir etkiler yaratıyor. Aktarımın geometrik bir izi de var: metin ve görüntü temsillerini ayıran belirgin kip boşluğuna rağmen, güçlü aktarılabilirlik gösteren vektörler aynı kavram için benzer yönleri işaret ediyor.
Bulgular, görü ve dilin birleşik çok kipli modellerin içinde nasıl etkileştiğine ışık tutuyor ve bu modellerin davranışını kontrol etmek için daha genel, kipten bağımsız yöntemlere işaret ediyor.
Rollback: Dünya modellerinde geri sarmayla politika iyileştirme
Rollback, dünya modelini geri sararak karşı olgusal gelecekleri keşfediyor ve robot politikasını iyileştiriyor.
Eyleme koşullu dünya modelleri, robot politikalarını iyileştirmek için maliyetli gerçek dünya etkileşimine ölçeklenebilir bir alternatif sunuyor. Ancak mevcut yöntemler dünya modellerini fiziksel ortamın yalnızca ileri yönlü vekilleri olarak kullanıyor; fiziksel ortamın sunamadığı bir yetenek, yani geçmiş karar noktalarına dönüp karşı olgusal gelecekleri keşfetme, kullanılmadan kalıyor.
Rollback, dünya modelini pasif bir simülatörden karşı olgusal bir motora dönüştürüyor: kritik karar noktalarına geri sarıyor, alternatif eylemlere dallanıyor ve sonuçları karşılaştırarak başarıyı tek tek kararlara atfediyor. Böylece hayal gücü en çok önem taşıyan yerlere yoğunlaşıyor ve ayrı bir değer modeli öğrenmeden eylem düzeyinde ince taneli denetim üretiliyor. Dağıtık dünya modeli aramasını eşzamansız gerçek robot yürütmesiyle birleştiren ölçeklenebilir bir eğitim sistemi kuruldu: gerçek deneyim dünya modelini keskinleştiriyor, keskinleşen model de politika iyileşmesini sürüyor. Yazarlar bu döngünün dünya modeli tarafına, hafif bir LoRA hattıyla gerçek geçişlerin dinamikleri düzeltmesine dayanan test zamanı fizik topraklaması adını veriyor.
Üç zorlu gerçek dünya görevinde (blok çıkarma, top fırlatma ve masa üstü curling) Rollback, en güçlü referans yönteme göre başarı oranını mutlak olarak sırasıyla %10,67, %11,11 ve %11,85 artırdı ve eğitim boyunca daha kararlı bir iyileşme gösterdi. Başlangıçta insan seviyesinin çok altındaki teleoperasyon gösterimleriyle başlatılmasına rağmen, 8 saatlik eğitim içinde top fırlatma ve masa üstü curlingde insan oyuncuların ortalama başarı oranını geçti.