2026-10-29Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bu sayıdaki işler aynı soruya farklı kapılardan giriyor: Makineler fiziksel dünyayı ne kadar güvenilir algılıyor, o algıyı nasıl eyleme çeviriyor? İnsan bedeninin üç boyutlu çatımından robotlar arası ortak dünya modellerine, piksel uzayı üretiminden difüzyon dil modellerinin öğrenme sinyaline kadar görü, kontrol ve üretim iç içe geçiyor. Açık ses ve yerel çıkarım sürümleri de bu fikirlerin kullanıma ne kadar hızlı ulaştığını gösteriyor. Birlikte okununca ilerlemenin tek bir alanda değil, bu kesişimlerde olduğu görülüyor.
1.Araştırma
UT-HMR: Belirsizlik Güdümlü 3B İnsan Ağı Geri Çatımı
UT-HMR, belirsizliği ve zamansal bilgiyi birleştirerek spor sahnelerinde 3B insan ağı geri çatımını sağlamlaştırıyor.
Zhibo Wang ve ekibi, tek kameralı 3B insan ağı geri çatımında (HMR) belirsizliği açıkça modelleyen UT-HMR çerçevesini tanıttı. Uzak mesafe, örtüşme ve hareket bulanıklığı gibi zayıf gözlemler, farklı 3B pozların benzer 2B izdüşümler vermesine yol açıyor; kırpma veya harici 2B ipucu kullanmayan tek aşamalı HMR yöntemlerinde bu belirsizlik daha da ağır. UT-HMR, eklemler arası ilişkili poz belirsizliğini yakalayan ilk tek aşamalı HMR çerçevesi olarak sunuluyor. Her kişi sorgusu, düşük ranklı artı köşegen kovaryansa sahip bir Gauss dağılımı tahmin ediyor. Bu dağılım, eklem bazlı hassasiyet ağırlıklarına dönüştürülerek heteroskedastik denetimde kullanılıyor; çıkarım ise deterministik kalıyor. Zamansal erken füzyon, poz çözülmeden önce komşu karelerden kanıt ekleyerek belirsizliği gidermeye yardımcı oluyor. Hafif bir ViT-B omurgasıyla UT-HMR, buz hokeyi (VIP-HockeyPose-v2) ve futbol (WorldPose) veri kümelerinde MPJPE, PA-MPJPE ve PVE hatalarını sırasıyla %4,7, %3,8 ve %5,6'ya varan oranlarda düşürüyor. 3DPW'de ise daha büyük omurgalı ve yüksek çözünürlüklü yöntemlerle rekabetçi kalıyor. Çalışma, hareketli ve kalabalık sahnelerde güvenilir poz tahmini için belirsizliği modellemenin pratik bir yol olduğunu gösteriyor. Makale WACV 2027'de kabul edildi.
RynnWorld-Latent: Robotlar Arası Evrensel Örtük Eylemli Dünya Modeli
Ortak örtük eylem arayüzü, insan videoları, robot gösterimleri ve simülasyonla tek modelde ön eğitim imkânı veriyor.
DAMO Academy'den araştırmacılar, farklı robot gövdelerinin eylem uzaylarının birbiriyle uyumsuz olması ve insan videolarında kontrol etiketlerinin bulunmaması sorununa RynnWorld-Latent ile yanıt veriyor. Model, RynnLAM'in 3B temelli örtük eylemlerini ortak bir koşullandırma arayüzü olarak kullanıyor; böylece ortak bir yerel eylem uzayı gerekmeden insan etkileşim videoları, robot gösterimleri ve simülasyon verileri birlikte ön eğitime girebiliyor. Önceden eğitilmiş bir video transformer üzerine kurulan sistem, küresel eylem token'larını, eylemleri gelecek video örtüklerine hizalayan kimlik başlatmalı yerel bir yolla birleştiriyor. Ön eğitimde yaklaşık 553,5 milyon karelik 23 veri kümesi kullanılıyor; hedef robota uyum ise ardıl eğitimle sağlanıyor. Çerçeve iki veri üretim yolunu destekliyor: dijital teleoperasyon, hedef robot komutlarından eylem-video gösterimleri üretirken, örtük eylem sentezi kaynak hareketi düzenlenmiş bir başlangıç karesine aktarıp yeniden hedeflenmiş sözde robot eylemleriyle eşleştiriyor. Deneyler, genel kıyaslamalarda ve iki gerçek robot platformunda video tahmin metriklerinde iyileşme gösteriyor. Sentetik ara eğitim, LIBERO ve LIBERO-Plus'ta politika başarı oranlarını artırıyor; her iki üretim yolu da değerlendirilen ortamlarda yalnızca gerçek gösterimle eğitime kıyasla gerçek dünya başarısını yükseltiyor. Sonuçlar, evrensel örtük eylemlerin heterojen gövdeler arasında ölçeklenebilir bir arayüz olabileceğini destekliyor.
Wiener Bilgili Kod Çözme ile Piksel Uzayı Akış Modelleri
WiD, ikinci dereceden görüntü istatistiklerini kullanarak piksel uzayı akış modellerinin eğitimini hızlandırıyor.
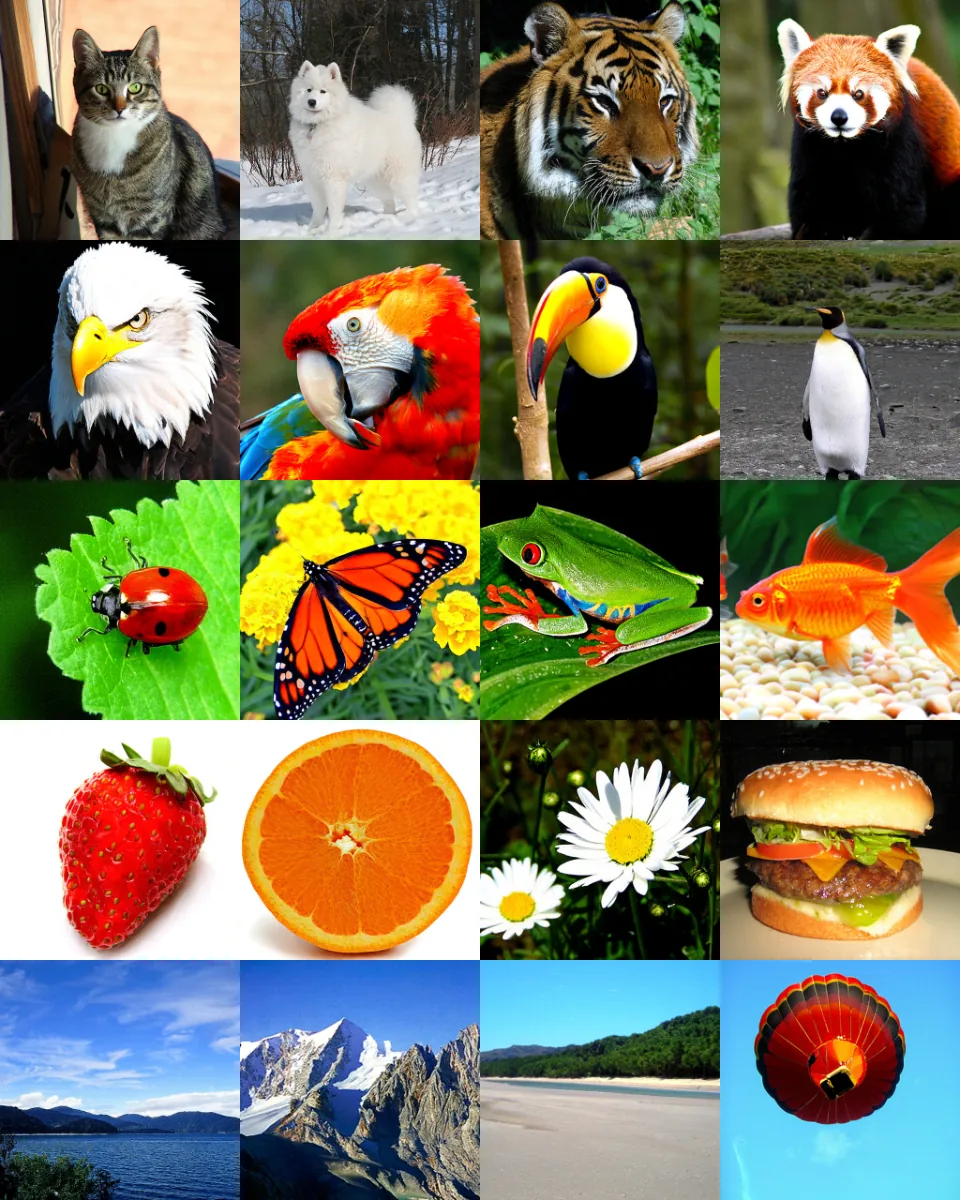
WiD ile eğitilen PixelDiT-XL/16 modelinin 260+50 epoch sonunda ürettiği 512×512 örnekler; üretimde time-shift 2.0 ve w = 4.0 ile classifier-free guidance kullanıldı. Görsel: Wang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Hız alanlarını doğrudan piksel uzayında öğrenmek zor ve yavaş bir iş. Yeni çalışma, kaba ikinci dereceden görüntü istatistiklerinin bu işi kolaylaştırdığını gösteriyor: donmuş Wiener tahminleri hız öğrenmeyi iyileştiriyor ve kazanç, açıkça sağladıkları doğrusal tahminlerin ötesine geçiyor. Araştırmacılar ayrıca donmuş tabanlar ve piksel kod çözmeden benzer, ancak tamamlayıcı kazançlar gözlemlemiş. Bu gözlemlerden doğan Wiener-informed Decoding (WiD), istatistiksel bilgiyi hem doğrudan tahmin hem de kod çözücü hesaplamasını düzenlemek için kullanıyor; yerel blokları değiştirmeden eğitilebilir bir Wiener tahmin yolunu, özellikleri yerel kod çözücüye aktaran ve düzeltmeleri geri döndüren katsayı arayüzleriyle birleştiriyor. Eklenen tüm parametreler, spektrum ve koordinat dönüşümleri dahil, özgün piksel uzayı hız amacı altında birlikte eğitiliyor. Farklı model ölçekleri ve kod çözücü mimarilerinde WiD, mütevazı bir parametre maliyetiyle eğitimi hızlandırıyor ve üretim kalitesini artırıyor; daha pürüzsüz gradyan yörüngeleri veriyor ve temsil hizalamasıyla da etkili kalıyor. ImageNet 256×256'da WiD'li PixelDiT-XL, 500 epoch sonunda FID 1,53'e ulaşıyor ve PixelDiT ile benzer kaliteyi %37,5 daha az epoch ile yakalıyor. Çalışma, istatistiksel gürültü gidericilerin yalnızca tahminleriyle değil, hesaplama yapılarıyla da piksel uzayı eğitimini kolaylaştırdığını gösteriyor.
llama.cpp v0.8.0: LFM3 Ailesi ve Gerçek Zamanlı Ses
llama.cpp v0.8.0, LFM3 ailesini, akışlı ses API'sini ve /v1/realtime uç noktasını getiriyor.
llama.cpp'nin v0.8.0 sürümü, LiquidAI'nin LFM3 ailesini (metin, görü, ses ve omni) ve mtmd içinde yeni, deneysel bir akışlı ses API'sini getiriyor. Sunucu tarafında gerçek zamanlı ses girişi ve çıkışı, yeni /v1/realtime ve /tts uç noktalarıyla sağlanıyor; /v1/realtime, konuşma ve transkripsiyon için OpenAI'nin gerçek zamanlı protokolünü uyguluyor. LFM3-Audio-2B ve LFM3-Omni-2B, tek bir modelden ASR, TTS ve sesli sohbet sunuyor. Sürümde ayrıca DeepSeek V4.1 Flash, SenseNova U1, Beam, Kolibri-1, Flint, Muse Spark ve Granite Switch Decision gibi yeni mimariler ile LiquidAI, Baidu ve NVIDIA'nın karar/gömme modelleri yer alıyor. Çekirdekte seyrek dikkat (QSA/DSA), kaynaştırılmış maskeleme işlemi üzerine yeniden düzenlendi; ana belleğe alınan MoE uzmanları için 50/50 SLRU önbelleği ve daha temiz no_alloc bellek yönetimi eklendi. Sunucuda yönlendirici bellek yönetimi ve araç çağırma iyileştirmeleri var. Arayüz artık HF Hub'dan model gezip indirebiliyor, konuşmalarda arama yapılabiliyor ve konuşmalar sıkıştırılabiliyor. ggml, v0.28.0'a yükseltildi; bu da GGML_OP_TOP_K_MASK, -1 uzman indeks anlamı ve CUDA, SYCL, OpenCL, Hexagon HTP ile KleidiAI SVE çekirdeklerinde kapsamlı performans iyileştirmeleri getiriyor. API tarafında DRY örnekleyicisinin ayrık dizi kesicileri LLAMA_DRY_MAX_SEQ_BREAKERS (64) ile sınırlandı ve mtmd'de ses üretimi artık durumlu (mtmd_gen_state).
Duyusal-Motor Hizalama: Robot Politika Başarısı İçin Platonik Vekil
S², robot temel modellerini maliyetli rollout'lar yerine çevrimdışı ve eğitimsiz biçimde sıralamaya yarıyor.
Robot temel modelleri genellikle maliyetli kapalı döngü rollout'larla değerlendiriliyor. Yunfei Xie ve ekibi, Platonik Temsil Hipotezi'ni (PRH) robotiğe taşıyarak hareket yörüngelerinin de görü ve dil gibi ortak bir gerçeklik modeline yakınsayan bir modalite olup olmadığını soruyor. Bunu test etmek için önerilen Sensorimotor Alignment (S²), eğitim gerektirmeyen, çevrimdışı bir metrik: bir modelin duyusal temsilinin fiziksel hareket geometrisiyle ne kadar örtüştüğünü ölçüyor. Bulgulara göre S², farklı model aileleri arasında aşağı akış robot görev başarısıyla pozitif korelasyon gösteriyor. Böylece araştırmacılar, kapalı döngü değerlendirmeye geçmeden önce modelleri sıralamak için düşük maliyetli bir vekil metriğe sahip oluyor. S², maliyetli ince ayarla görü-dil-eylem (VLA) modeline dönüştürülmeden önce umut vaat eden görü-dil modeli (VLM) omurgalarını belirlemeye de yarayabiliyor. Korelasyonun ötesinde yöntem, VLA'larda ve dünya eylem modellerinde (WAM) gözlenen olgulara temsil düzeyinde açıklamalar da getiriyor. Örneğin bir modelin neden belirli görevlerde diğerlerinden daha başarılı olduğu, yalnızca başarı oranlarına bakarak değil, temsillerin hareket geometrisiyle uyumuna bakılarak yorumlanabiliyor. Çalışma, PRH'yi robotiğe genişleterek duyusal-motor hizalamayı ölçülebilir hale getiriyor.
NVIDIA, Microduck örneğinde ajanlarla varlık üretimi, Isaac Lab eğitimi ve yerel doğrulamayı uçtan uca gösteriyor.
NVIDIA, Microduck robotunu örnek alarak engelli parkurda gezinen bir politikanın uçtan uca nasıl geliştirileceğini anlatıyor. İş akışında yerel geliştirme merkezi NVIDIA RTX Spark: Hermes ve Nemotron 3.5 Bolt gibi ajanlar bir istemi adım adım proje planına çeviriyor, Astra ise bu plandan 3B simülasyon varlıkları üretiyor. Bulut görüntü düzenlemeyle referanslar zenginleştiriliyor, geometri FreeCAD'de modelleniyor, malzemeler Blender'da uygulanıyor ve düzenlenebilir modeller ile USD varlıkları dışa aktarılıyor. Parkur, işleme ve sensör simülasyonu için Omniverse kütüphanelerini, Microduck'ın hareketi ile dengesinin fizik modellemesi için Newton'ı kullanan NVIDIA Isaac Sim'de kuruluyor. Algı ve yürüyüş politikası, NVIDIA RTX PRO 6000 Blackwell Workstation Edition GPU üzerinde 4.096 paralel ortamla Isaac Lab'de büyük ölçekte eğitiliyor; gözlemler baş kamerası derinliği ve robot durumundan oluşuyor. Eğitilen politika, engel algılama, hareket ayarlama ve parkuru tamamlama açısından yerelde RTX Spark üzerindeki Isaac Sim'de doğrulanıyor. Gerçek robota aktarım için Better Actuator Models ve alan rastgeleleştirmesi hazırlığı öneriliyor. Yazı, simülasyondan gerçeğe geçiş adımları için Hugging Face'teki Microduck eğitimini ve Isaac Lab belgelerini yönlendirme olarak sunuyor.
NVIDIA'nın Açık Nemotron 3.5 Transcribe Modeli Tek Çatı Altında
Nemotron 3.5 Transcribe, transkripsiyon, çeviri ve konuşmacı tanımayı metin talimatlarıyla tek modelde birleştiriyor.
NVIDIA, metin talimatlarıyla yönlendirilen açık bir konuşma tanıma modeli olan Nemotron 3.5 Transcribe'ı yayımladı. Model 40 dili transkribe ediyor, 31 dilde İngilizceye veya İngilizceden çeviri yapıyor ve 13 dilde konuşmacıları ayırt ediyor; sekiz konuşmacıya kadar, bir saate varan kayıtları işleyebiliyor. Aynı toplantı kaydı, istemine göre konuşmacı etiketli bir transkripte, İngilizce çeviriye veya alınan kararların özetine dönüşebiliyor; kullanıcılar ilaç adı gibi teknik terimleri ipucu olarak verebiliyor, model bunları yalnızca kayıtta gerçekten geçiyorsa kullanıyor. Modelin 30 milyar parametresi var, ancak işlem adımı başına yalnızca yaklaşık 4 milyarı etkin; bu sayede tek bir NVIDIA GPU'da çalışıyor. NVIDIA, RTX PRO 6000 Blackwell Server Edition üzerinde NVFP4 hassasiyetiyle 100 saatlik sesin üç dakikadan kısa sürede işlendiğini belirtiyor. Hugging Face'in İngilizce Open ASR Leaderboard'unda açık ağırlıklı modeller arasında ortalama %5,33 kelime hata oranıyla ilk sırada; Artificial Analysis karşılaştırmasında ise %2,81 ile en iyi açık model Voxtral Small'un (%2,77) çok yakınında, ancak yaklaşık altıda biri kadar etkin parametreyle. Sürümle birlikte 844.000 saatlik sesten oluşan Granary v2 veri kümesi ve modeli tıp gibi uzmanlık alanlarına verimli biçimde uyarlamaya yarayan araçlar da paylaşılıyor.
DTCA: Difüzyon Dil Modellerinde Token Düzeyinde Kredi Atama
DTCA, difüzyon dil modellerinde pekiştirmeli öğrenmeyi token katkılarına göre yönlendirerek matematik başarımını artırıyor.
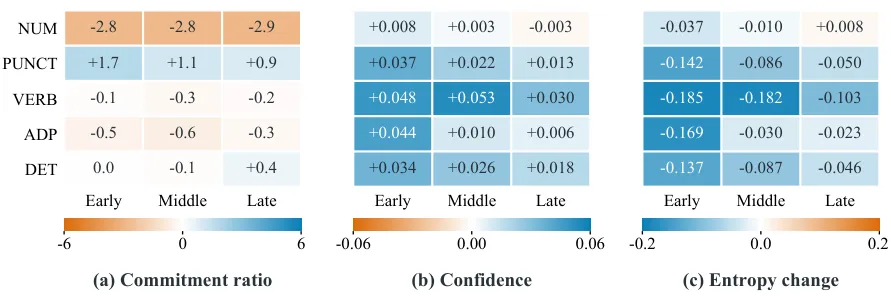
MATH500 üzerinde DTCA ile temel model arasındaki fark, üç gürültü giderme aşamasında token taahhüt oranı, taahhütteki güven ve entropi açısından karşılaştırılıyor. Görsel: Chen ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Difüzyon dil modelleri (DLM), metni yinelemeli gürültü giderme ile üretiyor; bu da çift yönlü bağlam modellemesi ve paralel token iyileştirmesi sağlıyor. Pekiştirmeli öğrenme (RL) bu modellerin akıl yürütme performansını artırmış olsa da yinelemeli süreç, kredi atamayı zorlaştırıyor: nihai ödül, hangi token'ın sonuca ne kadar katkı yaptığı hakkında sınırlı bilgi veriyor. DTCA (Denoising Token Credit Assignment), token katkılarını, bir token sabitlendikten sonra kalan maskeli konumlardaki tahmin güveninin ne kadar arttığına bakarak kestiriyor ve bu sinyalleri sözcük türü (POS) kategorilerine göre grupluyor. Elde edilen ağırlıklar, bilgilendirici gürültü giderme zaman adımlarını seçmek ve RL eğitiminde token düzeyinde öğrenme sinyalleri atamak için kullanılıyor. DTCA ayrıca bu sinyalleri, politika güncellemelerinin tetiklediği token düzeyinde entropi değişimlerine göre kalibre ediyor. LLaDA-8B-Instruct üzerindeki deneylerde DTCA, farklı üretim bütçelerinde matematiksel akıl yürütmeyi tutarlı biçimde iyileştiriyor; temel modele göre MATH500'de 9,0 puana, GSM8K'da 5,3 puana varan kazançlar sağlıyor. Çalışma, farklı sözcük türlerinin yanıta eşit katkı yapmadığı sezgisinden yola çıkarak, ödül sinyalini token katkılarına yaklaştırmanın DLM'lerde RL için etkili bir yol olduğunu gösteriyor.