2026-11-02Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayının ortak ipliği, yapay zekanın hem daha hızlı hem de daha anlaşılır hale gelmesi: difüzyonu hızlandıran mimari ayrıntılardan, muhakemenin ilk adımlarına ve sürüş modellerinin iç işleyişine kadar, sistemlerin neden böyle çalıştığını sorguluyoruz. Robotik, fizik ve konuşma gibi farklı alanları yan yana okumak, aynı ilkelerin her yerde yankılandığını gösteriyor. Hızı, kontrolü ve şeffaflığı tek bir resimde görmek için bu sayıya göz atın.
1.Araştırma
Difüzyon hızlanmasının sırrı artık kapılarda
REPA ve dağıtıcı düzenlileştirme, AdaLN-Zero artık kapılarını yeniden düzenleyerek difüzyon eğitimini hızlandırıyor.
Araştırmacılar, REPA ve dispersive regularization gibi yöntemlerle hızlanan difüzyon transformatörlerinde dikkat çekici bir iç değişim buldu: koşullu güncellemelerin artık akışa nasıl girdiğini belirleyen AdaLN-Zero artık kapısı α, bu yöntemlerle belirgin biçimde yeniden düzenleniyor. Hızlanmış modeller α'daki bozulmalara çok daha duyarlı hâle geliyor ve kapı geometrisi sınıflar arasındaki anlamsal ilişkileri yansıtıyor. Ekip, kapıların kanal bazlı organizasyonunu ölçmek için normalleştirilmiş katılım oranı (nPR) adlı bir metrik geliştirdi. Farklı REPA öğretmenleri ve projektör mimarilerinde yapılan deneyler, kapı katılımı genişledikçe üretim kalitesinin de arttığını gösterdi. Bu içgörüden yola çıkan yazarlar, öğretmen gerektirmeyen ve ikili özellik karşılaştırması yapmayan basit bir radyal hedef önerdi. Yöntem, özellik normu düzenlileştirmesi aracılığıyla kapı katılımını teşvik ediyor. ImageNet 256×256 üzerinde SiT-B/2 ile yapılan testlerde bu yaklaşım, dispersive loss'a kıyasla daha iyi FID değeri verdi. Bulgular, difüzyon eğitimindeki hızlanmanın yalnızca dışarıdan dayatılan özellik yapılarıyla değil, artık geçit yolunun yeniden şekillenmesiyle de açıklanabileceğini ortaya koyuyor. Yazarlar, artık kapıların yeniden düzenlenmesini difüzyon eğitimindeki hızlanmanın ölçülebilir bir ekseni olarak tanımlıyor ve bunun daha fazla hızlanma için basit bir yön gösterdiğini öne sürüyor.
Yeni görevlerin videosu, eylem etiketi olmadan bile robot başarısını %25'ten %56'ya çıkardı.
Robot öğrenmede görevler arası genelleme hâlâ temel zorluklardan biri. WorldBridge çalışması bu soruyu World Action Models (WAM) üzerinden iki yetenekle inceliyor: yeni görevlerin görsel evrimini tahmin eden video genellemesi ve bu tahminleri yürütülebilir davranışa çeviren eylem genellemesi. RoboTwin 2.0'da yalnızca dağılım içi video-eylem verisiyle eğitilen model, dağılım dışı görevlerde %25,07 başarı sağlıyor. Bu görevlere ait eylem etiketi olmayan videolar eklenince başarı %55,90'a, görev başına yalnızca tek bir etiketli demonstrasyon eklenince %70,70'e çıkıyor. Bulgular, geniş video kapsamının modelin mevcut ters dinamik yeteneklerinden yararlanarak görev aktarımını mümkün kıldığını, seyrek eylem denetiminin ise bu yetenekleri güçlendirdiğini gösteriyor. Bu bakışla geliştirilen WorldBridge, yapılandırılmış dikkatle birbirine bağlanan ayrı video ve eylem uzmanlarını ortak flow matching ile eğitiyor; ayrıca iki zaman ölçeğinde görsel bellek ve action forcing kullanıyor. Model, RoboTwin 2.0 tam veri ayarında %96,23, RoboCasa GR1 TableTop'ta %82,8 ve DOMINO Level-1'de %57,6 ile karşılaştırılan yöntemler arasında en iyi sonuçları veriyor. Çalışma, video tahmini ile eylem temellendirmesinin birbirini tamamladığını ve etiketsiz videonun robot öğrenmede değerli bir kaynak olduğunu ortaya koyuyor.
REA, yavaş temel modeli hızlı politikalardan ayırıyor; LIBERO-Pro'da %95,9 başarı ve %25 daha az kontrol adımı.
Temel modeller üst düzey muhakemede güvenilir hâle geliyor ancak ince taneli denetleyici olarak çok yavaş ve maliyetli. VLA ve tüm vücut denetleyicileri gibi hızlı politikalar ise verimli refleksler sunsa da genelleme yapamıyor. REA (Routed Embodied Agent), düşünen bir System 2, bir yönlendirici System 1 ve reaktif System 0 politikalarını tek bir çalışma zamanında birleştiriyor; temel kural, hiçbir çalışan politikanın beyni beklememesi. Sistem, her hatada beyne başvurmak yerine politikaların başarısını önceden ölçüp saklayan bir rota belleği, politika yürütmesi sınırlarında devreye giren bir yargıç kapısı ve paylaşımlı bütçeli kademeli kurtarma mekanizması kullanıyor. LIBERO-Pro'daki 60 görev ve 3.000 test bölümünde REA %95,9 başarıya ulaşarak kendi politika havuzundaki en iyi tekil ajanı (%94,7) geride bırakıyor; kontrol adımlarını %25, kontrol süresini %17 azaltıyor. RoboTwin 2.0'da VLA politikalarıyla %84, VLA+kod ile %86 başarı elde ediliyor (en güçlü tekil VLA: %80). Yöntem BEHAVIOR-1K'ya ve gerçek bir Unitree G1 insansı robota da aktarılarak karşılaştırılan yöntemler arasında en yüksek başarıyı sağlıyor.
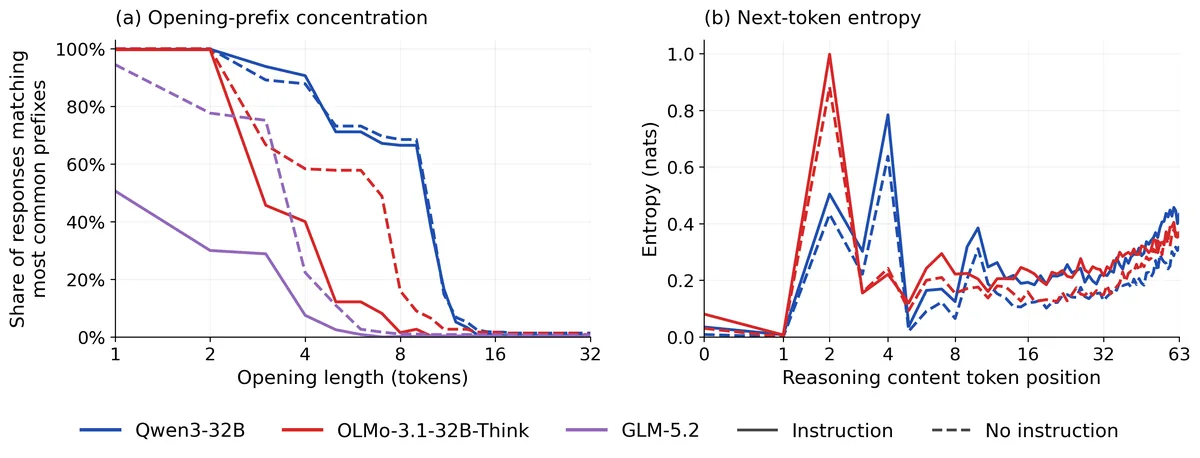
CoT kontrol edilebilirliğinin sınırı, ilk token'lardaki entropi çöküşüne bağlanıyor.
Muhakeme modellerinde düşünce zincirinin açılışı bir darboğaz oluşturuyor; kontrol edilebilirliğin sınırı ilk birkaç token'da belirleniyor. Görsel: Van Deventer ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Düşünce zinciri (CoT) izleme, giderek güçlenen ajanları denetlemek için umut verici bir yol; bunun bir nedeni, mevcut modellerin muhakeme izlerinde neyi dile getirdiklerini kontrol etmekte sınırlı olması. Çalışma, bu sınırlamanın kaynağını açılış düşünme etiketinden hemen sonraki ilk birkaç token'daki entropi çöküşüne bağlıyor. Araştırmacılar bu mekanizmayı iki çıkarım zamanı müdahalesiyle kullanıyor: tek bir token'lık prefilling bile kontrol edilebilirliği belirgin artırabiliyor; sık kullanılan açılış token'larını yasaklamak ve bağlam içi örneklerle birleştirmek ise modeller genelinde ortalama uyumu 34–41 puan yükseltiyor. Müdahaleler ağırlıklı olarak ekleme ve stil kontrolünü (bilgi ekleme veya dönüştürme) geri kazandırıyor; bastırma kontrolü (bilgiden kaçınma veya silme) ise daha değişken tepki veriyor. İki grup ayrı yetenekler gibi davranıyor: grup içi performans korelasyonu pozitif, gruplar arası çoğunlukla negatif. İzlenebilirlikle ilişki de değerlendirmeye göre değişiyor: ekleme ve stil daha tutarlı biçimde pozitif, bastırma ise çoğunlukla negatif ilişkili. Bulgular, belirli bir açılışı başlatma güçlüğünü genel muhakeme içeriğini değiştirme sınırından ayıran kontrol edilebilirlik değerlendirmelerine ihtiyaç olduğunu gösteriyor.
Birleşik multimodal modeller sürekli uzayda düşünüyor
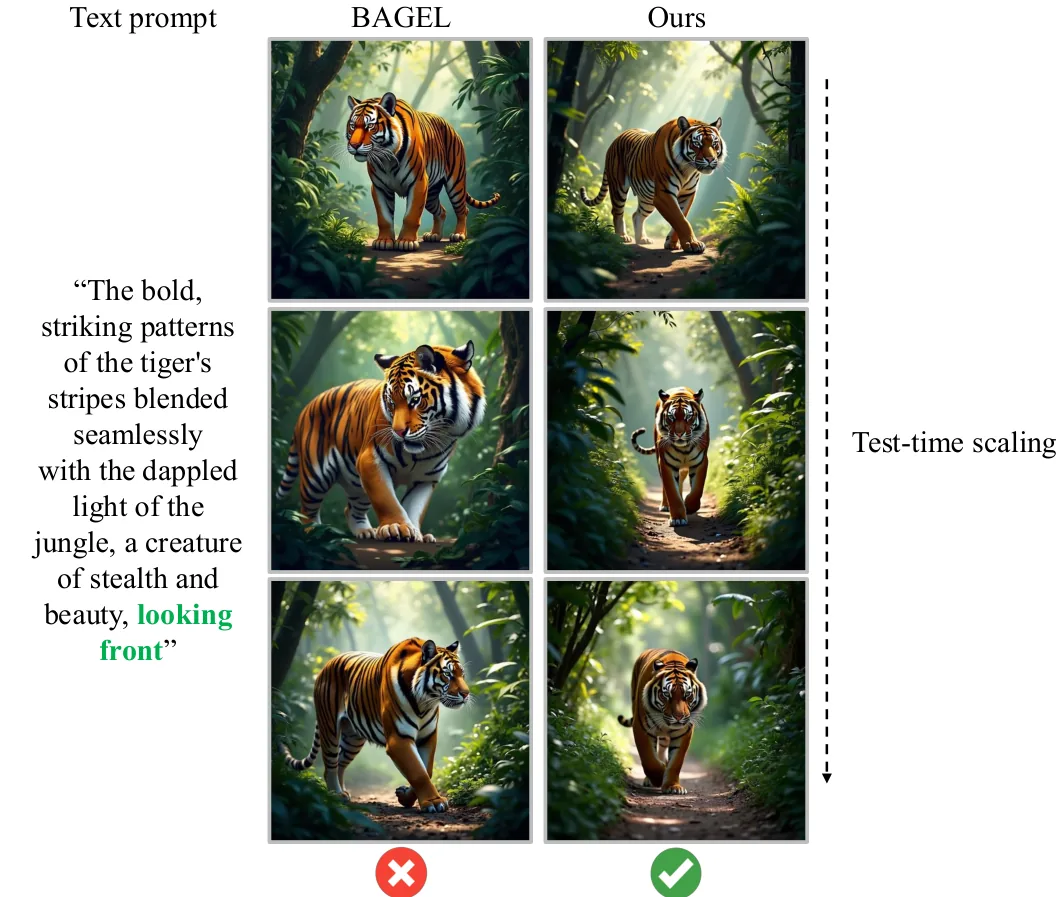
LARC, görüntü üretiminde muhakemeyi ayrık token'lar yerine sürekli gizli durumlarda yapıyor; GenEval'de BAGEL'e +7 puan.
Test anında en iyi N örnekleme yapan BAGEL ile L gizli adımlı LARC, N = L = 1, 4 ve 10 için görüntü üretiminde yan yana karşılaştırılıyor. Görsel: Jeon ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Birleşik Multimodal Modeller (UMM) anlama ve üretim görevlerinde başarılı olsa da dil tabanlı düşünce zincirini görüntü üretimine etkin biçimde katamıyor. Sonuçta test zamanı ölçeklenmesi ve ince taneli kontrol, büyük dil modellerindeki düzeye ulaşamıyor. Yazarlar bunu bir modalite uyumsuzluğuna bağlıyor: muhakeme ayrık token uzayında, görüntü üretimi ise sürekli uzayda yürüyor. LARC (Latent Reasoning in Continuous space) bu boşluğu, muhakemeyi doğrudan sürekli gizli durumlar üzerinde yaparak kapatıyor. Eğitim iki aşamalı ilerliyor. İlk aşamada müfredat tabanlı denetimli ince ayar (SFT), token düzeyindeki muhakemeyi kademeli olarak örtük muhakemeye dönüştürüyor. İkinci aşamada bilgi kazancı tabanlı pekiştirmeli öğrenme (RL), örtük muhakemeyi referans doğru denetimi olmadan kendi kendine geliştiriyor. Çeşitli metinden görüntüye benchmark'larda LARC; üretim kalitesini, istem takibini ve kompozisyonel doğruluğu tutarlı biçimde iyileştiriyor. GenEval'de BAGEL'e göre 7 puanlık kazançla en iyi sonuca ulaşıyor ve hem paralel hem ardışık test zamanı ölçekleme stratejilerinde token tabanlı üretimi geride bırakıyor. Yazarlara göre muhakemeyi sürekli gizli durumlar üzerinde yürütmek token düzeyindeki darboğazı hafifletiyor; deneyler de görüntü üretiminde belirgin bir test zamanı ölçekleme davranışı ortaya koyuyor.
500 milyon simüle olay üzerinde önceden eğitilen EVENET, CMS Open Data'da ϒ mezonunu yeniden keşfetti.
Çarpıştırıcı deneyleri, kısmen gözlenen yüksek boyutlu ölçümler arasında aktarılabilen modellere ihtiyaç duyuyor; ancak analizlerin çoğu hâlâ her görev için ayrı bir model optimize ediyor. Nature Machine Intelligence'ta yayımlanan çalışma, 500 milyon simüle çarpışma olayı üzerinde kendi kendine öğrenme ve fizik temelli denetimle önceden eğitilmiş, olay düzeyinde bir temel model olan EVENET'i tanıtıyor. Model, her olaydaki değişken uzunluklu fizik nesneleri kümesinden ortak bir parçacık bulutu temsili oluşturuyor. Ağır rezonans aramalarında ve egzotik Higgs bozunmalarında EVENET, yerleşik ve son teknoloji referans yöntemleri geride bırakıyor; fark özellikle düşük istatistikli rejimlerde belirginleşiyor. Gerçek veriye aktarım ise CMS Open Data'da ϒ mezonunun yeniden keşfiyle doğrulandı. Önceden eğitilmiş model ayrıca, test edilen sistematik varyasyonlar altında kararlı kalan kuantum korelasyon gözlenebilirlerinin hassas çıkarımını da destekliyor. Bulgular, bir defalık önemli bir ön eğitim yatırımı karşılığında alt görevlere uyarlamayı iyileştiren, farklı çarpıştırıcı analizlerinde yeniden kullanılabilir bir omurga ortaya koyuyor. Çalışma böylece her analiz için ayrı model optimize etme darboğazına, bir kez önceden eğitilip farklı görevlere uyarlanabilen ortak bir modelle yanıt veriyor.
Seyrek otomatik kodlayıcılar, sürüş modelinde rota niyetini denetimsiz olarak %98,3 doğrulukla buldu.
Uçtan uca (E2E) otonom sürüş modelleri güçlü planlama performansı sunsa da büyük ölçüde opak kalıyor; bu da gözlemlenebilirliği ve güveni sınırlıyor. Çalışma, tek kameralı basit bir E2E yol planlama modelinin iç aktivasyonları üzerinde Seyrek Otomatik Kodlayıcılar (SAE) eğiterek mekanistik yorumlanabilirliği sürüş alanına uyguluyor. SAE gizli değişkenlerinin denetimsiz kümelenmesi, rota niyeti, araç hızı ve frenleme davranışıyla uyumlu yorumlanabilir yapılar ortaya çıkarıyor; rota niyeti denetimsiz olarak %98,3 doğrulukla geri kazanılıyor. Eşli karşı-olgusal görüntü düzenlemeleri, belirli SAE özelliklerinin görsel olarak temellendiğini ve trafik ışığı durumu ile dur işareti varlığı gibi sahne değişikliklerine sistematik yanıt verdiğini gösteriyor. Tekil SAE gizli değişkenlerini yönlendirmek ise yanal sapma, eğrilik ve frenleme gibi planlayıcı çıktılarında öngörülebilir, monoton değişimler üretiyor. Pratik bir uygulama olarak SAE gizli değişkenleriyle eğitilen hafif bir adaptör, yörünge seçim hatasını %3,44 azaltıyor ve SAE kullanmayan eşdeğer adaptörü geride bırakıyor. Çalışma CoRL 2026'da kabul edildi; kod ve görselleştirmeler açık. Bulgular, en azından bu basit, tek kameralı planlayıcıda modelin iç temsillerinin hem yorumlanabildiğini hem de doğrudan yönlendirilebildiğini gösteriyor.
Apriel Voice 27B: Konuşma, muhakeme ve araç kullanan açık model
Gemma 4 26B-A4B üzerine kurulu açık ses-dil modeli, Big Bench Audio'da 98,90 puan aldı.
Yetkin bir sesli asistan yalnızca kelimeleri tanımakla kalmaz; istekleri anlar, bağlam üzerinde muhakeme yürütür, konuşmayı sürdürür ve araçlarla eyleme geçer. Apriel Voice 27B Preview, bu yetenekleri ortak bir muhakeme omurgasında birleştiren, metin ve görüntü girdi kiplerini de koruyan açık bir konuşma-dil modeli. Eğitim sonrası Gemma 4 26B-A4B kontrol noktası üzerine kurulu model, konuşmayı doğrudan işleyip hem yanıt hem araç çağrısı üretiyor; ayrı bir diyalog modeline gerek kalmıyor. İki aşamalı eğitimde önce konuşma arayüzü kuruluyor, ardından projektör ve omurga; denetimli ince ayar, metin tekrarı ile kaynağa bağlı çapraz entropi ve ileri KL ıraksaklığı denetimiyle birlikte uyarlanıyor. Otomatik oluşturulan konuşma koşullu diyaloglar eğitim verisini sağlarken, yerel öğretmen sunumu ve öğretmen-öğrenci hesaplamalarının örtüşmesi verimli çevrimiçi damıtmayı mümkün kılıyor. Düşünme modunda model, Big Bench Audio'da 98,90, Speech-BFCL'de 81,13 puan ve τ-Voice'ta %65,51 görev başarısı elde ederken ortalama gecikme 1,91 saniye. İngilizce EVA doğruluğu %51,27, deneyim pass@1 ise %74,13. Model özel bir sunum platformunda interaktif sesli etkileşimler için dağıtıldı.