2026-11-03Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünün sayısını bir arada tutan soru şu: bir model dünyayı nasıl temsil ediyor ve bu temsilin bedelini kim ödüyor? Eylem temsillerinden çok kipli gömmelere, ajan belleğinden ağırlıkların kendisine kadar, her çalışma temsili hem daha verimli hem de daha denetlenebilir kılmaya çalışıyor. Aynı sayfalarda okununca, robotik ve dil modelleri arasındaki sınırın hızla aşındığı ve ortak ilkelerin ortaya çıktığı görülüyor.
1.Araştırma
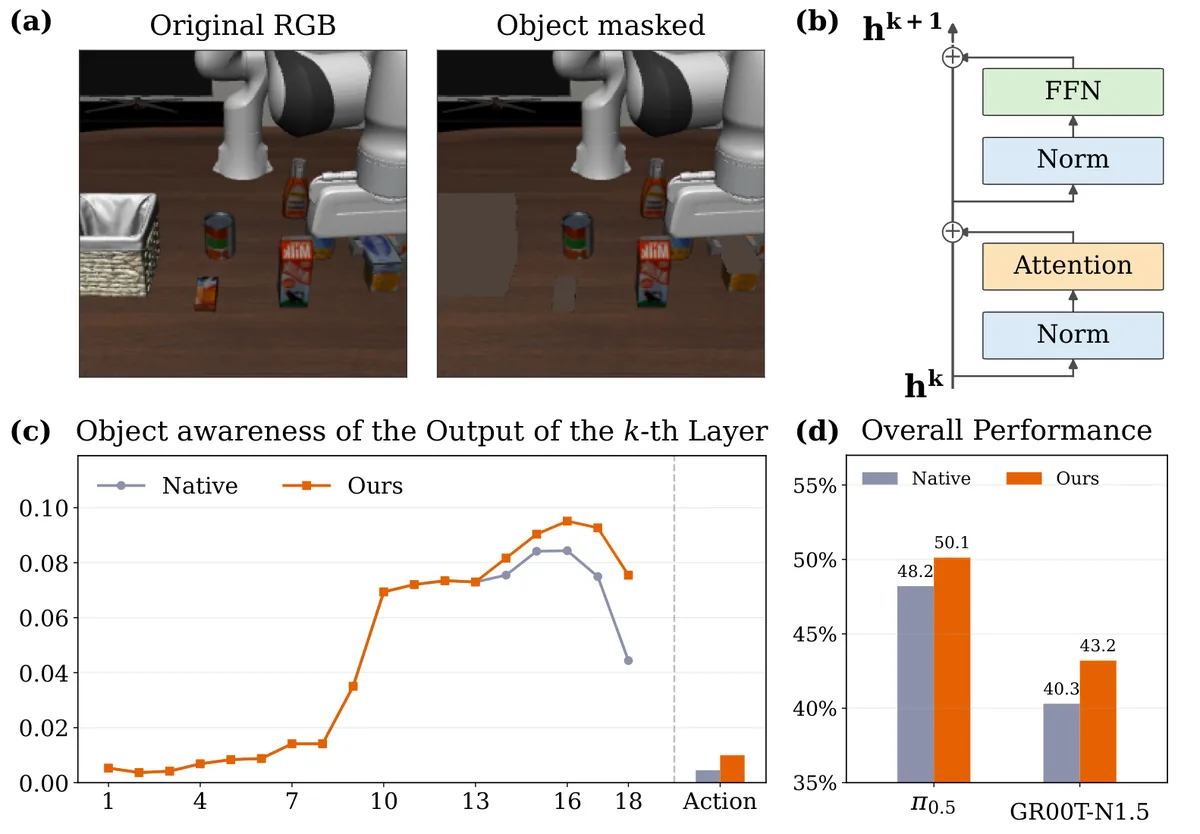
STAR: Çıkarım Sırasında Eylem Temsillerini Yönlendirme
Eğitim gerektirmeyen STAR, VLA modellerinin görev başarısını ortalama 4 puan artırıyor.
VLA çıkarımında katman düzeyinde nesne farkındalığı: görevle ilgili nesneler görüntüden maskelenerek, eylem temsillerinin katmanlar boyunca nesne bilgisine ne kadar duyarlı olduğu inceleniyor. Görsel: Zhao ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Guangyu Zhao ve ekibi, görsel-dil-eylem (VLA) modellerinde dikkat çekici bir eksiklik tespit etti: eylem çıktısına yakın katmanlardaki temsiller, görevle ilgili görsel dayanağı tam olarak korumuyor. Araştırmacılar, bu geç katman dayanak boşluğunu gidermek için STAR'ı (STeering Action Representations) önerdi. STAR, önceden eğitilmiş VLA modelleri için geliştirilmiş, eğitim gerektirmeyen bir çıkarım yöntemi.
Yöntem, geç katmanlardaki artık (residual) güncellemelerin üzerinde üstel hareketli ortalama uyguluyor. Böylece sonraki eylem temsilleri, model güncellemesi veya mimari değişikliği gerektirmeden önceki katmanlardan nesne farkındalıklı güncelleme yönlerini devralıyor. STAR ayrıca yakın zamanlı proprioseptif durumları kullanarak karıştırma gücünü ayarlıyor. Yürütme dinamikleri hızla değiştiğinde temkinli bir karıştırma tercih ediyor; bu sayede ani hareket değişimlerinde eylem temsillerinin bozulması önleniyor.
Robotik manipülasyon benchmark'larındaki deneyler, STAR'ın geç katman nesne farkındalığını iyileştirdiğini ve ortalama görev başarı oranını 4,0 yüzde puanı artırdığını gösteriyor. Yöntem yeniden eğitim gerektirmediğinden, mevcut VLA modellerine ek hesaplama ve veri maliyeti olmadan eklenebiliyor. Bu da yaklaşımı pratik açıdan cazip kılıyor. Çalışma, VLA modellerinde başarının yalnızca daha büyük modellerden ya da daha fazla veriden gelmeyeceğini, katmanlar arası bilgi akışının da kritik olduğunu ortaya koyuyor. Araştırmacılar kodu açık olarak paylaştı; böylece topluluk yöntemi farklı modeller ve görevler üzerinde doğrudan deneyebilecek.
Gömme araştırmaları kipler arasında ortak ilkelere yakınsıyor; derleme birleşik bir çerçeve öneriyor.
Gömme (embedding) modelleri, arama motorlarından öneri sistemlerine kadar neredeyse her modern yapay zeka sisteminin temelini oluşturuyor. Buna rağmen bu alandaki araştırma kipe göre parçalanmış durumda: metin, görüntü ve ses gibi alanların toplulukları büyük ölçüde birbirinden bağımsız ilerliyor ve birbirleriyle nadiren bulgu paylaşıyor.
Ziyin Zhang ve ekibi, bu parçalanmanın daha derin bir yakınsamayı gizlediğini savunuyor. Karşılaştırmalı öğrenme (contrastive learning), Transformer mimarileri ve granülerlik kayması sayesinde, kipe özgü zorluklar tam çözülmemiş olsa da, gömme araştırmaları ortak ilkelere doğru ilerliyor. Yazarlar bu yakınsamayı karıştırmadan analiz etmek için üç kademeli bir yetenek çerçevesi sunuyor: kapsam, karşılaştırılabilirlik ve bileşimsellik. Bunlara karşılık gelen üç birleştirme yolu da şöyle: dönüşüm kapsamı genişletiyor, hizalama karşılaştırılabilirliği sağlıyor, ortak gömme (joint embedding) ise bileşimselliği hedefliyor. Yazarların önerdiği varış noktası da bu.
Pozisyon makalesi niteliğindeki çalışma, omnimodal gömme araştırmasının birleşik ve kipler arası ilk bütüncül incelemesini sunuyor. Çok kipli sistemler geliştiren ekipler için ortak bir referans çerçevesi sağlaması bekleniyor. Bu çerçeve, farklı kiplerde geliştirilen yöntemlerin hangi noktada birbirinden öğrenebileceğini görünür kılarak araştırma enerjisinin tekrar eden çabalara harcanmasını azaltmayı hedefliyor.
Anchor 1: İnsansı Robotlarda Hassas Tüm Vücut Manipülasyonu
Anchor 1, mevcut denetleyicilere kıyasla izleme hatasını %30–80 azaltıyor.
Archon Robotics ekibi, insansı robotların tüm vücut manipülasyonunda hassas ve kararlı olmasını sağlayan Anchor 1 denetleyicisini ve bu alanı ölçen bir benchmark'ı tanıttı. Manipülasyon görevleri yürütme sapmalarına çok duyarlı: küçük bir hata ya da istenmeyen bir adım bile başarısızlığa yol açabiliyor.
Anchor 1, çevrimiçi eklem uzayı yeniden hedeflemesi (retargeting) yapmadan, görevle ilgili insan hareket yapısını koruyan kalibre edilmiş seyrek hareket referansları kullanıyor. Bu da hassas kontrol için kinematik serbestlik bırakıyor. Serbestliği kararlı ve fiziksel olarak makul koordinasyona yönlendirmek için, eğitim dağılımı bu referanslarla eşleştirilmiş robot hareketlerinin çevrimdışı seçimiyle şekilleniyor. Hareket kodlamasından ayrıştırılmış açık hata geri bildirimi de kontrol hassasiyetini artırırken esnek komut arayüzlerini destekliyor.
Simülasyon ve donanım testleri, tüm değerlendirme kategorilerinde daha yüksek hassasiyet ve kararlılık gösteriyor. En katı gerçek dünya puanlama ayarında Anchor 1, daha az ileri bakış girdisiyle ve yeniden hedefleme olmadan, mevcut tüm denetleyicilere göre izleme hatasını %30 ile %80 arasında azaltıyor. Aynı dağıtım hattıyla teleoperasyonla veri toplama da daha verimli hale geliyor ve görev başarısı artıyor.
MEMENTO: Uzun Bağlamlı Ajanlar İçin Bağlam Yönetimi
8B parametreli MEMENTO, 20K token'ı aşmadan kitap düzeyinde soru yanıtlamada doğruluğu %67,8'e çıkardı.
Uzun girdilerle çalışan LLM ajanları, sabit boyutlu bağlam penceresinde nelerin tutulacağına karar vermek zorunda. Yaygın yaklaşım olan sıkıştırmada (compaction) model, geçmişini kendi ürettiği bir notla değiştiriyor. Ancak GPT-5.5 ve GLM-5.3 dahil hazır ajan modelleri çoğu zaman etkisiz notlar yazıyor; tek başına pekiştirmeli öğrenme de işe yarar not alma davranışını nadiren keşfediyor.
Yunfan Zhang ve ekibi, Qwen3-8B üzerine kurulu MEMENTO'yu geliştirdi. Model önce, geriye dönük olarak üretilmiş notlarla işaretlenmiş sentetik yörüngeler üzerinde ince ayarla not almayı öğreniyor; ardından cevap doğruluğu, not kalitesi sezgileri ve güven kalibrasyonunu birleştiren bir ödülle pekiştirmeli öğrenmeye alınıyor. Yalnızca yeni pencereye sıkıştırma için eğitilmesine rağmen, test anında bağlam katlama ve güvene dayalı geri izleme gibi stratejilere de genişleyebiliyor.
2,5 milyon token'a kadar kitaplar içeren dört benchmark'taki kitap düzeyinde soru yanıtlamada MEMENTO, Qwen3-8B'nin doğruluğunu %36,9'dan %67,8'e çıkarıyor ve bağlamda hiçbir zaman 20K token'dan fazlasını tutmuyor. Aynı çerçevedeki GPT-5.5 ajanını (%13,1) ve tam kitap bağlamını (%56,7) 50 kattan az maliyetle geçiyor. Yaklaşık 100 kat büyük GLM-5.3 ajanına (%69,3) ise dokuzda bir maliyetle neredeyse yetişiyor.
Scale-Free Attention, 262 bin token'da FlashAttention'a göre 357 kata kadar hızlanma sağlıyor.
Difüzyon transformer'ları görüntü üretiminde büyük başarı yakaladı, ancak yüksek çözünürlüklerde kaliteyi koruyarak dikkat mekanizmasını hızlandırmak hâlâ zor. Doğadaki ölçekten bağımsız (scale-free) yasalardan esinlenen araştırmacılar, yerel ince etkileşimleri korurken uzak bölgeleri giderek daha kaba ölçeklerde özetleyen Scale-Free Attention'ı (SFA) geliştirdi.
N token için ortalama havuzlama, token sayısı düzeltmesi ve ölçekten bağımsız bir uzamsal hiyerarşi üzerinde ortak softmax kullanan SFA, hem ileri hem geri geçişte O(N log N) karmaşıklığa sahip. Triton uygulaması, 262.144 token'da FlashAttention'a göre ileri geçişte 357,3 kat, geri geçişte 265,6 kat hızlanma sağlıyor. ImageNet 256×256 üzerinde sıfırdan 40 epoch PixelFlow eğitiminin ardından SFA, tam dikkat dahil beş dikkat mekanizması arasında en iyi üretim kalitesine ulaşıyor: FID-50k, tam dikkatteki 13,25'ten 12,51'e iniyor ve bu avantaj 80 epoch'ta da sürüyor. FFHQ'da da karşılaştırılan verimli dikkat yöntemleri arasında en iyi sonucu veriyor.
Stable Diffusion 3.5 Medium'daki dikkat SFA ile değiştirildiğinde, eşleşen ince ayar bütçelerinde tam dikkatli sürümün kalitesi korunuyor. Çalışma, ölçekten bağımsız yapıyı verimli ve yüksek kaliteli difüzyon transformer'ları için etkili bir tasarım ilkesi olarak öne koyuyor.
Sağlayıcılar modelleri sessizce güncelliyor; bu hem denetimi hem bilimsel tekrarlanabilirliği zayıflatıyor.
Nature Machine Intelligence'ta yayımlanan görüş yazısı, yapay zekâ sağlayıcılarının modellerini ve sistem entegrasyonlarını, kamuya açık tanımlayıcıları değiştirmeden sık sık güncellediğine dikkat çekiyor. Aynı model adı altında davranış değişebildiği için, bir modelle yapılan bir deneyin ya da denetimin hangi sürüme ait olduğu belirsizleşiyor.
Yazarlar bunun hem düzenleyici gözetimi hem de bilimsel tekrarlanabilirliği zedelediğini savunuyor. Sorunu somutlaştırmak için makale, GPT-4o'nun ChatGPT'deki dalkavukluk (sycophancy) olayını örnek alıyor. Bu olayı, taahhüt temelli olası bir sürümleme şeması altında yeniden kurguluyor. Böyle bir şemada her sürüm, davranışını doğrulanabilir biçimde tanımlayan bir kayda bağlanıyor ve sağlayıcı sessizce değişiklik yapamıyor.
Yazarlar ayrıca AB Yapay Zekâ Yasası, Kaliforniya'nın SB 53 düzenlemesi ve Çin'in üretken yapay zekâ yönetmeliği gibi mevcut düzenlemeleri inceliyor. Bu çerçeveler ışığında, hem düzenleyicilerin hem de araştırmacıların ihtiyaçlarına yanıt veren anlamlı bir sürümleme çağrısı yapıyorlar.
Model dağıtımının sürekli bir güncelleme akışına dönüştüğü bir dönemde, hangi sürümün neyi yaptığını ayırt edebilmek denetim, hesap verebilirlik ve yeniden üretilebilir araştırma için temel bir altyapı gereksinimi haline geliyor.
CARe, CLIP'in test anı uyarlamasında kosinüs benzerliğinin yerine Mahalanobis geometrisi kullanıyor.
Test anı uyarlaması (TTA), CLIP gibi görsel-dil modellerinin etiket veya kaynak veriye erişim olmadan dağılım kaymalarına uyum sağlamasını mümkün kılıyor. Mevcut yöntemler öznitelik önbellekleme, prototip kestirimi veya öznitelik istatistiklerini çevrimiçi biriktirme yoluyla uyarlanıyor, ancak çoğu sonunda test özniteliğini sınıf temsilcisiyle gömme uzayında, tipik olarak kosinüs benzerliğiyle puanlıyor. Lakpa Tamang ve ekibine göre bu ortak karar kuralı anizotropik dağılımlarda bir sınırlama: varyansın büyük kısmı az sayıda yönde toplandığında, puan ayırt edici olmayan yüksek varyanslı yönlerin etkisinde kalabiliyor.
Önerilen CARe, çevresel geometriyi hedef öznitelik ikinci momentinin tanımladığı Mahalanobis geometrisiyle değiştiriyor. Paylaşılan kovaryanslı Gauss modeli altında kovaryans farkındalıklı karar yönünün Bayes-optimal doğrusal ayırıcıyla örtüştüğü, kosinüs puanlamanın ise izotropik özel durum olduğu gösterildi. Potansiyel kazancın öznitelik anizotropisiyle arttığı da kanıtlandı.
Deneylerde CARe, iki backbone üzerinde standart ve ince taneli dağılım kayması benchmark'larında temel kosinüs puanlamasına göre uyarlama doğruluğunu artırıyor. Kazançlar öznitelikleri en anizotropik olan veri kümelerinde en yüksek, öznitelikler izotropiye yaklaştıkça sıfırlanıyor. Bu, analizin öngörüsüyle tutarlı.
LLM'ler Sinir Ağı Ağırlıklarını Okuyup Yazabiliyor
"Weight Space Programming", bir LLM'in daha küçük bir modelin ağırlıklarını doğrudan düzenlemesini gösteriyor.
AINews'ün bu sayısının öne çıkan konusu, yeni bir makale: yeterince güçlü bir model, daha zayıf bir modelin ağırlıklarını doğrudan okuyup düzenleyebiliyor. Sekiz ay önce Karpathy'nin autoresearch'ü, güçlü bir modelin deneyler yürüterek başka bir modeli otonom eğitebileceğini göstermişti. Ancak o süreç PyTorch/Jax kodu yazmayı, hesaplama çalıştırmayı, kayıp eğrileri ve değerlendirmeleri okumayı gerektiriyordu. Yeni çalışmada ise, geçen ay konuk olan Alex Zhang'ın da ortak yazar olduğu ekip, kaynak koda bakmadan doğrudan ağırlıkları görmeyi ve değiştirmeyi deniyor.
Bülten bunu, derlenmiş küçük yürütülebilir dosyaların 1'lerine ve 0'larına bakıp ne yaptıklarını anlamaya benzetiyor. Modellerin ağırlıkları 1) ne yaptıkları açısından yorumlanabiliyor, 2) başarısız izlerden yola çıkarak tek seferde düzeltilebiliyor veya yaklaşık 50 adımda genel bir yönde iyileştirilebiliyor, 3) hatta sıfırdan yazılabiliyor. Başlıkta yer alan örneklerden biri, Qwen'in ağırlıklarını düzenleyerek akıl yürütme döngülerini azaltmak. Bağımsız bir yeniden üretim denemesi de benzer bulgulara ulaşmış.
Yetenek şimdilik basit oyunlar ve RL politikalarıyla sınırlı; daha karmaşık görevlere ölçeklenmesi belirsiz. Yine de bülten, bunun özyinelemeli kendini iyileştirme (RSI) yönünde sıfırdan bire geçiş sayıldığını, verimliliği nedeniyle hızla denenip keşfedileceğini belirtiyor.