2026-11-04Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayıda yapay zekanın soyut başarıları değil, fiziksel ve görsel dünyayla kurduğu somut ilişki öne çıkıyor. Robotların daha ucuz ve açık verilerle öğrenmesi, modellerin uzamsal akıl yürütmeyi derinleştirmesi, oyun ortamlarında ve çok lehçeli konuşmada ajanların sınanması ve modellerin kimliğinin doğrulanması aynı soruya dokunuyor: Bu sistemlere ne kadar güvenebiliriz ve onları nasıl ölçeriz? Birlikte okunduklarında, sahadaki ilerlemenin hızı kadar değerlendirme disiplininin de belirleyici olduğu görülüyor.
1.Araştırma
AIRoA-0: Robot verisi olmadan el gösterimlerinden öğrenen çift kollu sistem
16 bin saatlik elle kaydedilmiş gösterimden öğrenen AIRoA-0, hiç robot verisi görmeden görevlerde %78 başarı sağladı.
AIRoA-0 (A-0), 16.151 saatlik elde taşınan gösterimden öğrenen çift kollu bir manipülasyon sistemi; eğitimin hiçbir aşamasında robot verisi toplanmadı. Gösterimler, robot olmadan her yerde veri kaydetmeye izin veren açık kaynaklı YUBI tutucusuyla alındı. Tek bir talimattan yola çıkan sistem, bir düzineden fazla küçük parçayı numaralı gözlere ayırıyor, robot süpürgenin paspas pedlerini ve fırçasını değiştiriyor, kalem kutusunun fermuarını açıyor ve havlu katlıyor. Bunu yalnızca her bileğe takılı birer kamerayla, eğitim verisinin hiç toplanmadığı bir ortamda yapıyor. Sistem, görevle ilgili bakış bölgelerini ve görevin hangi aşamada olduğunu kendisi öğreniyor; eylemleri sürekli bir akış olarak çözüyor. On görevlik değerlendirmede ortalama %78 başarı elde etti; aynı görev gösterimleriyle son eğitimi yapılan dört görü-dil-eylem modelinin en iyisi %27'de kaldı. Teleoperasyon verisi, pekiştirmeli öğrenme veya robot üzerinde düzeltme kullanılmadı; robot yalnızca test aşamasında devreye giriyor. A-0, YUBI tutucusu takılabilen Franka, TX-G2, OpenArm ve UR gibi farklı robotlarda çalışıyor. Ekip, bildikleri en büyük açık el tutucu gösterim veri setini, önceden eğitilmiş ağırlıkları ve son eğitim tarifini yayımlıyor; kendi görevini kaydeden biri modeli tek bir sekiz H200 GPU'lu düğümde dört saatin altında uyarlayabiliyor. Bu, robot öğrenmesinde veri toplamanın robot donanımından bağımsız ve herkesin erişebileceği ölçekte yapılabileceğini gösteriyor.
FlowBench: Karşıolgusal hayal gücüyle uzamsal zekâ eğitimi
FlowBench, varsayımsal hareketlerin sahneyi nasıl değiştireceğini hayal etme yeteneğini ölçen 428 bin örneklik bir kaynak.
İnsanlar, varsayımsal hareketler altında bir sahnenin nasıl değişeceğini hayal edebilir; bu yetenek uzamsal akıl yürütme ve robot planlaması için merkezi önem taşıyor. Buna karşın görü-dil modellerinde ve dünya modellerinde bu alan yeterince incelenmemiş durumda. Araştırmacılar bu yeteneği Karşıolgusal Uzamsal Hayal Gücü (CSI) olarak tanımlıyor ve her ikisini de eğitip değerlendirmek için FlowBench'i sunuyor. Kaynak; simüle ve gerçek sahneleri, ev ortamlarını, masa üstü manipülasyonu ve çeşitli soru türlerini kapsayan 428 bin eğitim örneği içeriyor. Tam otomatik ve ölçeklenebilir bir hat, her varsayımsal hareketi uzamsal sorularla eşleştiriyor; simülasyonda ayrıca kesin sonuç kareleri ve optik akış da üretiyor. Kapalı kaynaklı modeller, hareketin sonucu gözlemlenmek yerine çıkarsanması gerektiğinde daha kötü performans gösteriyor (bir hayal gücü açığı); açık kaynaklı modeller ise rastgeleye yakın kalıyor. Qwen3-VL-8B'yi FlowBench-Sim-Train ile ince ayarlamak simülasyonda doğruluğu 29,5 puan, gerçek görüntülerde 16,9 puan artırıyor; bu, güçlü bir simülasyondan gerçeğe aktarım anlamına geliyor. Dünya modelleri tarafında, test edilen dört model ailesinin tümünde metinden akışa tahmin iyileşiyor; Psi-0.6'nın doğruluğu %52,1'den %61,7'ye çıkıyor. Kod ve veri setleri yayımlandı. FlowBench, uzamsal zekâ ve robot planlaması için hem eğitim hem de değerlendirme aracı olarak öne çıkıyor.
MABEL: Açık kaynaklı mobil çift kollu insansı robot platformu
56 serbestlik dereceli MABEL, 8,1 bin dolarlık parça maliyetiyle robot öğrenmesi için açık kaynaklı bir platform sunuyor.
Robot öğrenmesi masa üstünün ötesine geçtikçe birçok görev hareketlilik, ayarlanabilir erişim, aktif algı ve iki elle beceri gerektiriyor. Bu yetenekleri birleştiren ticari platformlar pahalı; uygun fiyatlı açık kaynak alternatifler ise yalnızca bir kısmını kapsıyor ve yazılım entegrasyonu gerektiriyor. MABEL, 56 serbestlik dereceli (DOF) ve 8,1 bin dolar parça maliyetli, açık kaynaklı, insansı mobil çift kollu bir robot. İki adet 7-DOF kolu 17-DOF'lu ellerle, eğilebilen bir gövdeyle, bir kaldırma mekanizmasıyla, 3-DOF'lu bir boyunla ve holonomik bir tabanla birleştiriyor. Geri sürülebilir kollar ve gövde uyumlu etkileşimi destekliyor; parmak ucu erişimi zeminden 2,23 metreye kadar uzanıyor. Baş ve gövde, gövdeye sabit bir kameraya göre modellenmiş kamera kapsamını yaklaşık üç katına çıkarıyor. Apple Vision Pro ile baş ve el takibi, el kumandası olmadan tüm vücutlu teleoperasyona imkân tanıyor; robotun Wi-Fi erişim noktası üzerinden ortalama 137 ms'lik uçtan uca stereo video gecikmesi ölçüldü. Ekip, ortak bir komut arayüzü ve tüm vücut kontrolcüsüyle teleoperasyonla veri toplamadan politika dağıtımına uzanan uçtan uca bir taklit öğrenmesi hattı da gösteriyor. MABEL, erişilebilir donanımı yaygınlaştırarak robot öğrenmesi araştırmalarında giriş eşiğini düşürüyor.
CoReMatch: Gerçek zamanlı özellik eşleştirmede sürekli koordinat iyileştirme
CoReMatch, eşleşmeleri sürekli koordinat uzayında iyileştirerek gömülü donanımda 10 kattan fazla hızlanma sağlıyor.
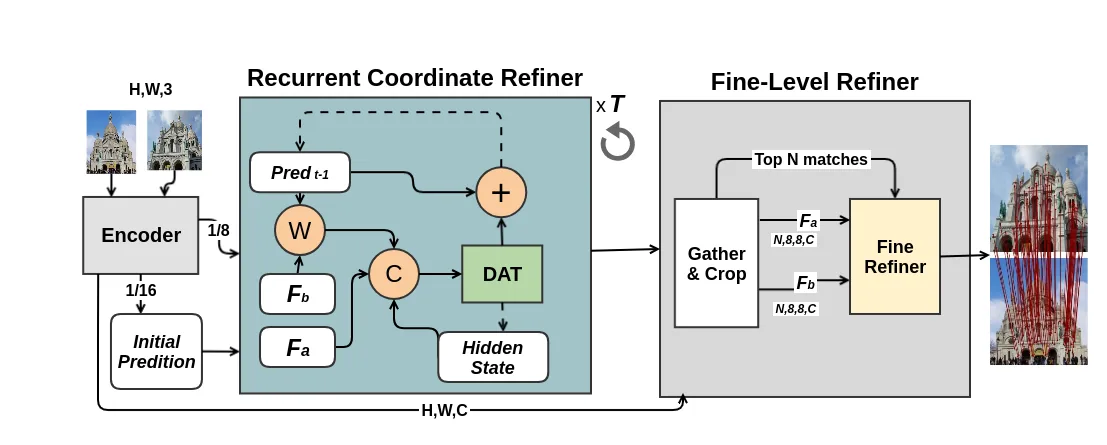
CoReMatch, düşük çözünürlüklü 1/16 özellik haritalarından ilk eşleşmeleri çıkarıp yinelemeli bir modülle koordinatları adım adım iyileştiriyor. Görsel: Wang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Özellik eşleştirme; görsel konumlandırma, haritalama, SLAM ve otonom navigasyon gibi pek çok robotik algı görevinin temelini oluşturuyor. CoReMatch, bu alandaki yeni bir yaklaşım: eşleşmeleri ayrık güven haritaları üzerinden değil, doğrudan sürekli koordinat uzayında iyileştiren özyinelemeli bir çerçeve. Mevcut yarı yoğun eşleştiriciler güveni sabit ızgaralar üzerinde tahmin ediyor. Bu tasarım, eşleşmeleri önceden tanımlı konumlarla sınırlıyor ve kesin konumlandırma için maliyetli yüksek çözünürlüklü ızgaralar gerektiriyor. CoReMatch ise tekrarlar boyunca bilgiyi aktararak eşleşme tahminlerini adım adım geliştiriyor. Kaba aşamada bir Derin Birleştirilmiş Transformer küresel bağlamı yakalıyor ve eşleşme koordinatlarını yinelemeli olarak güncelliyor. Ardından hafif bir regresyon başlığı konumlandırmayı keskinleştiriyor. Böylece ızgara çözünürlüğüne bağlı kalmadan hassas eşleşmeler elde edilebiliyor. İç ve dış mekân kıyaslamalarında CoReMatch, doğruluk ile verimlilik arasında güçlü bir denge kuruyor: doğrulukta Efficient LoFTR'yi geçerken gömülü uç donanımda 10 kattan fazla hızlı çalışıyor. Bu sonuçlar, özyinelemeli koordinat iyileştirmenin robotik algıda gerçek zamanlı özellik eşleştirme için verimli ve ölçeklenebilir bir yol sunduğunu gösteriyor. Sınırlı hesaplama gücüne sahip robotlar ve uç cihazlar için bu verimlilik kazancı özellikle değerli. Çalışma CoRL 2026'da kabul edildi.
Nokta bulutu sınıflandırmada 10 mimariyi istatistiksel olarak kıyaslayan çalışma, dönme değişmezliğinin maliyetini sorguluyor.
Nokta bulutu mimarilerinde dönme değişmezliğini doğrudan yapıya gömmeye çalışan geniş bir araştırma kolu var. Bu çalışma, 10 mimariyi (PointNet, PointNet++, DGCNN, RIConv, RIConv++, RISurConv, PointMLP, PointTransformer ile eşdeğişen VN-PointNet ve VN-DGCNN) 5 alanda poz, gürültü ve kapanma koşulları altında kıyaslıyor ve sonuçları nokta tahminleri yerine doğrulayıcı hipotez testleriyle analiz ediyor. Üç dönme değişmez (RI) mimari en iyi poz dayanıklılığını sağlıyor ancak 5 alanın 4'ünde gürültü dayanıklılığında en düşük sıralarda yer alıyor. Araştırmacılar bu maliyetin değişmezliğin doğasında mı yoksa elde ediliş biçiminde mi olduğunu soruyor. Bunun için 10 mimariyi, gömme üzerinde basit bir değişmezlik kaybıyla ve her biri için üç tohumla yeniden eğitiyor; tüm modelleri bağımsız tasarlanmış ModelNet40-C üzerinde değerlendiriyor. Değişmezlik eğitimi dar ama güvenilir biçimde aktarılıyor: tabanda iyileşme payı olan yerlerde hedeflediği bozulma ailelerini düzeltiyor (ortalama kapanmada +10,5, lidarda +13,4 doğruluk puanı). Eşit eğitim bütçesinde en iyi standart omurga ile en iyi RI mimari görülmemiş bozulmalarda başa baş bitiriyor (her tohumda 2,5 puan içinde); değişmezlik eğitimli RIConv++ ise tohumlar arasında en kararlı üst model. Dönme artırımı genişletildiğinde standart omurgalar, tam küre dönüşünde yalnızca sabit ve açıdan bağımsız bir doğruluk farkı veriyor. Ekip, kıyaslamayı ve nokta bulutu dayanıklılığını analiz edip sonuçları yeniden üretmeye yarayan bir paketi yayımlıyor.
LOLPlay: League of Legends'ta gerçek zamanlı görsel ajan kıyaslaması
LOLPlay, ajanların oyun evrilirken akıl yürütüp hareket edebilmesini 36 görevle ölçüyor; daha fazla akıl yürütme işe yaramıyor.
Görsel ajanlar, ortam çıkarım sırasında değişirken akıl yürütme ve eylemi koordine etmek zorunda. LOLPlay, doğal League of Legends ortamında kaynak yönetimi, çatışma, iş birliği ve hedefleri kapsayan 36 şampiyona özgü görevden oluşan bir kıyaslama. Ajanlar ortamla ekran görüntüleri ve fare-klavye eylemleri üzerinden etkileşiyor; otomatik başlatma ve 82 çalıştırılabilir alt hedef kontrolü, kısmi ilerlemeyi tamamlanmış görevden ayırt ediyor. Üç modelin üç akıl yürütme çabası ayarında yapılan 324 görev değerlendirmesinde GPT-6 Astra, düşük ve orta çabada %25,0 ile en yüksek görev başarı oranına, orta çabada ise %40,3 ile en yüksek alt hedef başarı oranına ulaştı. Ancak yüksek çaba, hiçbir model için düşük çabaya kıyasla ne görev ne de alt hedef başarısını iyileştirdi. Astra için daha uzun istekler daha az etkileşim turu bırakıyor; bu da gerçek zamanlı kontrolde ek akıl yürütmenin bir maliyeti olduğunu düşündürüyor. İzlenen yörüngeler alt hedeflerin eksik birleştirildiğini ve eylemlerin gözlenen sahne değiştikten sonra çalıştığını ortaya koyuyor. Bu bulgular, görsel akıl yürütmeyi zamanında eylemle birleştiren ajanlara duyulan ihtiyacı vurguluyor.
GigaSpeech 3: Zayıf etiketli veriyle çok lehçeli Arapça konuşma tanıma
39 bin saatlik GigaSpeech 3, beş Arapça lehçesinde konuşma tanımayı zayıf etiketli veriyle ölçekliyor.
Lehçeli Arapça konuşma tanıma, web'de bol miktarda ses olmasına rağmen lehçeye göre ayrılmış transkribe edilmiş konuşma kıtlığıyla sınırlı kalıyor. GigaSpeech 3; Cezayir, Mısır, Irak, Suudi ve Suriye Arapçasını kapsayan, 39 bin saat ve 10 milyon zayıf transkribe konuşma segmentinden oluşan bir külliyat. Ekip, lehçe başına 60 saatlik elle transkripsiyondan yola çıkarak konuşma tanıma yanlılıklı öz denetimli öğrenmeyle etiketleme modelleri eğitiyor ve bunları lehçeyle eşleşen web sesine uyguluyor. Veri seçimi ile Suudi ve Suriye Arapçası için dört tur gürültülü öğrenci iyileştirmesi nihai külliyatı oluşturuyor. GigaSpeechBench üzerinde nihai lehçeye özgü modeller beş lehçenin tamamında etiketleme modellerini geride bırakıyor ve %23,86'lık makro ortalama kelime hata oranına ulaşıyor; bu, beş lehçeyi de kapsayan en güçlü üçüncü taraf sisteme göre %16,6'lık göreli azalma anlamına geliyor ve üç lehçede en iyi üçüncü taraf sonucunu da geçiyor. Kendi tahmin ettiği lehçe kimliklerini kullanan çok lehçeli bir model, Modern Standart Arapçayı da destekleyerek %25,51 makro ortalama kelime hata oranına ulaşıyor. Üç dış külliyattan sekiz koşulda GigaSpeech 3 ile eğitilen bir Zipformer, değerlendirilen altı model arasında her koşulda en düşük hata oranını veriyor; Qwen3 konuşma tanıyıcısını GigaSpeech 3 üzerinde uyarlamak da sekiz koşulun hepsinde performansı artırıyor. Külliyat ve tarifler, lehçe duyarlı Arapça konuşma işleme için temel olarak yayımlanıyor.
Anthropic, yapay zekâ modellerinin kimliğini kanıtlayacak sistem geliştiriyor
FlashProve, bir yanıtın iddia edilen modelden geldiğini kriptografik olarak doğrulamayı hedefliyor.
Anthropic, belirli bir çıktıyı hangi yapay zekâ modelinin ürettiğini doğrulayan açık kaynaklı bir sistem üzerinde çalışıyor. FlashProve adlı sistem, araştırmacıların “kanıtlanabilir çıkarım” dediği şeyi, yani bir çıktının belirli bir modelden geldiğinin kriptografik kanıtını sağlıyor. Amaç, kullanıcının aldığı yanıtın gerçekten kullandığını sandığı modelden geldiğini teyit edebilmesi. Sistem, e-postalardaki kriptografik imzalar gibi, bir modeli başka bir modelmiş gibi gösterme girişimlerine karşı, taklitçi modeli geliştiren ve çalıştıran laboratuvar olsa bile dayanıklı olacak şekilde tasarlandı. Araştırmacılar, bunun örneğin bir yapay zekâ şirketinin maliyeti düşürmek için gizlice daha ucuz bir modele geçmesini veya performans sonuçlarını şişirmek için daha pahalı bir model kullanmasını engelleyebileceğini belirtiyor. Sistem ayrıca bir görevin gelişmiş bir modelle yapıldığına dair üçüncü taraf iddialarının doğrulanmasında da kullanılabilir. Çalışması için laboratuvarların yayımladığı her model için, sonradan belirli çıktılarla eşleştirilip kriptografik olarak doğrulanabilen bir “parmak izi” yayımlaması gerekiyor. Bu parmak izleri, Anthropic ve OpenAI gibi kapalı model üreticilerinin gizli tuttuğu model ağırlıklarını açığa çıkarmıyor; dolayısıyla sistem ticari modellerle de çalışabilir. Sistem hafif tasarlandığından doğrulama yerel bir cihazda yapılabilir. Araştırmacılar ayrıntılı bir teknik şartname ve sistemin çeşitli unsurları için çalışan kodu GitHub'da açık kaynak lisansla paylaştı. Araştırma sürüyor; Anthropic'te veya başka bir laboratuvarda devreye alma planı bulunmuyor.