2026-11-12Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayının ortak paydası, yapay zekanın hem daha küçük hem daha yetenekli hale gelmesi: üretken modeller tek adıma iniyor, ajanlar ve akıl yürütme modelleri doğrudan cihaz üzerinde çalışıyor, robotlar ise görevine göre biçim değiştirebiliyor. Bu çalışmaları yan yana okumak, verimlilik ile görü ve robotiğin artık aynı hikâyenin parçaları olduğunu, laboratuvar kazanımlarının sahaya hangi hızla taşındığını gösteriyor.
1.Araştırma
Tek Adımlı Üretim İçin Yörünge Düzenlemeli Damıtma
Akış eşleştirme modelleri, yörünge ve dağılım denetimi birleştirilerek tek adımda görüntü üretecek şekilde damıtılıyor.
Araştırmacılar, akış eşleştirme (flow matching) modellerini tek adımlı üretime damıtmak için yörünge düzenlemeli dağılım damıtma (TRD) yöntemini önerdi. Mevcut yaklaşımlar iki grupta toplanıyor: yörünge hizalama, öğrenciyi öğretmenin olasılık akış ODE'siyle denetliyor ancak çok düşük örnekleme bütçelerinde performansı düşüyor; dağılım eşleştirme ise üretilen dağılımı doğrudan optimize ediyor fakat ters KL gradyanını tahmin etmek için öğrencinin skor fonksiyonunu takip eden ayrı bir ağ gerektiriyor.
TRD, dağılım düzeyindeki ve yörünge düzeyindeki denetimi tek bir öğrenci ileri geçişinde tahmin edilen bir momentum-karışım politikası üzerinden birleştiriyor. Bu politika aynı anda tek adımlı üretici, öğrencinin marjinal hız alanının tahminleyicisi ve öğretmen ODE yörüngesi boyunca denetlenen kapalı formlu, zamana bağlı bir hız alanı olarak çalışıyor. Böylece dağılım eşleştirmede ikinci bir eğitilebilir ağa duyulan ihtiyaç ortadan kalkıyor.
SANA-1.6B ve Stable Diffusion 3.5 üzerindeki deneylerde TRD, hem tek hem az adımlı üretimde tutarlılık ve dağılım eşleştirme tabanlı temel yöntemleri üretim kalitesi ve eğitim verimliliğinde geride bırakıyor. Karşılığında örnek çeşitliliğinde bir ödünleşim söz konusu. Sonuçlar, tek adımlı görüntü üretiminde kaliteyi ve eğitim maliyetini birlikte iyileştirmenin mümkün olduğunu gösteriyor.
G-STAR: 64 Kat Sıkıştırmayla Hızlı Otoregresif Görsel Üretim
Grup ölçekli belirteç kapasitesi, otoregresif modellerde 32×–64× sıkıştırmayı mümkün kılıyor ve üretimi 20 kat hızlandırıyor.
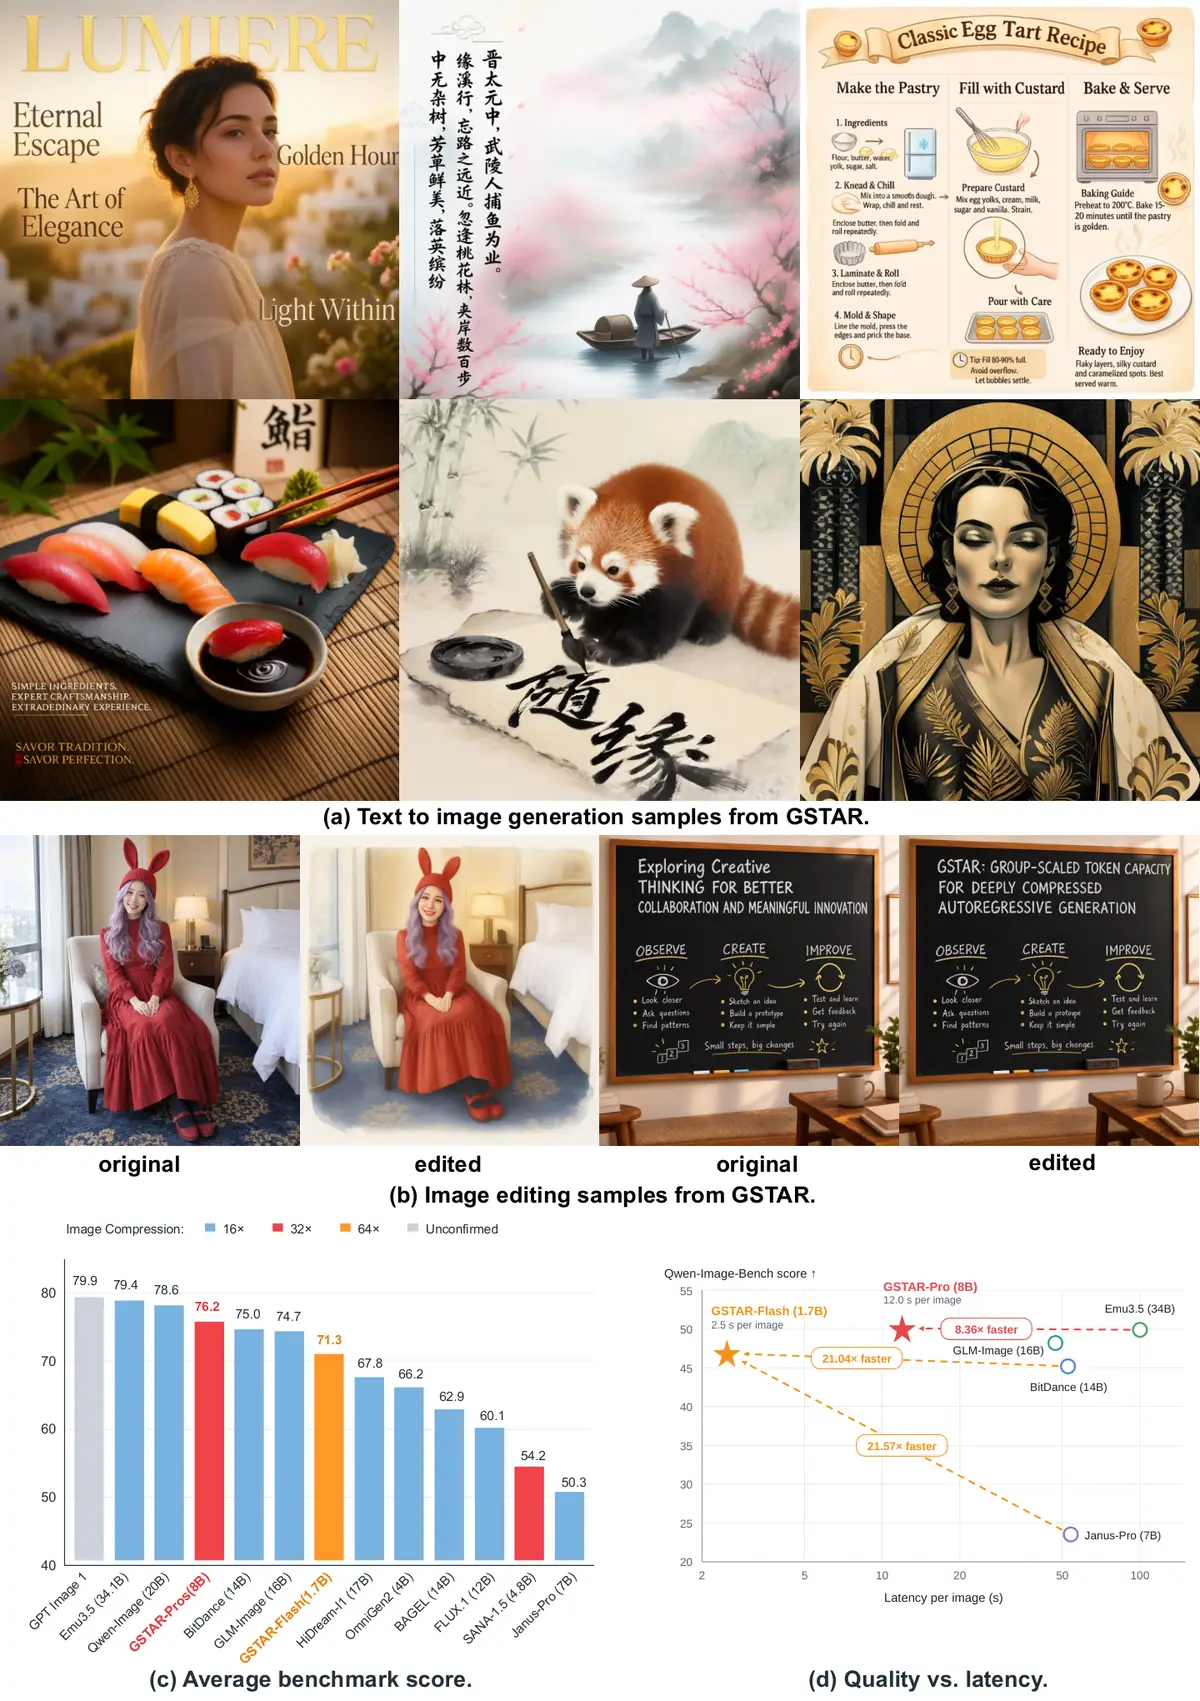
G-STAR'ın genel görünümü: model hem metinden görsel üretiyor hem de görselleri metin talimatıyla düzenlerken ilgisiz içeriği koruyor; 32×–64× sıkıştırma sayesinde bu işi çok daha hızlı yapıyor. Görsel: Huang ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
Ayrık otoregresif modeller görüntü üretimi için ölçeklenebilir bir çerçeve sunuyor, ancak temel bir ödünleşimle karşı karşıya: uzun belirteç dizileri temsil kalitesini korurken üretimi yavaşlatıyor, agresif uzamsal sıkıştırma ise temsil kapasitesini düşürüyor. Ürün nicemlemesine (product quantization) dayanan çalışma, sabit bir nominal bilgi bütçesi altında grup boyutunun eksen başına uzamsal sıkıştırma faktörüyle kuadratik ölçeklenmesi gerektiğini gösteriyor.
Bu ilkeye dayanan G-STAR, uzamsal ve grup ölçeklemeyi birlikte yapan bir çerçeve olarak 32× ve etkin 64× sıkıştırmayı sağlarken yeniden oluşturma, anlama ve üretim performansını koruyor. Daha büyük gruplar grup içi bağımlılıklar getirdiği için ekip, paralel özellik hesaplamasını hafif nedensel modellemeyle birleştiren yarı-otoregresif bir kod çözücü geliştirdi.
Yüksek oranda sıkıştırılmış modeller, GenEval, DPG-Bench, PRISM, LongText-Bench ve Qwen-Image-Bench olmak üzere beş metinden görüntüye kıyaslamada önde gelen modellerle rekabetçi sonuçlar veriyor. 1024×1024 çözünürlükte, önceki ayrık otoregresif modellere göre 20 kat hızlanma sağlayarak tek bir NVIDIA H200 üzerinde görüntü başına 2,5 saniyeye iniyor. Sonuçlar, yüksek oranda sıkıştırılmış ayrık temsillerin düşük gecikmeyle yüksek kaliteli otoregresif üretimi mümkün kılabileceğini gösteriyor.
BotPsy: Cihaz Üzerinde Çalışan 0,8B Parametreli Asistan
Tether AI'ın 0,8B parametreli BotPsy modeli, cihaz üzerinde araç kullanımı ve ajan iş akışlarında kendi boyutunda öne çıkıyor.
Tether AI Research, işlev çağırma ve ajan iş akışları için tasarlanmış, Qwen3.5-0.8B üzerine inşa edilen 0,8B parametreli BotPsy modelini tanıttı. Model, kullanıcı için araç kullanarak web araması, seyahat, ticaret ve finans, müşteri operasyonları, cihaz ve araç kontrolü, dosya ve belge işleri, takvim ile e-posta ve mesajlaşma gibi alanlarda basit görevleri yürüten bir "kişisel asistan" olarak konumlanıyor.
Test edilen 1,2B parametreye kadar tüm modelleri araç kullanımı ve ajan performansında geride bırakan BotPsy, altı araç kullanımı ve ajan kıyaslamasının beşinde öne çıkıyor; yalnızca Claw-Eval'de 2,5 kat büyük Qwen3.5-2B-Think biraz önde. Araç kullanımı eğitimi, benzer boyuttaki modellere kıyasla genel bilgiyi de korudu ve geliştirdi, ancak bilgi düzeyi hâlâ ağırlıklı olarak parametre sayısıyla ölçekleniyor. Açık talimatları ve çok turlu görevleri iyi izleyen model, talimat sayısı arttıkça performans kaybediyor ve düşük kaynaklı dillerde geride kalıyor.
Ekip, verilerin cihazdan çıkmadığı bir yapı sunduğunu ve bulut LLM'lerinin maliyet dalgalanması ile erişim riskinden kaçınmayı hedeflediğini belirtiyor. Küçük bir model olarak BotPsy hata yapabiliyor ve yüksek riskli kullanım için tasarlanmadı. Model; safetensors ile bf16, Q8 ve Q4 GGUF biçimlerinde Hugging Face üzerinden erişilebilir.
Otonom Araçlarda Akıl Yürütme Modelleri Cihaz Üzerinde Çalışıyor
NVIDIA Alpamayo 2 Edge, 2B parametreli uyarlanabilir akıl yürütmeyi DRIVE AGX Thor üzerinde gerçek zamanlı çalıştırıyor.
NVIDIA, otonom araçlarda akıl yürütme modellerini yerleşik sistemin hesaplama ve gecikme sınırları içinde çalıştırmak için Alpamayo 2 Edge'i tanıttı. Cosmos 3 Edge'in 2B parametreli Nemotron tabanlı omurgası üzerine kurulan model, bir difüzyon eylem uzmanıyla eşleşiyor. Çevre kameralarından, zamansal bağlamdan ve navigasyon girdilerinden Chain-of-Causation (CoC) akıl yürütmesi ile gelecekteki sürüş yörüngelerini üretiyor. Akıl yürütmeyi yalnızca gerektiğinde yaparak rutin sürüşte gereksiz belirteç üretimini azaltıyor.
Model, AlpaGym içinde kapalı döngü pekiştirmeli öğrenmeyle (RL) son eğitimden geçiriliyor; bu aşama, kapalı döngü RL olmayan en iyi kontrol noktasına göre kapalı döngü sürüş performansını %48,9 artırıyor. Akıl yürütme kalitesi ise insanla kalibre edilmiş AlpaJudge ile değerlendiriliyor; referans tabanlı ve referanssız varyantlarıyla farklı kanıt türlerine uyum sağlıyor. Alpamayo Developer Hub'daki dağıtım tarifleri, TensorRT ve DFlash2 ile çıkarım optimizasyonunu mümkün kılarak DRIVE AGX Thor üzerinde 160–190 ms piksel-yörünge gecikmesine ulaşıyor.
Geliştiriciler için üç iş akışı öne çıkıyor: PhysicalAI-AV örneklerinde AlpaJudge çalıştırmak, daha değerli eğitim örneklerini seçmek ve akıl yürütme skorlarını son eğitimde ödül olarak kullanmak. Model ve AlpaJudge Hugging Face üzerinden erişilebilir.
Çok Vektörlü Gömme Modelleri İçin Havuzlamaya Duyarlı Eğitim
Belirteç havuzlamaya duyarlı eğitim, aynı depolama bütçesinde ColBERT tarzı erişim kalitesini artırıyor.
ColBERT gibi çok vektörlü gömme modelleri, her sorgu belirtecine belgede kendi eşleşmesini bulma fırsatı veriyor; bu ifade gücü sağlarken milyonlarca belgelik bir derlemde yüz milyonlarca vektör demek olabiliyor. Belirteç havuzlama (token pooling), benzer belirteç vektörlerini birleştirerek bu temsilleri küçültüyor, ancak sıkıştırma arttıkça yararlı bilgi kaybolma riski de büyüyor.
Hugging Face'ten Tom Aarsen, havuzlamaya duyarlı eğitimin kodlayıcıya vektörler birleştirildiğinde önemli bilgiyi korumayı öğrettiğini gösteriyor. Sentence Transformers ile yazılan kısa ve tekrarlanabilir örnek, bir kayıp sarmalayıcısı (loss wrapper) kullanıyor. pool_factor=4 ile normal eğitilmiş model, belge vektörlerinde 4 kat azalmaya rağmen havuzlamasız NanoBEIR nDCG@10 değerinin %94,6'sını koruyor. Havuzlamaya duyarlı eğitim ise aynı depolama bütçesinde bu oranı %97,8'e çıkarıyor.
Yazı, yöntemi Stefan Josef'in Learn to Pool çalışması ile LightOn'un havuzlama düzenlileştirme araştırmasına dayandırıyor. Havuzlama bütçesi seçimi, uyarlanabilir havuzlama kalibrasyonu, isteğe bağlı çekirdek hızlandırma ve diğer sıkıştırma tekniklerinin birlikte kullanımı da ele alınıyor. Kod ve modeller paylaşılıyor.
Bu sonuçlar, geniş ölçekli arama sistemleri kuran ekipler için önemli. Depolama ve bellek maliyetini dört kat düşürürken kaliteyi neredeyse korumak, çok vektörlü getirmeyi (retrieval) üretim ortamlarında çok daha uygulanabilir kılıyor ve sıkıştırmayı sonradan eklenen bir hile olmaktan çıkarıp eğitimin doğal bir parçası haline getiriyor.
Ajan Tabanlı Robotik, Veri Ölçekleme Sorununa Çare Olabilir mi?
IEEE Spectrum, ajan tabanlı yaklaşımın robotikteki veri darboğazını aşıp aşamayacağını inceliyor.
IEEE Spectrum'un robotik haberi, ajan tabanlı yaklaşımın robotiğin veri ölçekleme sorununu çözüp çözemeyeceğini tartışıyor. Haber, robotik şirketlerinin hâlihazırda bu alana yatırım yaptığını belirtiyor; Figure AI ve Sunday gibi şirketlerin duyurularına yer veriyor.
Sağlanan içerik yalnızca özet ve sayfa gezinti öğelerinden oluştuğu için makalenin teknik argümanları, örnek sistemleri ve uzman görüşleri bu özette yer almıyor. Yine de başlıktan ve girişten anlaşıldığı kadarıyla, robotikte yaygın olan sorun şu: büyük dil modellerinin aksine robotlar için fiziksel dünyada toplanan eğitim verisi pahalı ve sınırlı. Ajan tabanlı yaklaşım, robotun kendi başına plan yapıp araç kullanarak görev çözmesini hedefleyerek bu veri bağımlılığını azaltma vaadi taşıyor.
Bu vaat önemli, çünkü robotikte ilerlemenin önündeki en büyük engellerden biri veri darboğazı. Eğer robotlar gördükleri her görev için binlerce saatlik gösterime ihtiyaç duymadan plan yapıp mevcut araçları devreye sokabilirse, fiziksel yapay zekânın yaygınlaşma hızı belirgin biçimde artabilir. Ancak bu yaklaşımın gerçek dünyadaki başarısı henüz kanıtlanmış değil; ayrıntılar için kaynak makalenin tamamı okunmalı.
Tensegrity Robotlar Görevlere Göre Şekil Değiştirip İş Birliği Yapıyor
Esnek tensegrity modüller, yer değiştirme ve manipülasyonu tek ünitede birleştirip birlikte nesne taşıyor.
Nature Machine Intelligence'ta yayımlanan çalışmada Saikot ve arkadaşları, tensegrity tabanlı esnek bir gövdeyi pençe tabanlı bağlantı mekanizmalarıyla birleştiren modüler ve yeniden yapılandırılabilir bir robot sundu. Mevcut modüler robotların çoğu sert modüllere dayandığı için yapısal esneklikten yoksun; sürekli (continuum) robotlar ise esnek omurgalarıyla uyum sağlasa da çoklu robot konfigürasyonlarına kendi kendine dönüşemiyor. Yeni tasarım bu iki mimarinin avantajlarını tek yapıda topluyor.
Her robot tek başına hem manipülasyon hem yer değiştirme yapabiliyor. Birden fazla robot kendini zincir, halka veya dallanma gibi farklı morfolojilere dönüştürerek ortak manipülasyon ve hareket görevleri üstlenebiliyor. Ekip, robotların koordineli nesne taşıma, çok kipli hareket ve gerçek dünya senaryolarında birleşik yer değiştirme-manipülasyon becerilerini gösterdi; örneğin nesne taşıma, boşlukları geçme ve zorlu arazide gezinme.
Yazarlara göre bu sonuçlar, üretim, uzay keşfi ve arama-kurtarma gibi alanlarda uyarlanabilir ve çok işlevli robot kolektifleri için bir temel oluşturuyor. Sert modüllerin kısıtlarını esnek yapıyla aşan bu yaklaşım, tek bir donanımın hem tekil hem kolektif görevlerde kullanılabilmesini mümkün kılıyor; özellikle önceden bilinmeyen ve değişken ortamlarda çalışacak robotlar için umut verici bir yön çiziyor.
İsteğe Bağlı Hassasiyet: Belirsiz Adımlarda Ağırlık Bitlerini Artırmak
8-bit ağırlıkların üst 4 biti ile kod çözme yapılıp yalnızca belirsiz adımlarda tam hassasiyete geçiliyor.
Yerel kod çözme genellikle tüm üretim boyunca tek bir ağırlık hassasiyeti kullanıyor. Bu çalışma farklı bir tahsis öneriyor: 8-bit ağırlıklar saklanıyor, ancak çıktı dağılımı belirsiz göründüğünde (entropi eşiğin üzerinde veya en yüksek iki olasılık arasındaki marj küçükken) adım yalnızca o zaman 8 bitle yeniden yapılıyor; diğer adımlar üst 4 bitle kod çözülüyor. Nicemleme simüle edildi, model Qwen3-0.6B, kıyaslama GSM8K ve maliyet token başına okunan ağırlık baytı olarak sayıldı.
36.724 yeniden oynatılan adımda düşük hassasiyetli geçişin entropisi, argmax değişimlerini 0,93 AUC ile sıralıyor. %15 yükseltme bütçesinde entropi geçidi değişimlerin %78'ini, marj geçidi ise %94'ünü yakalıyor; aynı oranda rastgele seçim yapan bir geçidin beklenen değeri %15 (çalıştırılmış değil, hesaplanmış bir beklenti). 150 canlı problemde tümü yüksek hassasiyet %64,0, tümü düşük %55,3 skor aldı (McNemar p=0,053). %16 yükseltme oranlı entropi geçidi, tam yüksek hassasiyetin 0,87'si kadar ağırlık baytıyla %62,7 puan alıyor. Ancak eşleştirilmiş farklar güven aralıklarıyla birlikte (tümü yükseğe göre −1,3; tümü düşüğe göre +7,3 puan) canlı verilerde geçidin iki uç yapılandırmadan ayırt edilemediğini gösteriyor.
Doğrulanmış spekülatif kod çözme aynı maliyet modelinde benzer baytlarda sıfır KL sağlıyor. Canlı rastgele kontrol, düşünme modu kuralı, ikinci bir model ve canlı KL ölçümü yapılmadı.